OTUZ YAPAY ZEKÂ, TEK HATA
Makalenin 1907’de Galton’a dayandırdığı bir fikir olan kalabalıkların bilgeliği şunu söyler: birçok bağımsız tahminin ortalamasını alın, hatalar birbirini götürür. Hatalar yansız ve bağımsızsa ortalamanın hatası, tahmin sayısının karekökünün tersi gibi küçülür. Birkaç yapay zekâ dil modelini birleştiren pek çok sistem — örnekleme ve oylamayla, tartışmayla ya da farklı modellerden oluşan kurullarla — bu argümana yaslanır: daha büyük bir takım, daha iyi bir ajanın yerini tutabilir.
Ljubljana’daki Jožef Stefan Enstitüsü’nden Carolina Fortuna ve Blaž Bertalanič, argümanın ancak öncülleri kadar sağlam olduğuna dikkat çekiyor ve bu öncülleri sınamaya koyuluyor.
Deney düzeneği olarak Fermi soruları
Fermi soruları, bir kaba kaç nesne sığacağı gibi yalnızca tahmin edilebilen nicelikleri sorar. Yanıtları pek çok büyüklük mertebesine yayılan sayılardır; bu yüzden bir hata büyüklük mertebesi cinsinden ölçülebilir — on katlık bir fark bir mertebe sayılır — ve zıt işaretli hatalar gerçekten birbirini götürebilir.
Ekip, 3 ila 72 milyar parametreli 15 açık ağırlıklı modelden (open-weight models), realFP kıyaslama setinin 529 sorusuna verilen 2,51 milyon yanıt topladı ve sonuçları iki başka soru setinde doğruladı. Her model her soruyu yaklaşık 350 kez yanıtladı; 2 ile 30 arası yanıttan oluşan takımların ortalaması logaritmik ölçekte alındı.
Tek başlarına modeller bu oyunda zayıf. Tek bir yanıt, soruların %12 ile %34’ünde doğru büyüklük mertebesini buluyor; %30 ile %63’ünde ise yüz kattan daha fazla sapıyor.
Her kopyanın paylaştığı hata
Kilit adım, her yanıtın hatasını iki parçaya ayırmak. Biri, bir modelin belirli bir soruda yaptığı ve o soruya verdiği bütün yanıtların paylaştığı hata. Öteki, bir yanıttan ötekine değişen rastgele kısım. Yanıtların ortalaması alındığında yalnızca ikincisi birbirini götürebilir.
Görünen o ki birinci kısım baskın. realFP’de hata varyansının medyan olarak 0,906’sını oluşturuyor. Soru sabitlendiğinde aynı takımdan iki yanıt, bağımsız örneklemenin gerektirdiği gibi ilişkisiz; ama aynı hatayı paylaşıyorlar.
Makale bunu, Kish’in tasarım etkisi (design effect) olarak bilinen klasik bir formülle tek bir sayıya dönüştürüyor: N yanıtlık bir takımdaki etkin bağımsız yanıt sayısı N / (1 + (N − 1)ρ) olur; burada ρ, o paylaşılan paydır. ρ = 0,906 ile otuz yanıtlık bir takım 1,10 bağımsız ajan değerinde.
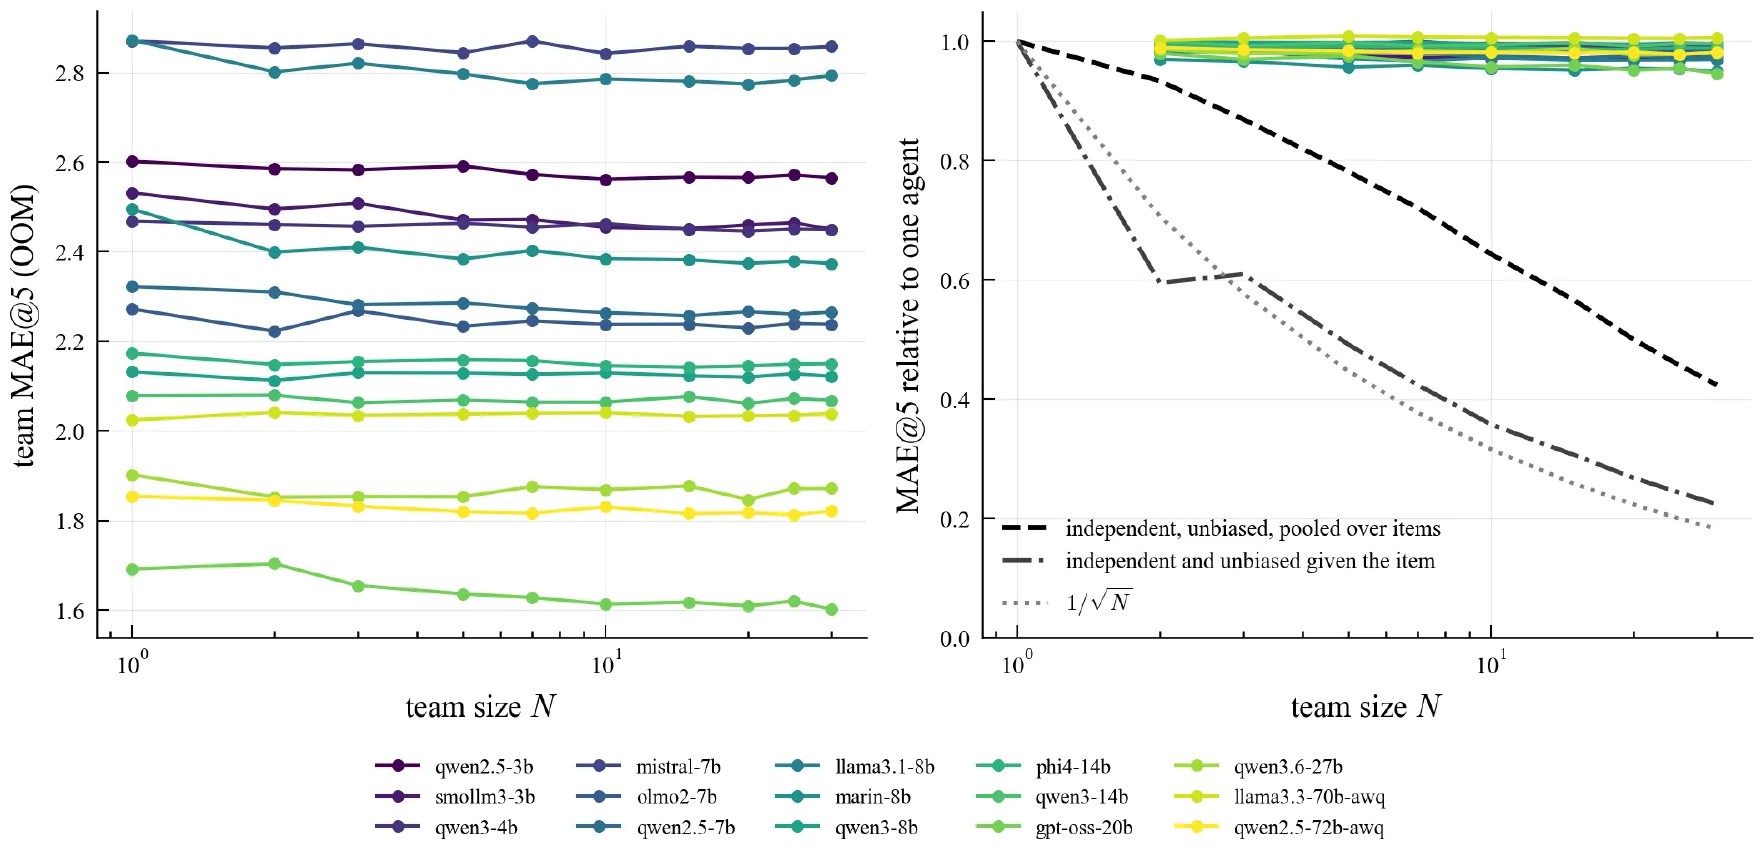
Solda: 15 model için takım boyutu N’ye karşı takım hatası. Sağda: aynı hata tek bir ajana göre (renkli çizgiler, 1 civarında); bağımsız ve yansız yanıtların vereceği sonuçla (siyah kesikli ve kesik-noktalı çizgiler) ve 1/√N hızıyla (noktalı) karşılaştırmalı. — Şekil 2, Fortuna ve Bertalanič (2026), arXiv:2611.16315.
Uygulamada otuz yanıtlık takımlar tek bir ajanın hatasını medyan olarak %1,7, en fazla %5,4 azalttı. Her soruda ayrıca hiçbir ortak hata taşımayan bağımsız yanıtlar hatayı %74 ile %79 oranında azaltırdı.
Her şey bir milyona doğru kayıyor
Paylaşılan hatanın bir kısmı tanınabilir bir biçime sahip. Her model küçük nicelikleri olduğundan fazla, büyükleri olduğundan az tahmin ediyor ve tahminlerini yaklaşık bir milyona (10⁶) doğru sıkıştırıyor. Bu eğilim 15 modelin hepsinde görülüyor, ama paylaşılan hatanın medyan olarak yalnızca %17’sini açıklıyor. Modeller ayrıca aynı sorularda aynı yönde yanılıyor: uç durumlar dizginlendiğinde ve bir milyona doğru kayma çıkarıldığında, iki farklı modelin soru başına hataları arasındaki korelasyon hâlâ 0,60 ile 0,69 arasında.
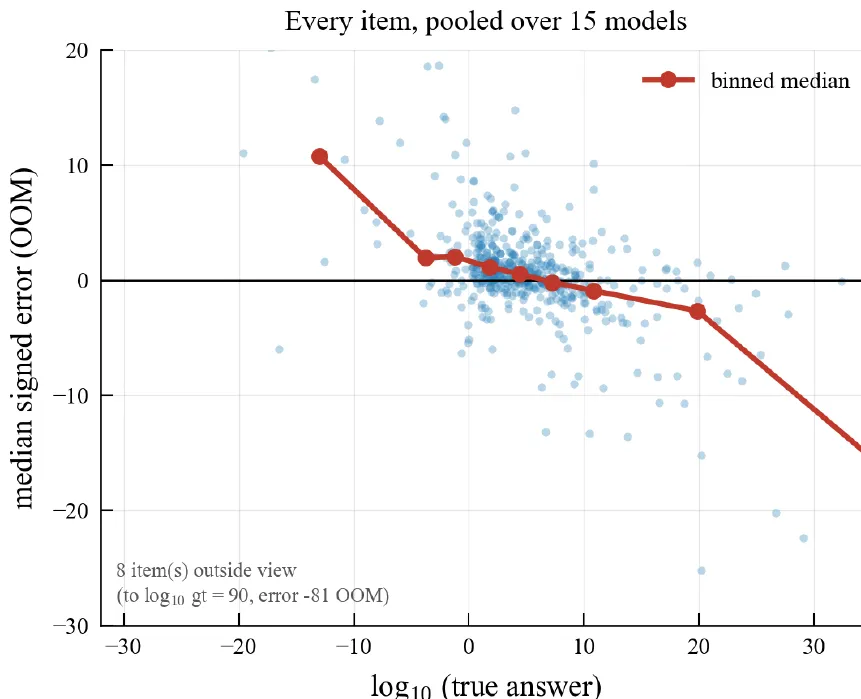
15 modelin her sorudaki medyan hatası, doğru yanıta (on’un kuvvetleri) karşı: küçük nicelikler olduğundan fazla, büyükler olduğundan az tahmin ediliyor. — Şekil 1 (solda), Fortuna ve Bertalanič (2026), arXiv:2611.16315.
Tartışmak işe yaramıyor
Ajanlar aralarında tartışırsa ne olur? Üç tartışma turunda her ajan takım arkadaşlarının yanıtlarını gördü ve kendi yanıtını gözden geçirdi. Beş ajanlık takımlardaki dağılım %93 oranında çöktü — üçüncü turda, 15 modelin 12’sinde, soruların en az yarısında beş ajandan üçü aynı sayıyı verdi. Ama paylaşılan hata yerinden kıpırdamadı ve toplam kazanç, on beş kat hesaplama maliyetine karşılık %2,1 oldu. Akranlarını görmeden yalnızca kendi yanıtını gözden geçiren ajanlar en az o kadar iyi sonuç verdi.
Biraz işe yarayanlar
Örnekleme sıcaklığını (sampling temperature) yükseltmek yanıtları çeşitlendirdi ama takımları yaklaşık %1’den fazla iyileştirmedi. Farklı modelleri karıştırmak daha çok işe yaradı: benzer doğruluktaki beş model birlikte, kendi takımlarındakinden %6,6 daha iyi sonuç verdi. Yine de 15 modelin hiçbir karışımı, en doğru tek model olan gpt-oss-20b’den kurulan bir takımı anlamlı biçimde geçemedi. Yanıtları bilinen sorularda öğrenilen bir düzeltme, modellerin genel yanlılığını giderdi ama soru soru yapılan hatayı gidermedi.
Yazarlar sınırların altını çiziyor: “düşünme” modları olmadan çalıştırılan orta boyutlu açık modeller, bu kıyaslama setleri ve istemler; öncü (frontier) modeller ve akıl yürütme modelleri sınanmadı. Vardıkları sonuç bir tasarım dersi. Daha fazla ajan ya da daha fazla görüş ayrılığı eklemek, bir modelin her kopyasının paylaştığı bir hatayı düzeltmez. Yazarlar bu paylaşılan hataya doğrudan saldırmayı öneriyor; örneğin ajanlara her soruya özgü bilgiler vererek — henüz sınamadıkları bir yol.