TIGA PULUH AI, SATU KESALAHAN
Kearifan kerumunan (wisdom of crowds), gagasan yang oleh makalah ini ditelusuri balik hingga Galton pada 1907, mengatakan: rata-ratakan banyak tebakan independen, dan kesalahan-kesalahannya saling meniadakan. Jika kesalahan itu tidak bias dan independen, kesalahan rata-ratanya menyusut seperti satu per akar kuadrat dari jumlah tebakan. Banyak sistem yang menggabungkan beberapa model bahasa AI — dengan pengambilan sampel dan pemungutan suara, dengan debat, atau dengan komite berisi model-model yang berbeda — bersandar pada argumen ini: tim yang lebih besar dapat menggantikan agen yang lebih baik.
Carolina Fortuna dan Blaž Bertalanič, di Jožef Stefan Institute di Ljubljana, menunjukkan bahwa argumen itu hanya sebaik premis-premisnya, lalu berupaya mengujinya.
Pertanyaan Fermi sebagai bangku uji
Pertanyaan Fermi menanyakan besaran yang hanya dapat diperkirakan, misalnya berapa banyak benda yang muat di dalam sebuah wadah. Jawabannya berupa angka yang membentang hingga banyak orde besaran, sehingga kesalahan dapat diukur dalam orde besaran — selisih sepuluh kali lipat dihitung sebagai satu — dan kesalahan yang berlawanan tanda benar-benar dapat saling meniadakan.
Tim itu mengumpulkan 2,51 juta jawaban dari 15 model berbobot terbuka (open-weight), berukuran 3 hingga 72 miliar parameter, atas 529 pertanyaan dari tolok ukur realFP, dan memeriksa hasilnya pada dua kumpulan pertanyaan lain. Setiap model menjawab setiap pertanyaan sekitar 350 kali, dan tim berisi 2 hingga 30 jawaban dirata-ratakan pada skala logaritmik.
Seorang diri, model-model itu buruk dalam permainan ini. Satu jawaban memiliki orde besaran yang benar pada 12 hingga 34% pertanyaan, dan meleset lebih dari seratus kali lipat pada 30 hingga 63%.
Kesalahan yang dimiliki setiap salinan
Langkah kuncinya adalah membagi kesalahan setiap jawaban menjadi dua bagian. Yang pertama adalah kesalahan yang dibuat sebuah model pada pertanyaan tertentu, yang dimiliki bersama oleh semua jawabannya atas pertanyaan itu. Yang lain adalah bagian acak yang berubah-ubah dari satu jawaban ke jawaban berikutnya. Hanya bagian kedua yang dapat saling meniadakan ketika jawaban-jawaban dirata-ratakan.
Ternyata bagian pertama yang dominan. Pada realFP, bagian itu menyumbang median 0,906 dari varians kesalahan. Untuk pertanyaan yang sama, dua jawaban dari tim yang sama tidak berkorelasi, sebagaimana tersirat oleh pengambilan sampel yang independen; tetapi keduanya memiliki kesalahan yang sama.
Makalah ini meringkasnya menjadi satu angka, dengan rumus klasik yang dikenal sebagai efek desain Kish (design effect): jumlah efektif jawaban independen dalam tim berisi N adalah N / (1 + (N − 1)ρ), dengan ρ adalah porsi bersama tersebut. Dengan ρ = 0,906, tim berisi tiga puluh setara dengan 1,10 agen independen.
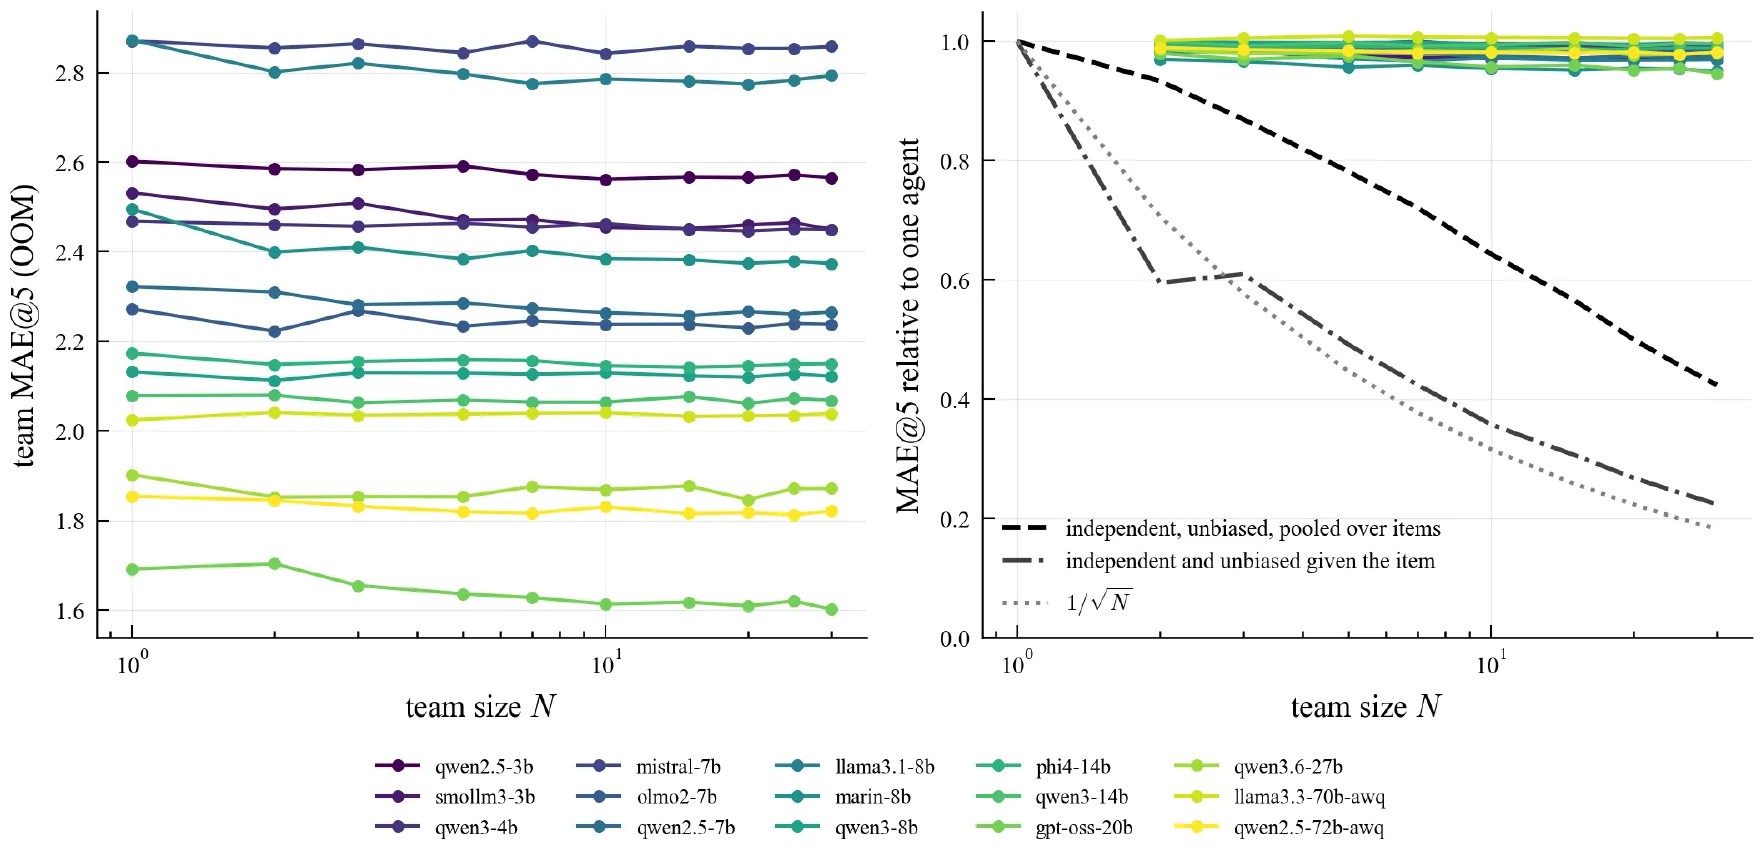
Kiri: kesalahan tim terhadap ukuran tim N untuk 15 model. Kanan: hal yang sama relatif terhadap satu agen (garis berwarna, di dekat 1), dibandingkan dengan yang akan dihasilkan oleh jawaban independen dan tidak bias (garis hitam putus-putus dan titik-garis) serta laju 1/√N (garis titik-titik). — Gambar 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
Dalam praktiknya, tim berisi tiga puluh mengurangi kesalahan satu agen sebesar median 1,7%, dan paling banyak 5,4%. Jawaban independen yang juga tidak membawa kesalahan bersama pada setiap pertanyaan akan memangkasnya sebesar 74 hingga 79%.
Semuanya bergeser menuju sejuta
Sebagian dari kesalahan bersama itu memiliki bentuk yang dapat dikenali. Setiap model menaksir terlalu tinggi besaran yang kecil dan menaksir terlalu rendah besaran yang besar, sehingga memampatkan perkiraannya ke arah sekitar sejuta (10⁶). Kecenderungan ini muncul pada ke-15 model, tetapi hanya menjelaskan median 17% dari kesalahan bersama. Model-model itu juga keliru pada pertanyaan yang sama dengan arah yang sama: kesalahan per pertanyaan dari dua model yang berbeda masih berkorelasi sebesar 0,60 hingga 0,69 setelah kasus-kasus ekstrem dijinakkan dan pergeseran menuju sejuta dihilangkan.
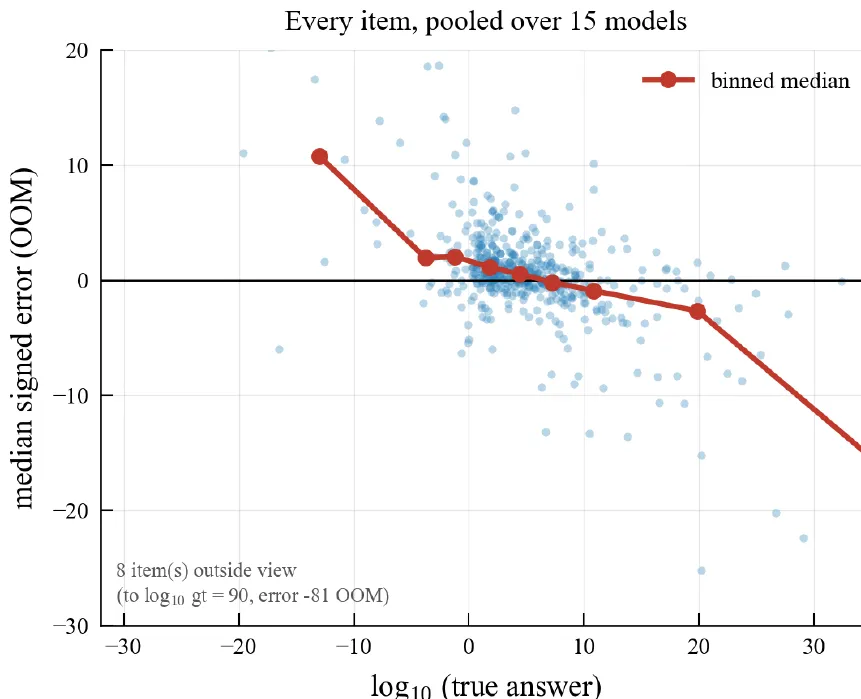
Kesalahan median ke-15 model pada setiap pertanyaan, terhadap jawaban sebenarnya (pangkat sepuluh): besaran kecil ditaksir terlalu tinggi, besaran besar ditaksir terlalu rendah. — Gambar 1 (kiri), Fortuna & Bertalanič (2026), arXiv:2611.16315.
Berembuk tidak membantu
Bagaimana jika para agen berdiskusi? Dalam tiga putaran debat, setiap agen melihat jawaban rekan-rekan setimnya lalu merevisi jawabannya. Sebaran di dalam tim berisi lima agen anjlok sebesar 93% — pada putaran ketiga, untuk 12 dari 15 model, tiga dari lima agen memberikan angka yang sama pada setidaknya separuh pertanyaan. Namun kesalahan bersama itu tidak bergeser, dan perolehan totalnya 2,1%, dengan biaya komputasi lima belas kali lipat. Agen yang sekadar merevisi jawabannya sendiri, tanpa melihat rekan-rekannya, setidaknya sama baiknya.
Yang sedikit membantu
Menaikkan suhu pengambilan sampel (sampling temperature) membuat jawaban lebih beragam tanpa memperbaiki tim lebih dari sekitar 1%. Mencampur model-model yang berbeda lebih membantu: lima model dengan akurasi serupa bekerja 6,6% lebih baik bersama-sama daripada dalam tim mereka masing-masing. Namun tidak ada campuran dari ke-15 model yang secara signifikan mengungguli tim yang dibangun dari satu model yang paling akurat, gpt-oss-20b. Koreksi yang dipelajari dari pertanyaan-pertanyaan yang jawabannya diketahui menghilangkan bias keseluruhan model-model itu, tetapi tidak menghilangkan kesalahan pertanyaan demi pertanyaan.
Para penulis menekankan batasannya: model terbuka berukuran sedang, tanpa mode “berpikir” (thinking) mereka, pada tolok ukur dan prompt ini; model-model terdepan (frontier) dan model penalaran tidak diuji. Kesimpulan mereka adalah sebuah pelajaran desain. Menambah lebih banyak agen, atau lebih banyak ketidaksepakatan, tidak memperbaiki kesalahan yang dimiliki bersama oleh setiap salinan sebuah model. Para penulis menyarankan untuk menyerang kesalahan bersama itu secara langsung, misalnya dengan memberi agen informasi yang spesifik untuk setiap pertanyaan — sebuah jalan yang belum mereka uji.