BA MƯƠI AI, MỘT SAI LẦM
Trí tuệ đám đông, một ý tưởng mà bài báo truy nguyên về Galton năm 1907, nói rằng: hãy lấy trung bình nhiều phỏng đoán độc lập, và các sai số sẽ triệt tiêu nhau. Nếu sai số không thiên lệch và độc lập, sai số của giá trị trung bình giảm theo một chia căn bậc hai của số phỏng đoán. Nhiều hệ thống kết hợp nhiều mô hình ngôn ngữ AI — bằng cách lấy mẫu và bỏ phiếu, bằng tranh luận, hoặc bằng hội đồng các mô hình khác nhau — dựa vào lập luận này: một đội lớn hơn có thể thay thế cho một tác tử giỏi hơn.
Carolina Fortuna và Blaž Bertalanič, tại Viện Jožef Stefan ở Ljubljana, chỉ ra rằng lập luận này chỉ đứng vững khi các tiền đề của nó đứng vững, và đã bắt tay kiểm tra chúng.
Câu hỏi Fermi làm bàn thử nghiệm
Câu hỏi Fermi hỏi về những đại lượng chỉ có thể ước lượng, chẳng hạn bao nhiêu đồ vật vừa trong một thùng chứa. Câu trả lời của chúng là những con số trải dài nhiều bậc độ lớn, nên sai số có thể đo bằng bậc độ lớn — sai lệch gấp mười tính là một — và các sai số trái dấu có thể thực sự triệt tiêu nhau.
Nhóm đã thu thập 2,51 triệu câu trả lời từ 15 mô hình trọng số mở (open-weight models), từ 3 đến 72 tỷ tham số, cho 529 câu hỏi của bộ đánh giá realFP, và kiểm tra kết quả trên hai bộ câu hỏi khác. Mỗi mô hình trả lời mỗi câu hỏi khoảng 350 lần, và các đội gồm 2 đến 30 câu trả lời được lấy trung bình trên thang logarit.
Tự thân, các mô hình chơi trò này rất kém. Một câu trả lời đơn lẻ đúng bậc độ lớn ở 12 đến 34% số câu hỏi, và lệch hơn một trăm lần ở 30 đến 63%.
Sai số mà mọi bản sao cùng chia sẻ
Bước then chốt là tách sai số của mỗi câu trả lời thành hai phần. Một phần là sai lầm mà mô hình mắc phải trên một câu hỏi cụ thể, được mọi câu trả lời của nó cho câu hỏi đó chia sẻ. Phần kia là phần ngẫu nhiên thay đổi từ câu trả lời này sang câu trả lời khác. Chỉ phần thứ hai mới có thể triệt tiêu khi lấy trung bình các câu trả lời.
Hóa ra phần thứ nhất chiếm ưu thế. Trên realFP, nó chiếm trung vị 0,906 phương sai của sai số. Khi đã biết câu hỏi, hai câu trả lời từ cùng một đội không tương quan với nhau, đúng như việc lấy mẫu độc lập hàm ý; nhưng chúng chia sẻ cùng một sai lầm.
Bài báo biến điều này thành một con số duy nhất, bằng một công thức kinh điển gọi là hiệu ứng thiết kế của Kish (design effect): số câu trả lời độc lập hiệu dụng trong một đội gồm N câu trả lời là N / (1 + (N − 1)ρ), trong đó ρ là phần được chia sẻ đó. Với ρ = 0,906, một đội ba mươi chỉ có giá trị bằng 1,10 tác tử độc lập.
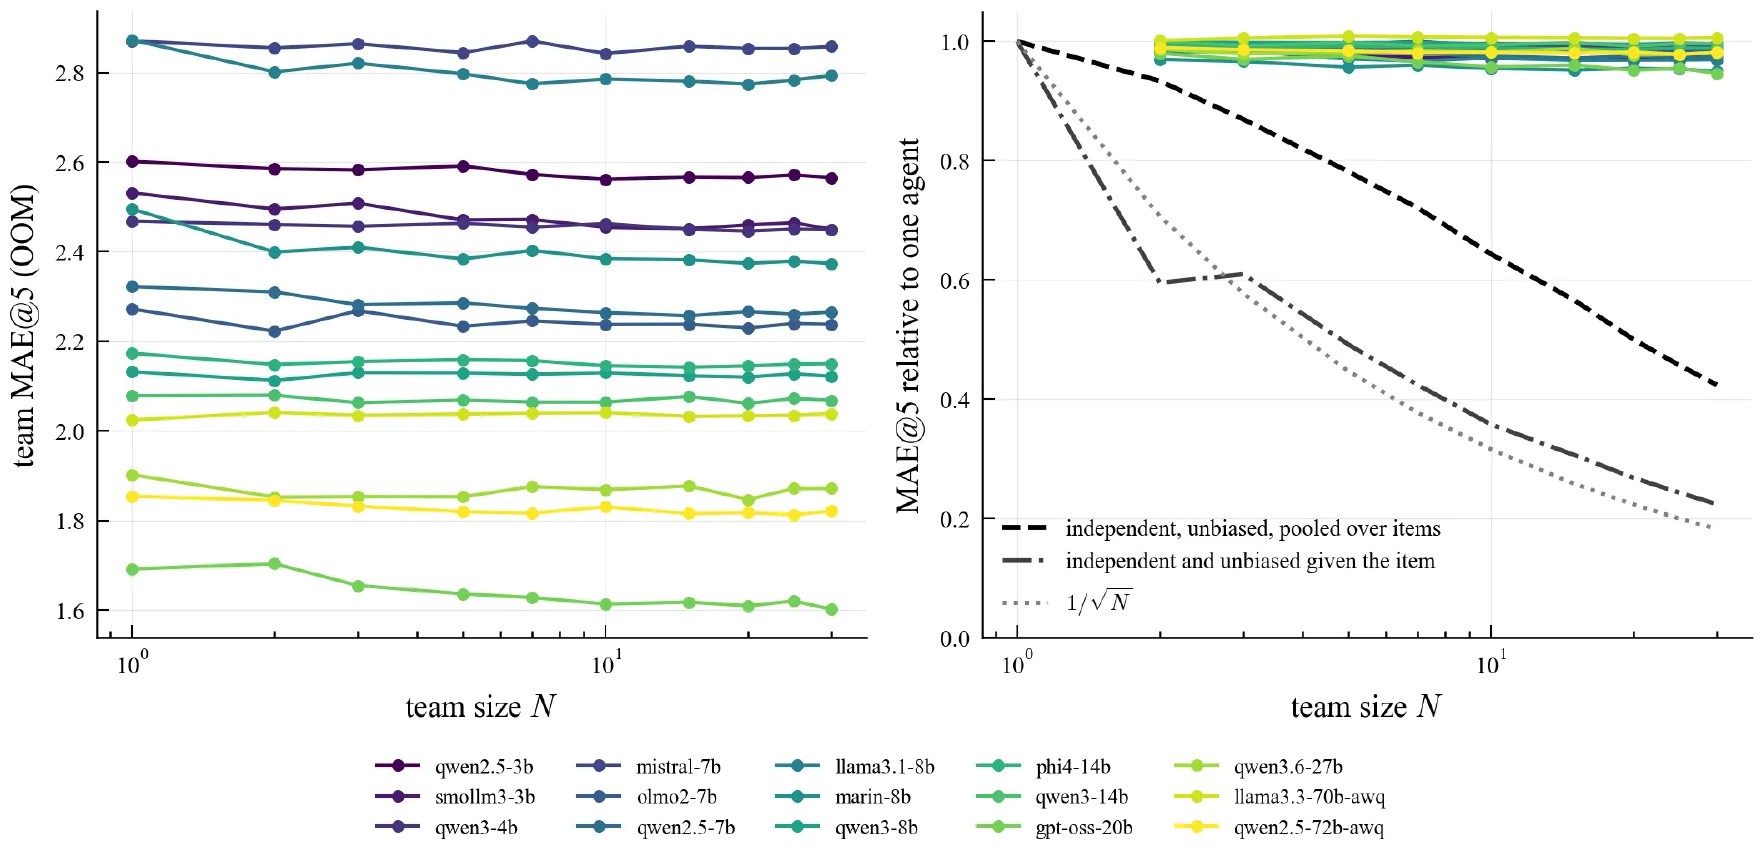
Trái: sai số của đội theo kích thước đội N với 15 mô hình. Phải: cùng đại lượng đó so với một tác tử đơn lẻ (các đường màu, gần 1), đối chiếu với kết quả mà các câu trả lời độc lập và không thiên lệch sẽ cho (các đường đen nét đứt và chấm gạch) và tốc độ 1/√N (đường chấm). — Hình 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
Trong thực tế, các đội ba mươi giảm sai số của một tác tử đơn lẻ với trung vị 1,7%, và nhiều nhất là 5,4%. Những câu trả lời độc lập đồng thời không mang sai lầm chung nào trên từng câu hỏi sẽ giảm nó 74 đến 79%.
Mọi thứ đều trôi về phía một triệu
Một phần của sai lầm chung có hình dạng dễ nhận ra. Mọi mô hình đều ước lượng quá cao các đại lượng nhỏ và quá thấp các đại lượng lớn, nén các ước lượng của chúng về phía khoảng một triệu (10⁶). Xu hướng này xuất hiện ở cả 15 mô hình, nhưng nó chỉ giải thích trung vị 17% của sai số chung. Các mô hình cũng sai trên cùng những câu hỏi theo cùng một hướng: sai số theo từng câu hỏi của hai mô hình khác nhau vẫn tương quan ở mức 0,60 đến 0,69 khi các trường hợp cực đoan đã được kiềm chế và xu hướng trôi về phía một triệu đã được loại bỏ.
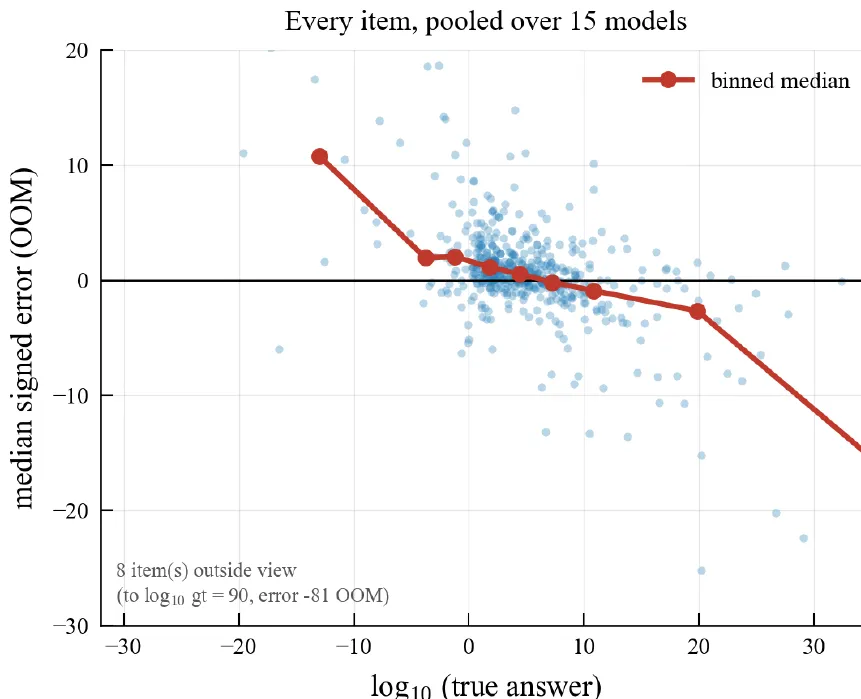
Sai số trung vị của 15 mô hình trên mỗi câu hỏi, theo câu trả lời đúng (lũy thừa của mười): đại lượng nhỏ bị ước lượng quá cao, đại lượng lớn bị ước lượng quá thấp. — Hình 1 (trái), Fortuna & Bertalanič (2026), arXiv:2611.16315.
Bàn bạc cũng không giúp gì
Nếu các tác tử thảo luận thì sao? Trong ba vòng tranh luận, mỗi tác tử xem câu trả lời của đồng đội và sửa lại. Độ phân tán trong các đội năm thành viên sụt giảm 93% — đến vòng thứ ba, với 12 trong 15 mô hình, ba trong năm tác tử đưa ra cùng một con số ở ít nhất một nửa số câu hỏi. Nhưng sai lầm chung không hề dịch chuyển, và tổng mức cải thiện là 2,1%, với chi phí tính toán gấp mười lăm lần. Những tác tử chỉ đơn giản tự sửa câu trả lời của mình, không xem câu trả lời của đồng đội, làm tốt ít nhất là ngang bằng.
Điều gì giúp được chút ít
Tăng nhiệt độ lấy mẫu khiến câu trả lời đa dạng hơn mà không cải thiện các đội quá khoảng 1%. Trộn các mô hình khác nhau giúp ích nhiều hơn: năm mô hình có độ chính xác tương đương làm tốt hơn 6,6% khi kết hợp so với trong đội riêng của từng mô hình. Tuy vậy, không tổ hợp nào của 15 mô hình cải thiện đáng kể so với một đội xây dựng từ chỉ một mô hình chính xác nhất, gpt-oss-20b. Một phép hiệu chỉnh học được trên các câu hỏi đã biết đáp án đã loại bỏ thiên lệch tổng thể của các mô hình, nhưng không loại bỏ được sai lầm theo từng câu hỏi.
Các tác giả nhấn mạnh các giới hạn: những mô hình mở có kích thước khiêm tốn, không dùng chế độ “suy nghĩ” của chúng, trên các bộ đánh giá và câu lệnh này; các mô hình tiên phong và mô hình suy luận chưa được thử nghiệm. Kết luận của họ là một bài học thiết kế. Thêm nhiều tác tử, hay thêm nhiều bất đồng, không sửa được một sai lầm mà mọi bản sao của một mô hình cùng chia sẻ. Các tác giả đề xuất tấn công trực tiếp vào sai số chung đó, chẳng hạn bằng cách cung cấp cho các tác tử thông tin riêng cho từng câu hỏi — một hướng đi mà họ chưa thử nghiệm.