ত্রিশটি AI, একটিই ভুল
ভিড়ের প্রজ্ঞা, যে ধারণাকে গবেষণাপত্রটি 1907 সালের গ্যালটন পর্যন্ত নিয়ে যায়, বলে: অনেক স্বাধীন অনুমানের গড় নিন, ভুলগুলো কাটাকাটি হয়ে যাবে। ভুলগুলো যদি পক্ষপাতহীন ও স্বাধীন হয়, তবে গড়ের ত্রুটি অনুমানের সংখ্যার বর্গমূলের বিপরীত অনুপাতে কমে। যেসব ব্যবস্থা একাধিক AI ভাষা-মডেলকে মেলায় — নমুনা নিয়ে ভোটের মাধ্যমে, বিতর্কের মাধ্যমে, বা ভিন্ন ভিন্ন মডেলের কমিটির মাধ্যমে — তাদের অনেকেই এই যুক্তির ওপর ভর করে: বড় একটি দল একটি ভালো এজেন্টের জায়গা নিতে পারে।
লিউব্লিয়ানার ইয়োঝেফ স্তেফান ইনস্টিটিউটের Carolina Fortuna ও Blaž Bertalanič দেখিয়েছেন, যুক্তিটি তার ভিত্তিগুলোর মতোই ভালো, আর সেগুলো যাচাই করতে নেমেছেন।
পরীক্ষার মঞ্চ হিসেবে ফার্মি প্রশ্ন
ফার্মি প্রশ্ন এমন পরিমাণ জানতে চায় যা কেবল অনুমানই করা যায়, যেমন একটি পাত্রে কতগুলো বস্তু আঁটে। এদের উত্তর এমন সংখ্যা যা বহু মাত্রাক্রম জুড়ে বিস্তৃত, তাই ত্রুটি মাপা যায় মাত্রাক্রমে (orders of magnitude) — দশ গুণের ফারাক একটি হিসেবে গণ্য — আর বিপরীত চিহ্নের ভুলগুলো সত্যিই কাটাকাটি হতে পারে।
দলটি 15টি উন্মুক্ত-ওজন মডেল (open-weight models) থেকে, যেগুলো 3 থেকে 72 বিলিয়ন প্যারামিটারের, realFP বেঞ্চমার্কের 529টি প্রশ্নে 2.51 মিলিয়ন উত্তর সংগ্রহ করেছে, এবং আরও দুই সেট প্রশ্নে ফলাফল যাচাই করেছে। প্রতিটি মডেল প্রতিটি প্রশ্নের উত্তর দিয়েছে প্রায় 350 বার, আর 2 থেকে 30টি উত্তরের দলগুলোর গড় নেওয়া হয়েছে লগারিদমিক স্কেলে।
একা একা মডেলগুলো এই খেলায় দুর্বল। একটি উত্তর 12 থেকে 34% প্রশ্নে সঠিক মাত্রাক্রমে থাকে, আর 30 থেকে 63% প্রশ্নে একশো গুণেরও বেশি ভুল করে।
যে ভুল প্রতিটি অনুলিপির মধ্যে ভাগ করা
মূল ধাপ হলো প্রতিটি উত্তরের ত্রুটিকে দুই ভাগে ভাগ করা। একটি হলো কোনো মডেল একটি নির্দিষ্ট প্রশ্নে যে ভুল করে, যা ওই প্রশ্নে তার সব উত্তরে ভাগ করা। অন্যটি এলোমেলো অংশ, যা এক উত্তর থেকে আরেক উত্তরে বদলায়। উত্তরগুলোর গড় নিলে কেবল দ্বিতীয়টিই কাটা যায়।
দেখা যায়, প্রথম অংশটিই প্রধান। realFP-এ এটি ত্রুটি-ভেদাঙ্কের মধ্যমা 0.906 অংশ। প্রশ্নটি নির্দিষ্ট হলে একই দলের দুটি উত্তর পরস্পর-সম্পর্কহীন, যেমনটি স্বাধীন নমুনায়ন বোঝায়; কিন্তু তারা একই ভুল ভাগ করে নেয়।
গবেষণাপত্রটি এটিকে একটি একক সংখ্যায় পরিণত করে কিশের নকশা-প্রভাব (design effect) নামে পরিচিত একটি ধ্রুপদি সূত্র দিয়ে: N সদস্যের দলে স্বাধীন উত্তরের কার্যকর সংখ্যা N / (1 + (N − 1)ρ), যেখানে ρ হলো ওই ভাগ করা অংশ। ρ = 0.906 হলে ত্রিশটি উত্তরের একটি দলের মূল্য 1.10টি স্বাধীন এজেন্টের সমান।
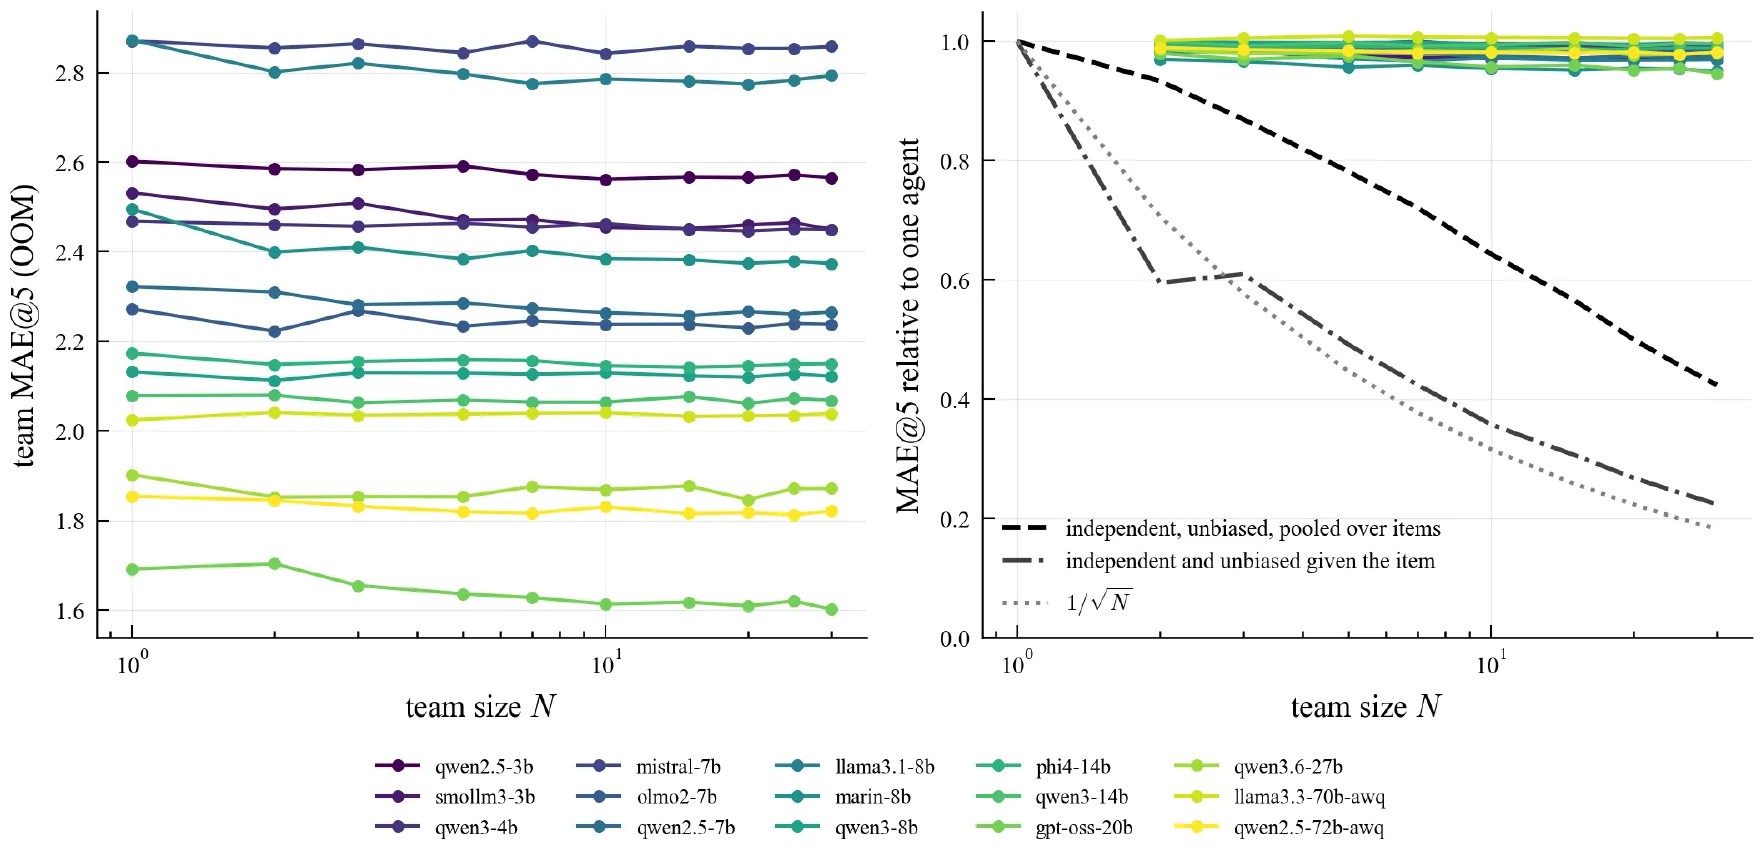
বাঁ: 15টি মডেলের জন্য দলের আকার N বনাম দলের ত্রুটি। ডান: একই জিনিস একটি একক এজেন্টের সাপেক্ষে (রঙিন রেখা, 1-এর কাছে), স্বাধীন ও পক্ষপাতহীন উত্তর যা দিত তার বিপরীতে (কালো ড্যাশ ও ড্যাশ-বিন্দু রেখা) এবং 1/√N হার (বিন্দুরেখা)। — চিত্র 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
বাস্তবে ত্রিশটি উত্তরের দলগুলো একক এজেন্টের ত্রুটি মধ্যমা হিসেবে কমিয়েছে মাত্র 1.7%, আর সর্বোচ্চ 5.4%। যেসব উত্তর স্বাধীন এবং প্রতিটি প্রশ্নে কোনো ভাগ করা ভুলও বহন করে না, সেগুলো ত্রুটি কমাত 74 থেকে 79%।
সবকিছু এক মিলিয়নের দিকে সরে যায়
ভাগ করা ভুলের একটি অংশের চেনা যায় এমন আকৃতি আছে। প্রতিটি মডেল ছোট পরিমাণকে বাড়িয়ে আর বড় পরিমাণকে কমিয়ে ধরে, তার অনুমানগুলোকে প্রায় এক মিলিয়নের (10⁶) দিকে সংকুচিত করে। এই প্রবণতা 15টি মডেলেই দেখা যায়, কিন্তু এটি ভাগ করা ত্রুটির কেবল মধ্যমা 17% ব্যাখ্যা করে। মডেলগুলো একই প্রশ্নে একই দিকেও ভুল করে: চরম ক্ষেত্রগুলো বশে আনার এবং এক মিলিয়নের দিকে সরে যাওয়ার প্রবণতা বাদ দেওয়ার পরও দুটি ভিন্ন মডেলের প্রশ্নভিত্তিক ত্রুটির সহসম্পর্ক 0.60 থেকে 0.69।
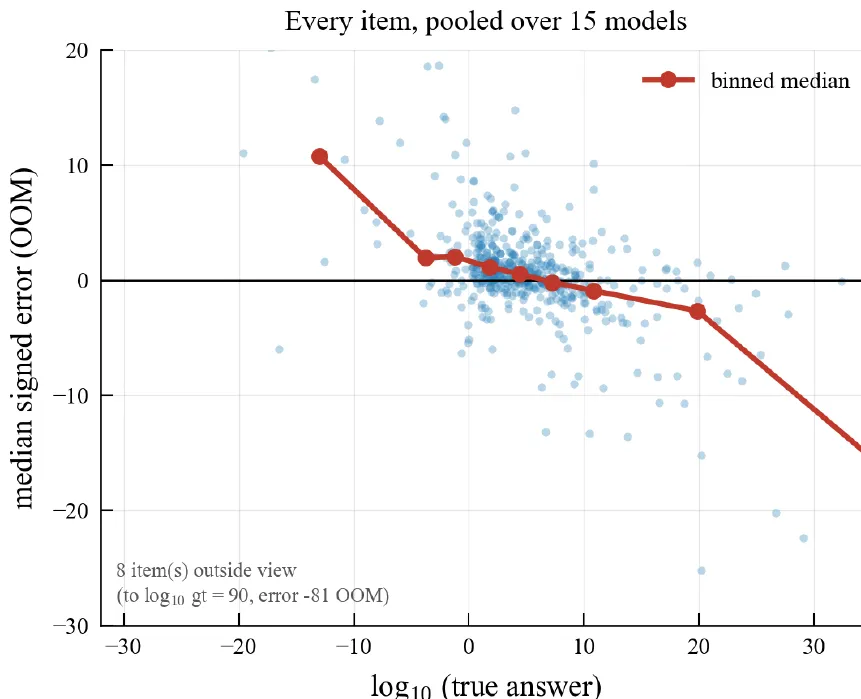
প্রতিটি প্রশ্নে 15টি মডেলের মধ্যমা ত্রুটি, সঠিক উত্তরের (দশের ঘাত) বিপরীতে: ছোট পরিমাণ বাড়িয়ে ধরা হয়, বড় পরিমাণ কমিয়ে। — চিত্র 1 (বাঁ), Fortuna & Bertalanič (2026), arXiv:2611.16315.
আলোচনা করে লাভ হয় না
এজেন্টরা যদি আলোচনা করে? তিন দফা বিতর্কে প্রতিটি এজেন্ট তার সতীর্থদের উত্তর দেখেছে এবং নিজেরটি সংশোধন করেছে। পাঁচ এজেন্টের দলগুলোর ভেতরের বিস্তার 93% কমে গেছে — তৃতীয় দফায়, 15টি মডেলের মধ্যে 12টির ক্ষেত্রে, অন্তত অর্ধেক প্রশ্নে পাঁচটির মধ্যে তিনটি এজেন্ট একই সংখ্যা দিয়েছে। কিন্তু ভাগ করা ভুল একচুলও নড়েনি, আর মোট লাভ ছিল 2.1%, পনেরো গুণ গণনা-খরচে। যেসব এজেন্ট সতীর্থদের না দেখে কেবল নিজের উত্তর সংশোধন করেছে, তারা অন্তত সমান ভালো করেছে।
যা সামান্য সাহায্য করেছে
নমুনায়ন-তাপমাত্রা বাড়ালে উত্তরগুলো আরও বৈচিত্র্যময় হয়েছে, কিন্তু দলগুলোর উন্নতি প্রায় 1%-এর বেশি হয়নি। ভিন্ন ভিন্ন মডেল মেশানো বেশি সাহায্য করেছে: কাছাকাছি নির্ভুলতার পাঁচটি মডেল একসঙ্গে নিজেদের দলের চেয়ে 6.6% ভালো করেছে। তবু 15টি মডেলের কোনো মিশ্রণই সবচেয়ে নির্ভুল একক মডেল gpt-oss-20b দিয়ে গড়া দলের চেয়ে উল্লেখযোগ্যভাবে ভালো করেনি। জানা উত্তরের প্রশ্নে শেখা একটি সংশোধন মডেলগুলোর সামগ্রিক পক্ষপাত দূর করেছে, কিন্তু প্রশ্ন-ধরে-ধরে ভুল নয়।
লেখকেরা সীমাবদ্ধতার ওপর জোর দেন: মাঝারি আকারের উন্মুক্ত মডেল, তাদের “চিন্তা” মোড ছাড়া, এই বেঞ্চমার্ক ও প্রম্পটে; অগ্রণী ও যুক্তিনির্ভর মডেল পরীক্ষা করা হয়নি। তাঁদের উপসংহার নকশার একটি শিক্ষা। আরও এজেন্ট, বা আরও মতভেদ, যোগ করলে সেই ভুল সারে না যা একটি মডেলের প্রতিটি অনুলিপির মধ্যে ভাগ করা। লেখকেরা সেই ভাগ করা ত্রুটিকে সরাসরি আক্রমণ করার পরামর্শ দেন, যেমন এজেন্টদের প্রতিটি প্রশ্নের নির্দিষ্ট তথ্য দিয়ে — এমন একটি পথ যা তাঁরা এখনও পরীক্ষা করেননি।