TRINTA IAs, UM ÚNICO ERRO
A sabedoria das multidões, uma ideia que o artigo remonta a Galton em 1907, diz: tire a média de muitos palpites independentes, e os erros se anulam. Se os erros forem sem viés e independentes, o erro da média diminui como um sobre a raiz quadrada do número de palpites. Muitos sistemas que combinam vários modelos de linguagem de IA — por amostragem e votação, por debate ou por comitês de modelos diferentes — se apoiam nesse argumento: uma equipe maior pode substituir um agente melhor.
Carolina Fortuna e Blaž Bertalanič, do Instituto Jožef Stefan, em Liubliana, lembram que o argumento só vale o que valem suas premissas, e decidiram testá-las.
Questões de Fermi como banco de testes
As questões de Fermi pedem quantidades que só podem ser estimadas, como quantos objetos cabem num recipiente. Suas respostas são números que se estendem por muitas ordens de grandeza; assim, um erro pode ser medido em ordens de grandeza — um fator dez conta como uma — e erros de sinais opostos podem realmente se anular.
A equipe reuniu 2,51 milhões de respostas de 15 modelos de pesos abertos (open-weight), de 3 a 72 bilhões de parâmetros, às 529 perguntas do benchmark realFP, e verificou os resultados em dois outros conjuntos de perguntas. Cada modelo respondeu a cada pergunta cerca de 350 vezes, e equipes de 2 a 30 respostas tiveram sua média calculada em escala logarítmica.
Sozinhos, os modelos são fracos nesse jogo. Uma única resposta acerta a ordem de grandeza em 12 a 34% das perguntas, e erra por mais de um fator cem em 30 a 63%.
O erro que todas as cópias compartilham
O passo-chave é dividir o erro de cada resposta em duas partes. Uma é o engano que um modelo comete numa pergunta específica, compartilhado por todas as suas respostas a ela. A outra é a parte aleatória, que varia de uma resposta para a seguinte. Só a segunda pode se anular quando as respostas são combinadas pela média.
Acontece que a primeira parte domina. No realFP, ela responde por uma mediana de 0,906 da variância do erro. Dada a pergunta, duas respostas da mesma equipe não são correlacionadas, como implica a amostragem independente; mas compartilham o mesmo engano.
O artigo transforma isso num único número, com uma fórmula clássica conhecida como efeito do plano amostral de Kish (design effect): o número efetivo de respostas independentes numa equipe de N é N / (1 + (N − 1)ρ), onde ρ é essa parte compartilhada. Com ρ = 0,906, uma equipe de trinta vale 1,10 agentes independentes.
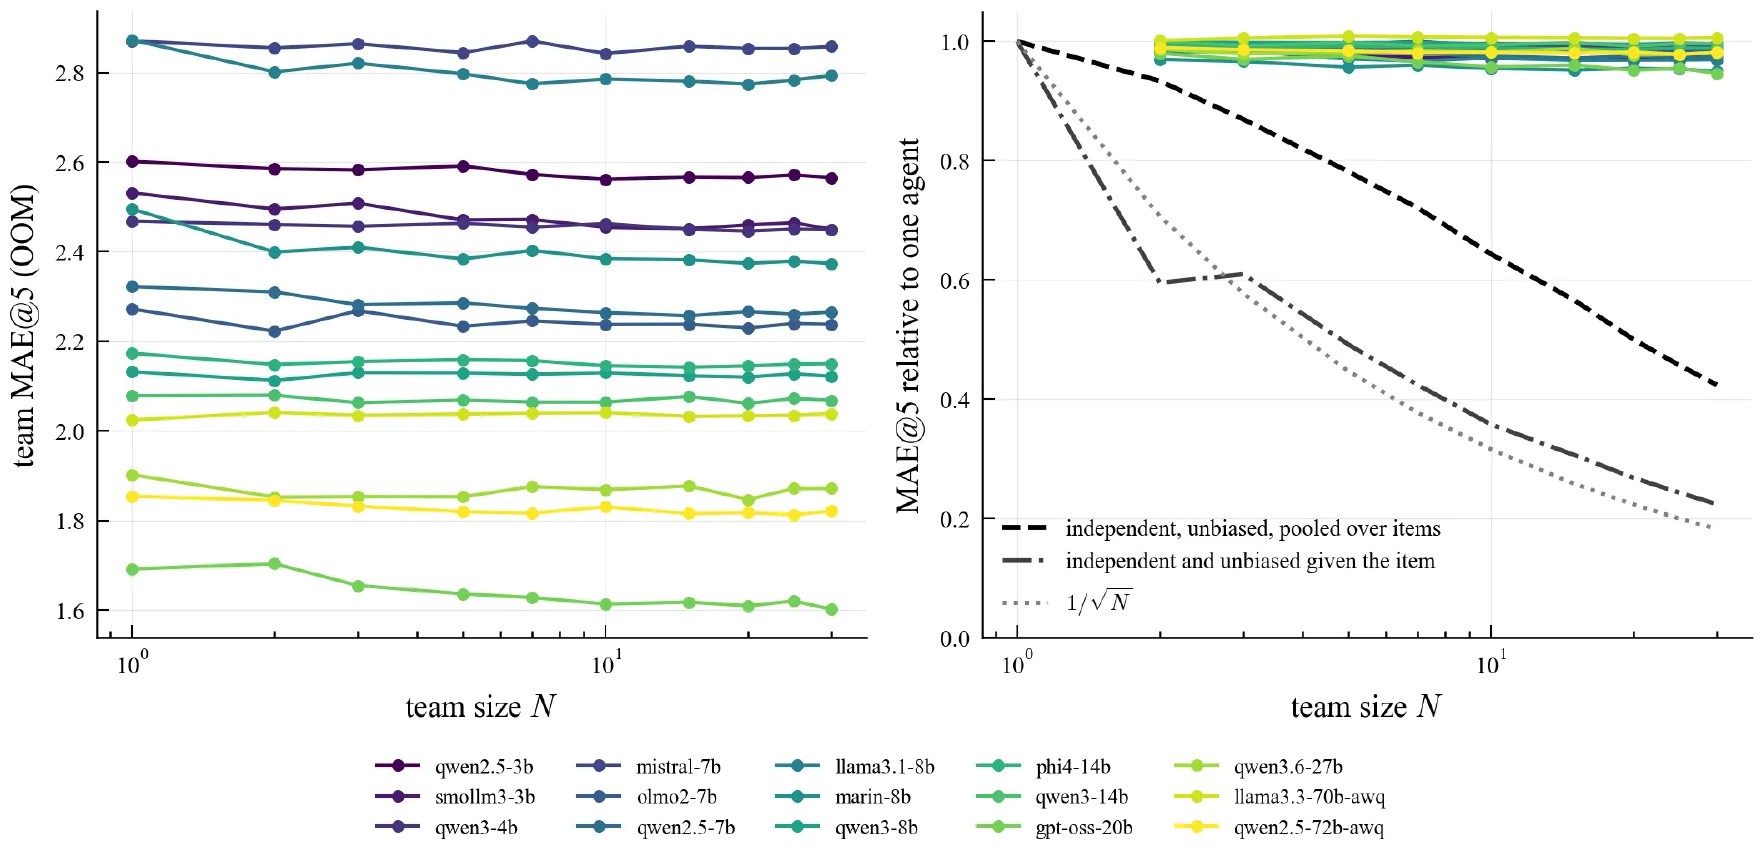
Esquerda: erro da equipe em função do tamanho da equipe N para 15 modelos. Direita: o mesmo em relação a um único agente (linhas coloridas, perto de 1), comparado com o que dariam respostas independentes e sem viés (linhas pretas tracejada e traço-ponto) e com a taxa 1/√N (pontilhada). — Figura 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
Na prática, equipes de trinta reduziram o erro de um único agente numa mediana de 1,7%, e no máximo em 5,4%. Respostas independentes que também não carregassem nenhum engano compartilhado em cada pergunta o teriam reduzido em 74 a 79%.
Tudo tende para um milhão
Parte do engano compartilhado tem uma forma reconhecível. Todos os modelos superestimam quantidades pequenas e subestimam as grandes, comprimindo suas estimativas em direção a cerca de um milhão (10⁶). Essa tendência aparece nos 15 modelos, mas explica apenas uma mediana de 17% do erro compartilhado. Os modelos também erram nas mesmas perguntas e na mesma direção: os erros por pergunta de dois modelos diferentes ainda têm correlação de 0,60 a 0,69 depois que os casos extremos são atenuados e a tendência para um milhão é removida.
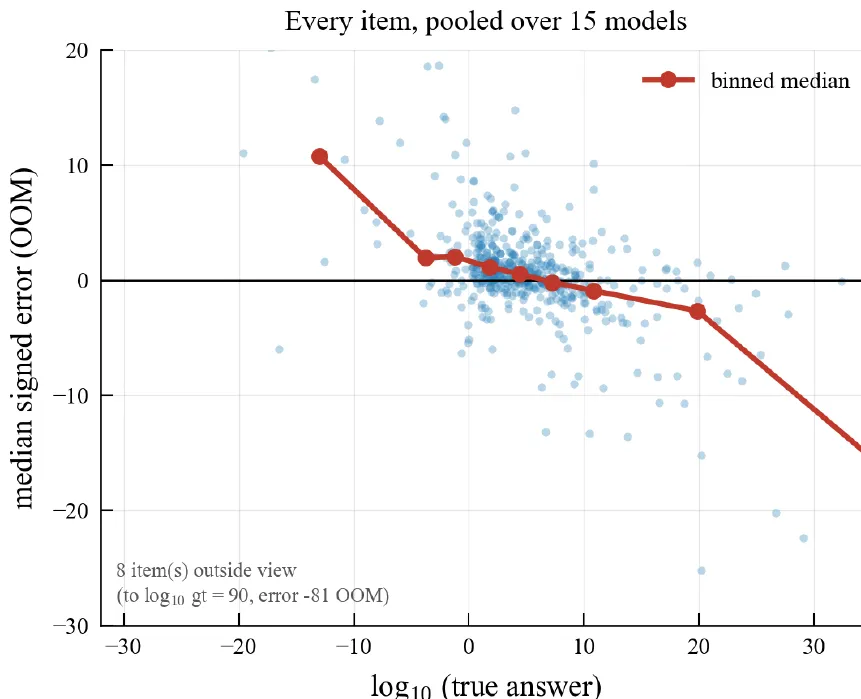
Erro mediano dos 15 modelos em cada pergunta, em função da resposta verdadeira (potências de dez): quantidades pequenas são superestimadas, as grandes, subestimadas. — Figura 1 (esquerda), Fortuna & Bertalanič (2026), arXiv:2611.16315.
Conversar não ajuda
E se os agentes discutirem? Em três rodadas de debate, cada agente viu as respostas dos colegas de equipe e revisou a sua. A dispersão dentro das equipes de cinco despencou 93% — na terceira rodada, para 12 dos 15 modelos, três de cinco agentes davam o mesmo número em pelo menos metade das perguntas. Mas o engano compartilhado não se mexeu, e o ganho total foi de 2,1%, com quinze vezes o custo computacional. Agentes que simplesmente revisaram a própria resposta, sem ver os colegas, se saíram pelo menos tão bem.
O que ajudou um pouco
Aumentar a temperatura de amostragem tornou as respostas mais variadas sem melhorar as equipes em mais de cerca de 1%. Misturar modelos diferentes ajudou mais: cinco modelos de precisão semelhante se saíram 6,6% melhor juntos do que em suas próprias equipes. Ainda assim, nenhuma mistura dos 15 modelos superou de forma significativa uma equipe formada apenas pelo modelo mais preciso, o gpt-oss-20b. Uma correção aprendida em perguntas com respostas conhecidas eliminou o viés geral dos modelos, mas não o engano pergunta por pergunta.
Os autores destacam os limites: modelos abertos de tamanho modesto, sem seus modos de “raciocínio” (thinking), nesses benchmarks e prompts; modelos de fronteira e de raciocínio não foram testados. A conclusão deles é uma lição de projeto. Acrescentar mais agentes, ou mais discordância, não corrige um engano que todas as cópias de um modelo compartilham. Os autores sugerem atacar diretamente esse erro compartilhado, por exemplo dando aos agentes informações específicas de cada pergunta — um caminho que ainda não testaram.