ТРИДЦАТЬ ИИ, ОДНА ОШИБКА
Мудрость толпы — идея, которую статья возводит к Гальтону в 1907 году, — гласит: усредните много независимых догадок, и ошибки компенсируют друг друга. Если ошибки несмещённые и независимые, ошибка среднего уменьшается как единица, делённая на квадратный корень из числа догадок. Многие системы, объединяющие несколько языковых моделей ИИ, — через выборку и голосование, через дебаты или через комитеты из разных моделей — опираются на этот аргумент: команда побольше может заменить более сильного агента.
Каролина Фортуна (Carolina Fortuna) и Блаж Берталанич (Blaž Bertalanič) из Института Йожефа Стефана в Любляне указывают, что этот аргумент верен лишь настолько, насколько верны его исходные посылки, и решили их проверить.
Вопросы Ферми как испытательный стенд
Вопросы Ферми требуют назвать величины, которые можно только оценить, например сколько предметов поместится в контейнер. Ответы на них — числа, охватывающие много порядков величины, поэтому ошибку можно измерять в порядках величины — расхождение в десять раз считается за один, — и ошибки противоположного знака действительно могут компенсировать друг друга.
Команда собрала 2,51 миллиона ответов от 15 моделей с открытыми весами (open-weight models) размером от 3 до 72 миллиардов параметров на 529 вопросов тестового набора realFP и проверила результаты ещё на двух наборах вопросов. Каждая модель отвечала на каждый вопрос около 350 раз, и команды из 2–30 ответов усреднялись в логарифмической шкале.
Сами по себе модели плохо справляются с этой игрой. Отдельный ответ имеет правильный порядок величины на 12–34% вопросов и ошибается более чем в сто раз на 30–63%.
Ошибка, общая для всех копий
Ключевой шаг — разделить ошибку каждого ответа на две части. Первая — ошибка, которую модель совершает на конкретном вопросе; она общая для всех её ответов на этот вопрос. Вторая — случайная часть, меняющаяся от одного ответа к другому. При усреднении ответов компенсироваться может только вторая.
Оказывается, преобладает первая часть. На realFP на неё приходится медианная доля 0,906 дисперсии ошибки. При заданном вопросе два ответа из одной команды не коррелируют между собой, как и следует из независимой выборки; но у них одна и та же общая ошибка.
Статья сводит это к одному числу с помощью классической формулы, известной как эффект плана Киша (design effect): эффективное число независимых ответов в команде из N равно N / (1 + (N − 1)ρ), где ρ — та самая общая доля. При ρ = 0,906 команда из тридцати стоит 1,10 независимого агента.
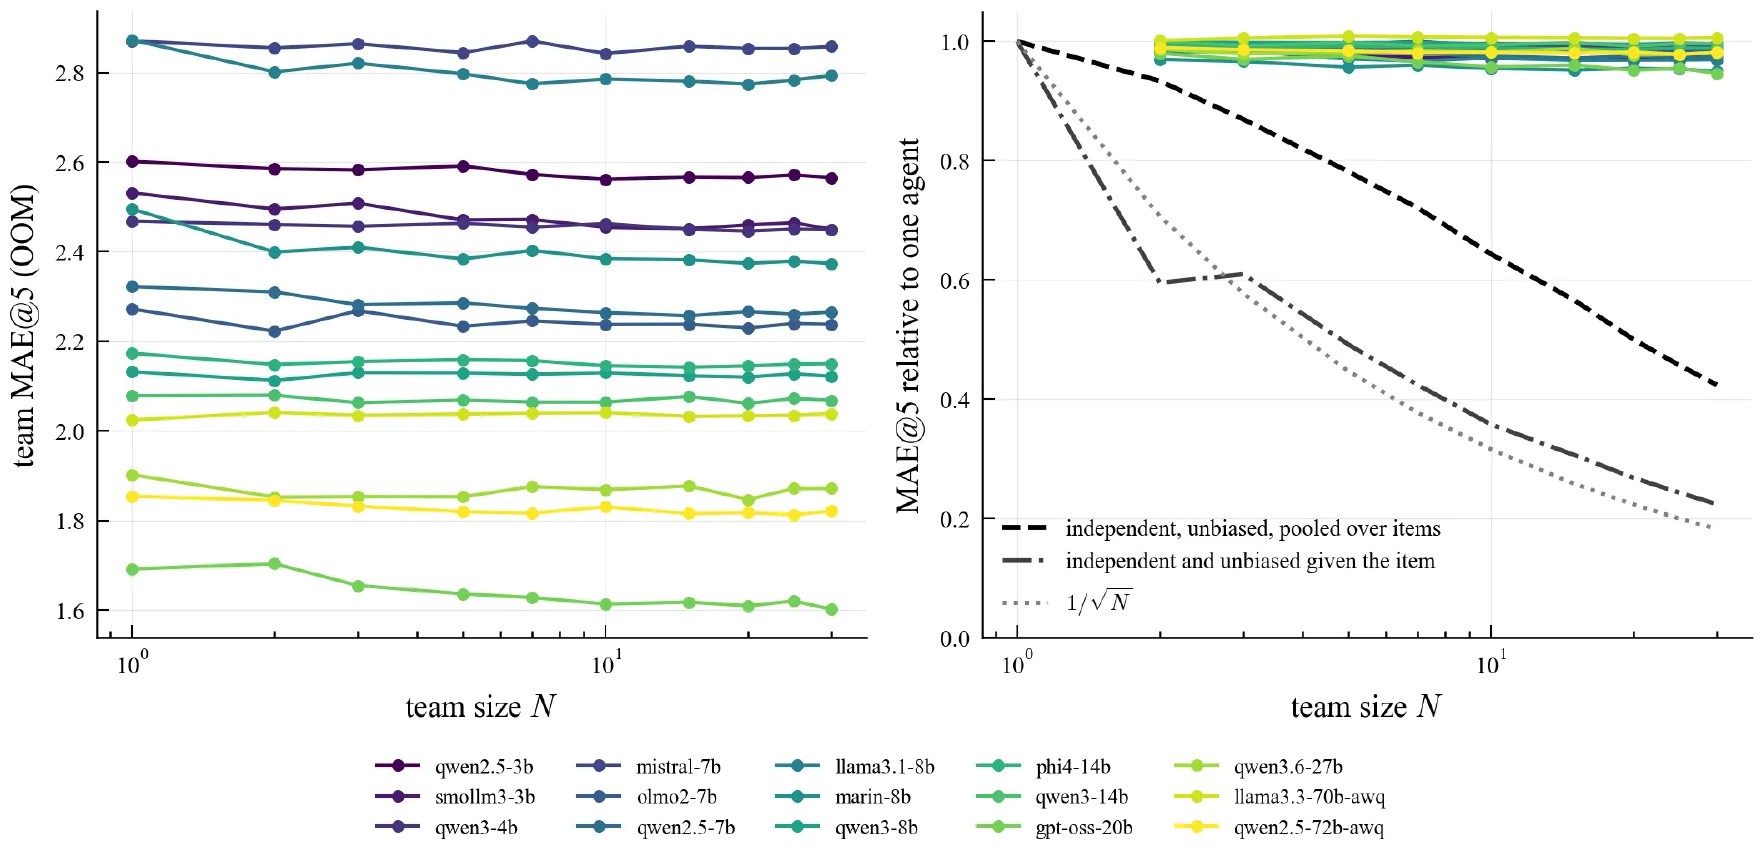
Слева: ошибка команды в зависимости от размера команды N для 15 моделей. Справа: то же самое относительно одного агента (цветные линии, около 1) в сравнении с тем, что дали бы независимые и несмещённые ответы (чёрные штриховая и штрихпунктирная линии), и со скоростью 1/√N (пунктир). — Рисунок 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
На практике команды из тридцати снижали ошибку одного агента в медиане на 1,7%, а максимум — на 5,4%. Независимые ответы, которые к тому же не несли бы общей ошибки на каждом вопросе, сократили бы её от 74 до 79%.
Всё сползает к миллиону
У части общей ошибки узнаваемая форма. Каждая модель переоценивает малые величины и недооценивает большие, сжимая свои оценки примерно к миллиону (10⁶). Эта тенденция проявляется у всех 15 моделей, но объясняет лишь медианные 17% общей ошибки. Кроме того, модели ошибаются на одних и тех же вопросах в одну и ту же сторону: ошибки двух разных моделей по отдельным вопросам по-прежнему коррелируют на уровне 0,60–0,69, если приглушить крайние случаи и убрать сползание к миллиону.
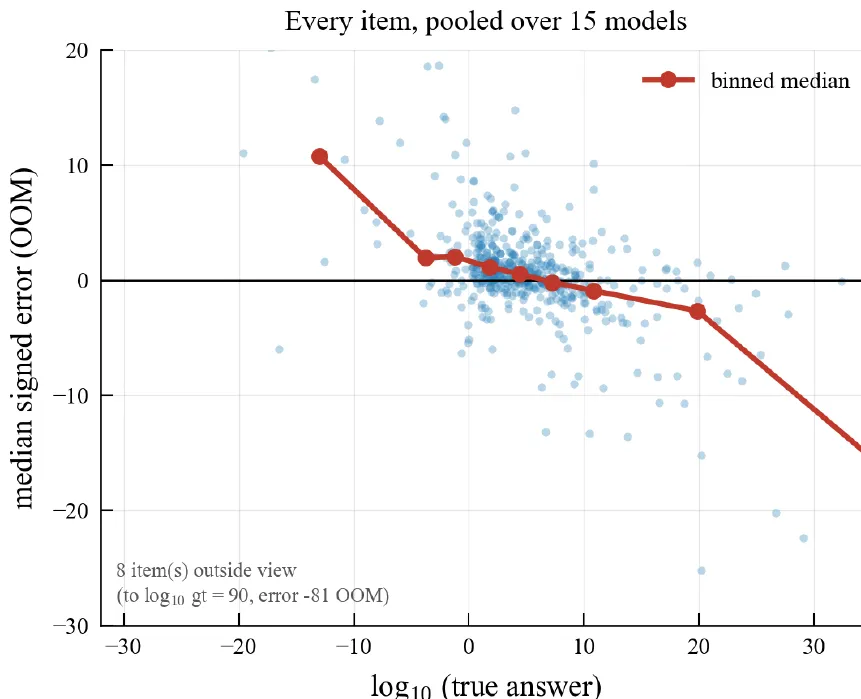
Медианная ошибка 15 моделей на каждом вопросе в зависимости от истинного ответа (степени десяти): малые величины переоцениваются, большие недооцениваются. — Рисунок 1 (слева), Fortuna & Bertalanič (2026), arXiv:2611.16315.
Обсуждение не помогает
А что, если агенты всё обсудят? В трёх раундах дебатов каждый агент видел ответы товарищей по команде и пересматривал свой. Разброс внутри команд из пяти агентов сократился на 93% — к третьему раунду у 12 из 15 моделей три агента из пяти называли одно и то же число по меньшей мере на половине вопросов. Но общая ошибка не сдвинулась, а итоговый выигрыш составил 2,1% при вычислительных затратах в пятнадцать раз выше. Агенты, которые просто пересматривали собственный ответ, не видя ответов коллег, справлялись по меньшей мере так же хорошо.
Что немного помогло
Повышение температуры выборки (sampling temperature) делало ответы разнообразнее, но улучшало результаты команд не более чем примерно на 1%. Смешивание разных моделей помогало больше: пять моделей схожей точности вместе работали на 6,6% лучше, чем в собственных командах. Однако ни одна смесь из 15 моделей не дала значимого улучшения по сравнению с командой, составленной из одной самой точной модели, gpt-oss-20b. Поправка, обученная на вопросах с известными ответами, устранила общее смещение моделей, но не ошибку, специфичную для каждого вопроса.
Авторы подчёркивают ограничения: открытые модели скромного размера без режимов «размышления» (thinking), на этих тестовых наборах и с этими запросами; передовые модели и модели с рассуждением не тестировались. Их вывод — урок для проектирования. Добавление новых агентов или новых разногласий не исправляет ошибку, которую разделяет каждая копия модели. Авторы предлагают атаковать эту общую ошибку напрямую, например давая агентам информацию, относящуюся к каждому конкретному вопросу, — путь, который они пока не проверили.