तीस एआय, एकच चूक
गर्दीचे शहाणपण — शोधनिबंधानुसार ही कल्पना 1907 मधील गॅल्टनपर्यंत (Galton) मागे जाते — असे सांगते: अनेक स्वतंत्र अंदाजांची सरासरी घ्या, आणि त्रुटी एकमेकांना रद्द करतात. जर त्रुटी पूर्वग्रहरहित आणि स्वतंत्र असतील, तर सरासरीची त्रुटी अंदाजांच्या संख्येच्या वर्गमुळाच्या व्यस्त प्रमाणात कमी होते. अनेक एआय भाषा-प्रतिमाने एकत्र करणाऱ्या अनेक प्रणाली — नमुने घेऊन मतदानाद्वारे, वादविवादाद्वारे, किंवा वेगवेगळ्या प्रतिमानांच्या समित्यांद्वारे — याच युक्तिवादावर टेकलेल्या आहेत: मोठा संघ अधिक चांगल्या कारकाची जागा घेऊ शकतो.
ल्युब्लियाना येथील योझेफ स्टेफान संस्थेतील (Jožef Stefan Institute) कॅरोलिना फॉर्तुना (Carolina Fortuna) आणि ब्लाझ बेर्तालानिच (Blaž Bertalanič) निदर्शनास आणतात की हा युक्तिवाद त्याच्या गृहीतकांइतकाच भक्कम आहे, आणि त्यांनी त्या गृहीतकांचीच चाचणी घेण्याचे ठरवले.
चाचणीचे व्यासपीठ म्हणून फर्मी प्रश्न
फर्मी प्रश्न अशा राशी विचारतात ज्यांचा फक्त अंदाजच बांधता येतो, जसे की एखाद्या पात्रात किती वस्तू मावतात. त्यांची उत्तरे अनेक परिमाण-क्रमांवर पसरलेल्या संख्या असतात, त्यामुळे त्रुटी परिमाण-क्रमांमध्ये मोजता येते — दहापटीचा फरक म्हणजे एक — आणि विरुद्ध चिन्हांच्या त्रुटी खरोखरच एकमेकांना रद्द करू शकतात.
चमूने 3 ते 72 अब्ज प्राचलांच्या 15 खुल्या-भारांकांच्या प्रतिमानांकडून (open-weight models) realFP मानदंडातील 529 प्रश्नांची 2.51 दशलक्ष उत्तरे गोळा केली, आणि प्रश्नांच्या इतर दोन संचांवर निकाल तपासले. प्रत्येक प्रतिमानाने प्रत्येक प्रश्नाला सुमारे 350 वेळा उत्तर दिले, आणि 2 ते 30 उत्तरांच्या संघांची लघुगणकीय मोजपट्टीवर सरासरी घेतली गेली.
एकेकटी, प्रतिमाने या खेळात कच्ची आहेत. एका उत्तराचा परिमाण-क्रम 12 ते 34% प्रश्नांवर बरोबर असतो, आणि 30 ते 63% प्रश्नांवर ते शंभरपटीहून अधिक चुकते.
प्रत्येक प्रतीत सामायिक असलेली त्रुटी
महत्त्वाची पायरी म्हणजे प्रत्येक उत्तराच्या त्रुटीचे दोन भाग करणे. एक म्हणजे एखादे प्रतिमान एखाद्या विशिष्ट प्रश्नावर करत असलेली चूक, जी त्या प्रश्नाच्या त्याच्या सर्व उत्तरांत सामायिक असते. दुसरा म्हणजे एका उत्तरापासून दुसऱ्या उत्तरापर्यंत बदलणारा यादृच्छिक भाग. उत्तरांची सरासरी घेतल्यावर फक्त दुसराच भाग रद्द होऊ शकतो.
असे दिसून येते की पहिला भाग वरचढ आहे. realFP वर तो त्रुटीच्या प्रसरणाचा मध्यगा 0.906 इतका वाटा व्यापतो. प्रश्न दिल्यावर, एकाच संघातील दोन उत्तरे सहसंबंधरहित असतात, जसे स्वतंत्र नमुने घेण्यातून अपेक्षित आहे; पण त्यांची चूक एकच असते.
शोधनिबंध याचे रूपांतर एका संख्येत करतो, किश (Kish) यांचा आराखडा-परिणाम (design effect) या नावाने ओळखल्या जाणाऱ्या एका अभिजात सूत्राद्वारे: N उत्तरांच्या संघातील स्वतंत्र उत्तरांची प्रभावी संख्या N / (1 + (N − 1)ρ) असते, जिथे ρ हा तो सामायिक वाटा आहे. ρ = 0.906 असताना, तीसचा संघ फक्त 1.10 स्वतंत्र कारकांइतका ठरतो.
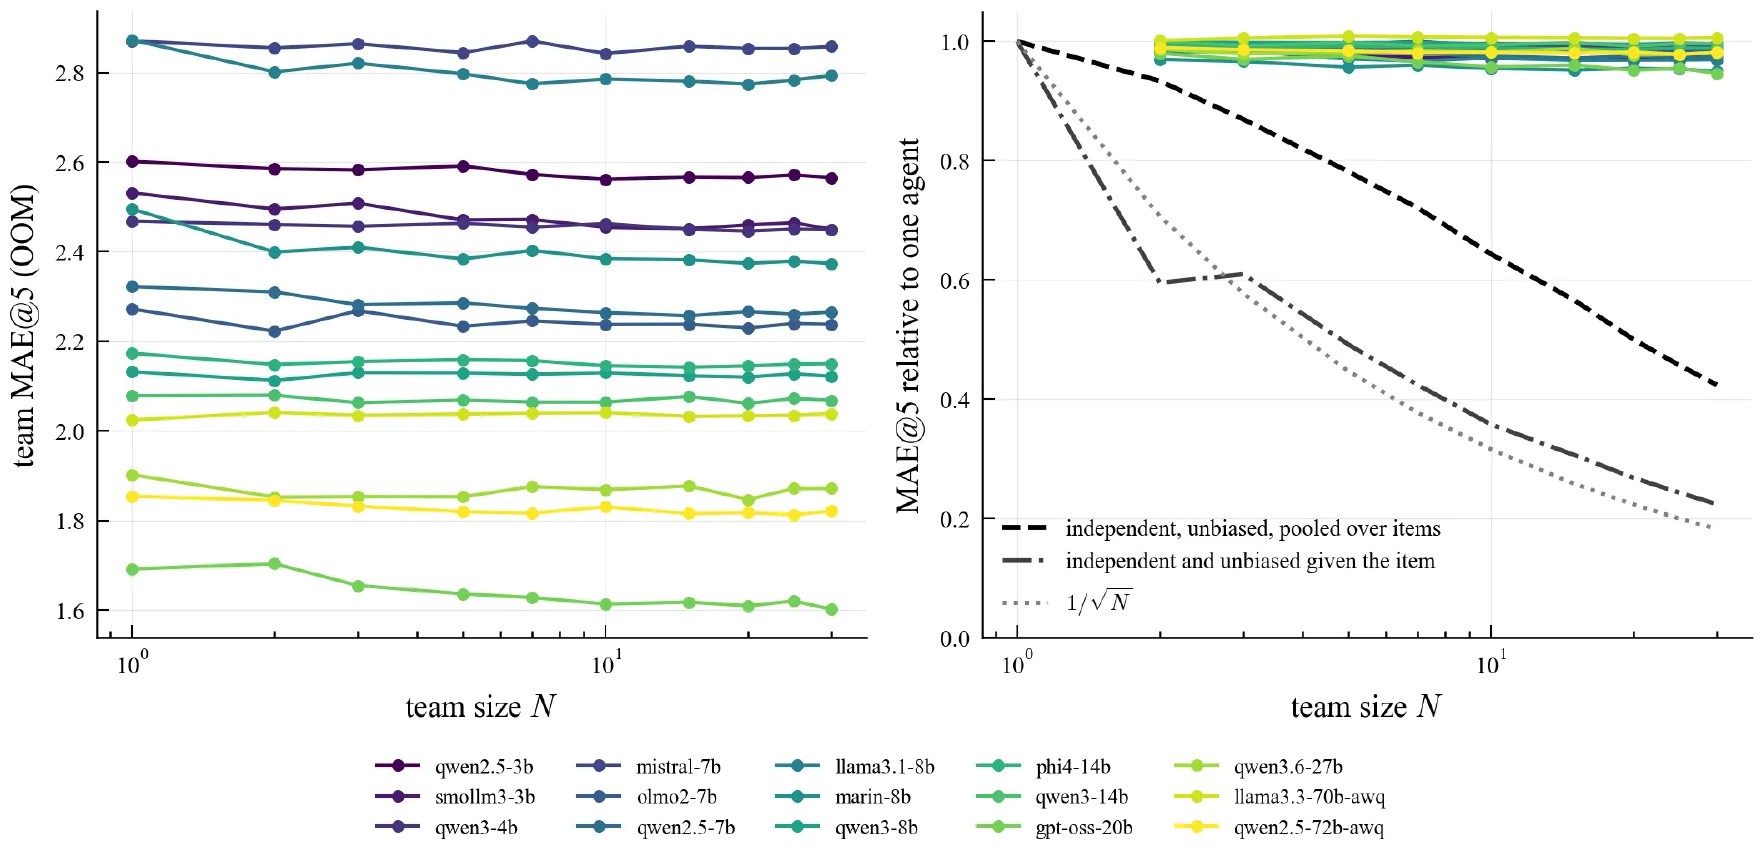
डावीकडे: 15 प्रतिमानांसाठी संघाची त्रुटी विरुद्ध संघाचा आकार N. उजवीकडे: तेच एका कारकाच्या सापेक्ष (रंगीत रेषा, 1 जवळ), स्वतंत्र आणि पूर्वग्रहरहित उत्तरांनी जे मिळाले असते त्याविरुद्ध (काळ्या तुटक आणि रेघ-ठिपका रेषा) आणि 1/√N दराविरुद्ध (ठिपक्यांची रेषा). — आकृती 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
व्यवहारात, तीसच्या संघांनी एका कारकाची त्रुटी मध्यगा 1.7% ने, आणि जास्तीत जास्त 5.4% ने कमी केली. स्वतंत्र आणि प्रत्येक प्रश्नावर कोणतीही सामायिक चूक नसलेल्या उत्तरांनी ती 74 ते 79% ने कमी केली असती.
सर्व काही एक दशलक्षाकडे सरकते
सामायिक चुकीच्या एका भागाला ओळखता येईल असा आकार आहे. प्रत्येक प्रतिमान लहान राशींचा अतिअंदाज आणि मोठ्या राशींचा न्यूनअंदाज करते, आपले अंदाज सुमारे एक दशलक्षाकडे (10⁶) दाबत. हा कल सर्व 15 प्रतिमानांत दिसतो, पण तो सामायिक त्रुटीपैकी फक्त मध्यगा 17% चेच स्पष्टीकरण देतो. प्रतिमाने एकाच प्रश्नांवर एकाच दिशेनेही चुकतात: टोकाची प्रकरणे काबूत आणल्यावर आणि एक दशलक्षाकडे सरकण्याचा कल काढून टाकल्यावरही, दोन वेगवेगळ्या प्रतिमानांच्या प्रश्नवार त्रुटींचा सहसंबंध 0.60 ते 0.69 असतो.
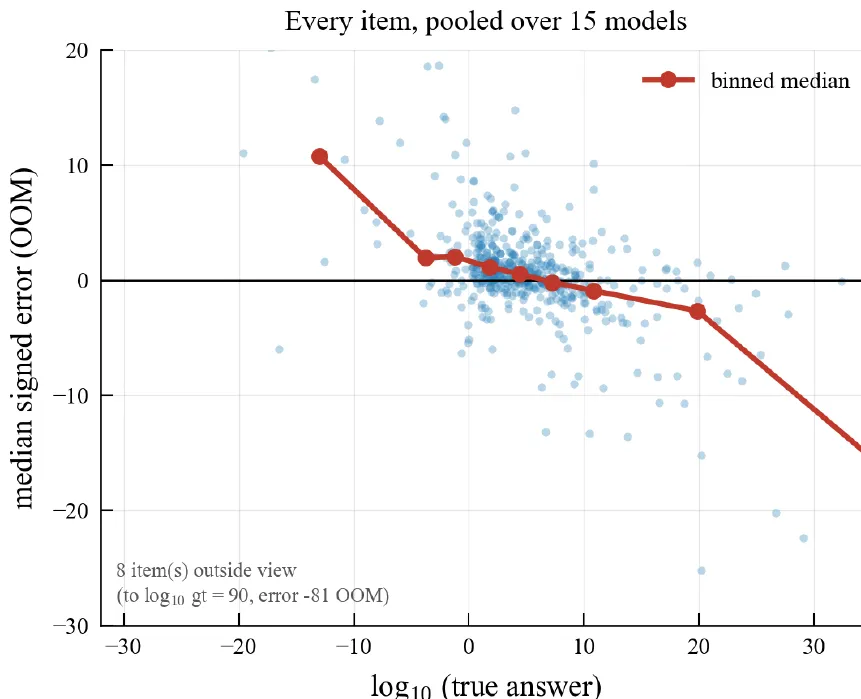
प्रत्येक प्रश्नावर 15 प्रतिमानांची मध्यगा त्रुटी, खऱ्या उत्तराविरुद्ध (दहाचे घात): लहान राशींचा अतिअंदाज, मोठ्यांचा न्यूनअंदाज होतो. — आकृती 1 (डावीकडे), Fortuna & Bertalanič (2026), arXiv:2611.16315.
चर्चा करून उपयोग होत नाही
कारकांनी चर्चा केली तर? वादविवादाच्या तीन फेऱ्यांमध्ये प्रत्येक कारकाने आपल्या संघसहकाऱ्यांची उत्तरे पाहिली आणि आपले उत्तर सुधारले. पाचच्या संघांमधील विखुरणे 93% ने कोसळले — तिसऱ्या फेरीपर्यंत, 15 पैकी 12 प्रतिमानांसाठी, किमान अर्ध्या प्रश्नांवर पाचपैकी तीन कारकांनी तीच संख्या दिली. पण सामायिक चूक हलली नाही, आणि एकूण लाभ 2.1% होता, पंधरापट संगणन-खर्चात. सहकाऱ्यांची उत्तरे न पाहता फक्त स्वतःचे उत्तर सुधारणाऱ्या कारकांनी किमान तितकीच चांगली कामगिरी केली.
थोडीफार मदत कशाने झाली
नमुने घेण्याचे तापमान वाढवल्याने उत्तरे अधिक वैविध्यपूर्ण झाली, पण संघांमध्ये सुमारे 1% पेक्षा अधिक सुधारणा झाली नाही. वेगवेगळी प्रतिमाने मिसळल्याने अधिक मदत झाली: साधारण सारख्याच अचूकतेची पाच प्रतिमाने आपापल्या संघांपेक्षा एकत्रितपणे 6.6% ने अधिक चांगली ठरली. तरीही 15 प्रतिमानांच्या कोणत्याही मिश्रणाने सर्वांत अचूक अशा एकाच प्रतिमानापासून, gpt-oss-20b पासून, बनवलेल्या संघापेक्षा लक्षणीय सुधारणा केली नाही. उत्तरे माहीत असलेल्या प्रश्नांवर शिकलेल्या एका दुरुस्तीने प्रतिमानांचा एकूण पूर्वग्रह काढून टाकला, पण प्रश्नागणिक चूक नाही.
लेखक मर्यादांवर भर देतात: माफक आकाराची खुली प्रतिमाने, त्यांच्या “विचार” (thinking) पद्धतींशिवाय, या मानदंडांवर आणि सूचनांवर; अग्रगण्य आणि तर्कशील प्रतिमाने तपासली गेली नाहीत. त्यांचा निष्कर्ष हा आराखड्यासाठीचा धडा आहे. अधिक कारक, किंवा अधिक मतभेद जोडल्याने, एखाद्या प्रतिमानाच्या प्रत्येक प्रतीत सामायिक असलेली चूक दुरुस्त होत नाही. लेखक त्या सामायिक त्रुटीवर थेट हल्ला करण्याचे सुचवतात, उदाहरणार्थ कारकांना प्रत्येक प्रश्नासाठी विशिष्ट माहिती देऊन — असा मार्ग जो त्यांनी अद्याप तपासलेला नाही.