TREINTA IA, UN MISMO ERROR
La sabiduría de las multitudes, una idea que el artículo remonta a Galton en 1907, dice: promedia muchas conjeturas independientes y los errores se compensan. Si los errores no tienen sesgo y son independientes, el error de la media disminuye como uno dividido por la raíz cuadrada del número de conjeturas. Muchos sistemas que combinan varios modelos de lenguaje de IA —mediante muestreo y votación, mediante debate o mediante comités de modelos distintos— se apoyan en este argumento: un equipo más grande puede sustituir a un agente mejor.
Carolina Fortuna y Blaž Bertalanič, del Instituto Jožef Stefan de Liubliana, señalan que el argumento vale lo que valen sus premisas, y se propusieron ponerlas a prueba.
Las preguntas de Fermi como banco de pruebas
Las preguntas de Fermi piden cantidades que solo pueden estimarse, como cuántos objetos caben en un recipiente. Sus respuestas son números que abarcan muchos órdenes de magnitud, así que el error puede medirse en órdenes de magnitud —un factor diez cuenta como uno— y los errores de signo opuesto pueden compensarse de verdad.
El equipo reunió 2,51 millones de respuestas de 15 modelos de pesos abiertos (open-weight models), de 3.000 a 72.000 millones de parámetros, a las 529 preguntas del banco de pruebas realFP, y comprobó los resultados con otros dos conjuntos de preguntas. Cada modelo respondió a cada pregunta unas 350 veces, y se promediaron equipos de 2 a 30 respuestas en escala logarítmica.
Por sí solos, los modelos son malos en este juego. Una sola respuesta acierta el orden de magnitud en el 12 al 34 % de las preguntas, y se desvía en más de un factor cien en el 30 al 63 %.
El error que comparte cada copia
El paso clave es dividir el error de cada respuesta en dos partes. Una es el error que comete un modelo en una pregunta concreta, compartido por todas sus respuestas a ella. La otra es la parte aleatoria que varía de una respuesta a otra. Solo la segunda puede compensarse al promediar las respuestas.
Resulta que la primera parte domina. En realFP, representa una mediana de 0,906 de la varianza del error. Dada la pregunta, dos respuestas del mismo equipo no están correlacionadas, como implica un muestreo independiente; pero comparten el mismo error.
El artículo lo convierte en un único número con una fórmula clásica conocida como efecto de diseño de Kish (design effect): el número efectivo de respuestas independientes en un equipo de N es N / (1 + (N − 1)ρ), donde ρ es esa parte compartida. Con ρ = 0,906, un equipo de treinta equivale a 1,10 agentes independientes.
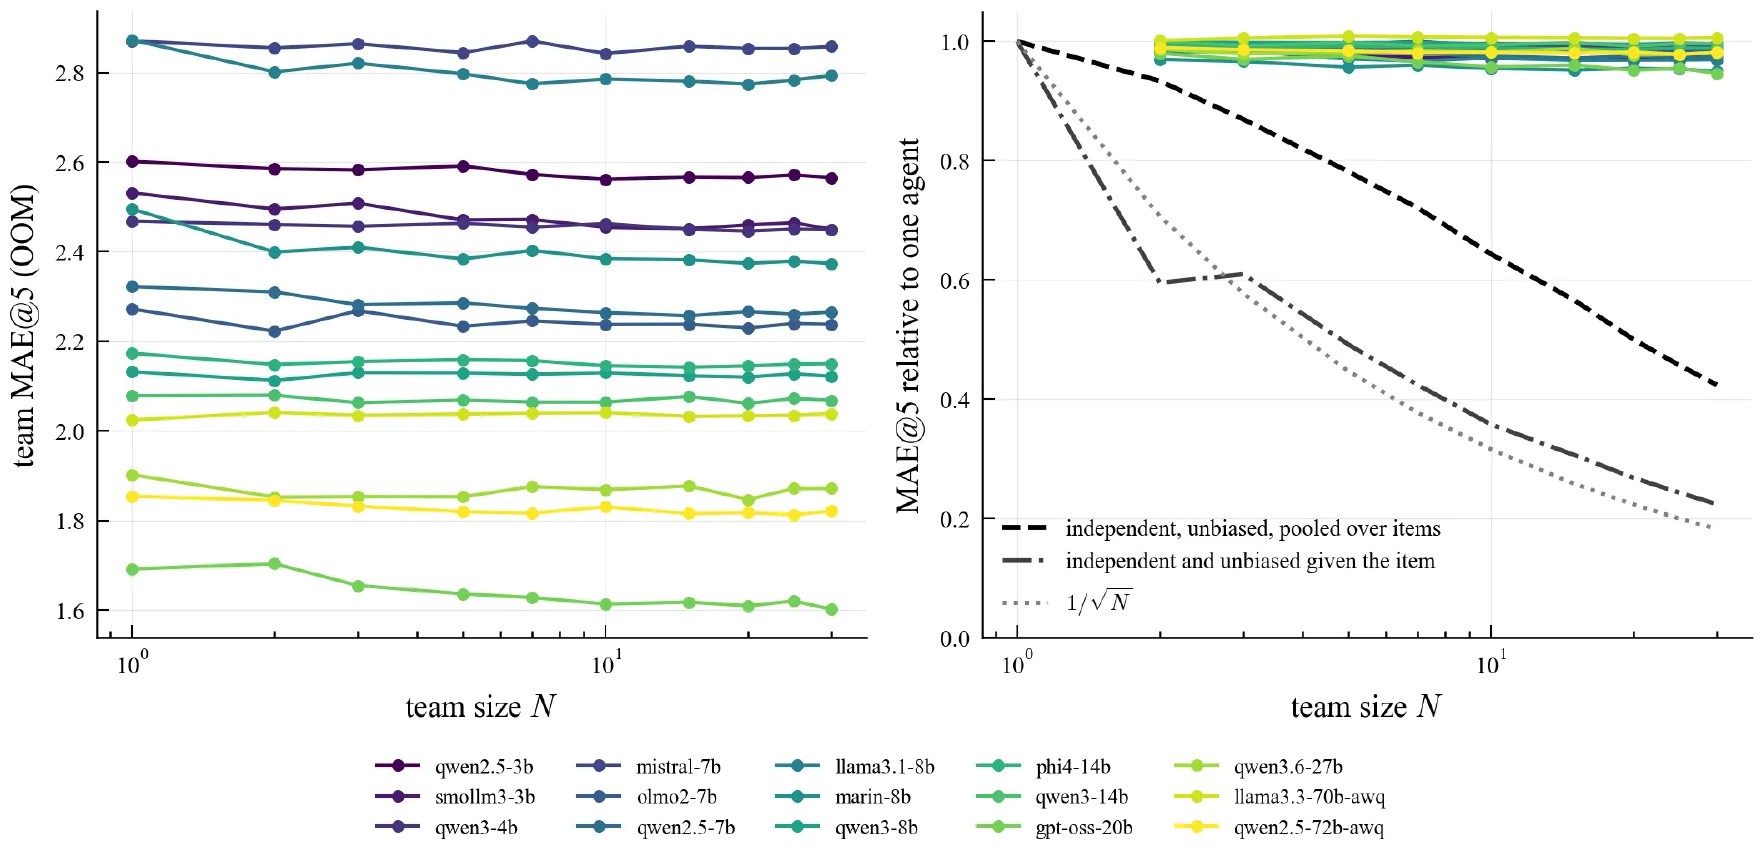
Izquierda: error del equipo frente al tamaño del equipo N para 15 modelos. Derecha: lo mismo en relación con un solo agente (líneas de colores, cerca de 1), frente a lo que darían respuestas independientes y sin sesgo (líneas negras discontinua y de trazo y punto) y la tasa 1/√N (punteada). — Figura 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
En la práctica, los equipos de treinta redujeron el error de un solo agente en una mediana del 1,7 %, y como mucho un 5,4 %. Unas respuestas independientes que además no arrastraran ningún error compartido en cada pregunta lo habrían reducido entre un 74 y un 79 %.
Todo deriva hacia un millón
Parte del error compartido tiene una forma reconocible. Todos los modelos sobrestiman las cantidades pequeñas y subestiman las grandes, comprimiendo sus estimaciones hacia alrededor de un millón (10⁶). Esta tendencia aparece en los 15 modelos, pero solo explica una mediana del 17 % del error compartido. Los modelos también se equivocan en las mismas preguntas y en la misma dirección: los errores por pregunta de dos modelos distintos siguen teniendo una correlación de 0,60 a 0,69 una vez domados los casos extremos y eliminada la deriva hacia un millón.
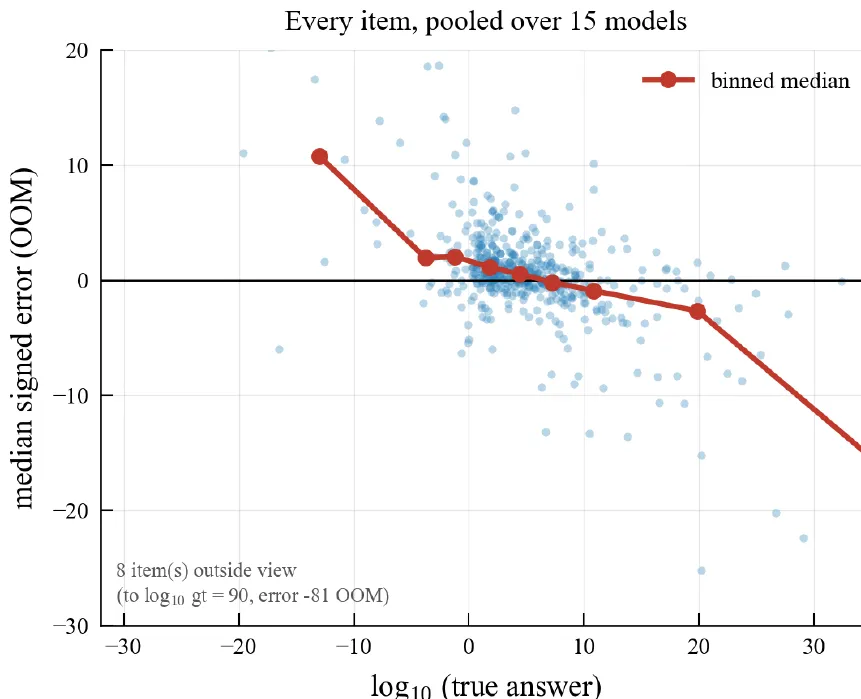
Error mediano de los 15 modelos en cada pregunta, frente a la respuesta verdadera (potencias de diez): las cantidades pequeñas se sobrestiman y las grandes se subestiman. — Figura 1 (izquierda), Fortuna & Bertalanič (2026), arXiv:2611.16315.
Hablarlo no ayuda
¿Y si los agentes discuten? En tres rondas de debate, cada agente vio las respuestas de sus compañeros de equipo y revisó la suya. La dispersión dentro de los equipos de cinco se desplomó un 93 %: en la tercera ronda, en 12 de los 15 modelos, tres de cada cinco agentes daban el mismo número en al menos la mitad de las preguntas. Pero el error compartido no se movió, y la ganancia total fue del 2,1 %, con un coste de cálculo quince veces mayor. Los agentes que simplemente revisaban su propia respuesta, sin ver a sus pares, lo hicieron al menos igual de bien.
Lo que ayudó un poco
Subir la temperatura de muestreo hizo las respuestas más variadas sin mejorar los equipos en más de un 1 % aproximadamente. Mezclar modelos distintos ayudó más: cinco modelos de precisión similar lo hicieron un 6,6 % mejor juntos que en sus propios equipos. Aun así, ninguna mezcla de los 15 modelos mejoró de forma significativa a un equipo formado solo con el más preciso, gpt-oss-20b. Una corrección aprendida con preguntas de respuesta conocida eliminó el sesgo global de los modelos, pero no el error pregunta a pregunta.
Los autores subrayan los límites: modelos abiertos de tamaño modesto, sin sus modos de «pensamiento», con estos bancos de pruebas e instrucciones; no se probaron modelos de frontera ni de razonamiento. Su conclusión es una lección de diseño. Añadir más agentes, o más desacuerdo, no corrige un error que comparte cada copia de un modelo. Los autores sugieren atacar directamente ese error compartido, por ejemplo dando a los agentes información específica de cada pregunta, una vía que todavía no han probado.