முப்பது AI-கள், ஒரே தவறு
கூட்டத்தின் ஞானம் (wisdom of crowds) — ஆய்வுக் கட்டுரை இந்த எண்ணத்தை 1907-இல் Galton வரை பின்னோக்கிக் கண்டறிகிறது — இவ்வாறு கூறுகிறது: ஒன்றையொன்று சாராத பல ஊகங்களின் சராசரியை எடுங்கள், பிழைகள் ரத்தாகிவிடும். பிழைகள் ஒருதலைச்சார்பற்றவையாகவும் (unbiased) ஒன்றையொன்று சாராதவையாகவும் இருந்தால், சராசரியின் பிழை, ஊகங்களின் எண்ணிக்கையின் வர்க்கமூலத்தால் ஒன்றை வகுத்ததைப் போலச் சுருங்குகிறது. பல AI மொழி மாதிரிகளை ஒருங்கிணைக்கும் பல அமைப்புகள் — மாதிரியெடுத்து வாக்களிப்பதன் மூலம், விவாதத்தின் மூலம், அல்லது வெவ்வேறு மாதிரிகளின் குழுக்கள் (committees) மூலம் — இந்த வாதத்தைச் சார்ந்துள்ளன: ஒரு பெரிய அணி, ஒரு சிறந்த முகவருக்கு (agent) ஈடாக முடியும்.
லியூப்லியானாவிலுள்ள (Ljubljana) யோசெஃப் ஸ்டெஃபான் நிறுவனத்தைச் (Jožef Stefan Institute) சேர்ந்த Carolina Fortuna, Blaž Bertalanič ஆகியோர், இந்த வாதம் அதன் முன்கோள்கள் எவ்வளவு உறுதியானவையோ அவ்வளவுதான் உறுதியானது என்று சுட்டிக்காட்டி, அவற்றைச் சோதிக்கப் புறப்பட்டனர்.
ஒரு சோதனைக் களமாக ஃபெர்மி கேள்விகள்
ஃபெர்மி கேள்விகள், ஒரு கொள்கலனில் எத்தனை பொருட்கள் அடங்கும் என்பது போன்ற, மதிப்பிட மட்டுமே முடிகிற அளவுகளைக் கேட்கின்றன. அவற்றின் விடைகள் பல பருமன் வரிசைகளில் பரவியுள்ள எண்கள்; எனவே ஒரு பிழையைப் பருமன் வரிசைகளில் (orders of magnitude) அளக்க முடியும் — பத்து மடங்கு வேறுபாடு ஒன்றாகக் கணக்கிடப்படுகிறது — மேலும் எதிரெதிர்க் குறிகள் கொண்ட பிழைகள் உண்மையாகவே ஒன்றையொன்று ரத்துசெய்ய முடியும்.
realFP அளவுகோல் தொகுப்பின் (benchmark) 529 கேள்விகளுக்கு, 3 முதல் 72 பில்லியன் அளவுருக்கள் (parameters) கொண்ட 15 திறந்த-எடை மாதிரிகளிடமிருந்து (open-weight models) 2.51 மில்லியன் பதில்களைக் குழு சேகரித்து, முடிவுகளை வேறு இரண்டு கேள்வித் தொகுப்புகளில் சரிபார்த்தது. ஒவ்வொரு மாதிரியும் ஒவ்வொரு கேள்விக்கும் சுமார் 350 முறை பதிலளித்தது; 2 முதல் 30 பதில்கள் கொண்ட அணிகளின் சராசரி மடக்கை அளவுகோலில் (logarithmic scale) எடுக்கப்பட்டது.
தனியாக, மாதிரிகள் இந்த விளையாட்டில் மோசமாகவே செயல்படுகின்றன. ஒற்றைப் பதில், 12 முதல் 34% கேள்விகளில் சரியான பருமன் வரிசையைக் கொண்டுள்ளது; 30 முதல் 63% கேள்விகளில் நூறு மடங்குக்கும் மேல் விலகியுள்ளது.
ஒவ்வொரு நகலும் பகிர்ந்துகொள்ளும் பிழை
முக்கியப் படி, ஒவ்வொரு பதிலின் பிழையையும் இரண்டு பகுதிகளாகப் பிரிப்பது. ஒன்று, ஒரு குறிப்பிட்ட கேள்வியில் ஒரு மாதிரி செய்யும் தவறு; அந்தக் கேள்விக்கான அதன் எல்லாப் பதில்களும் அதைப் பகிர்ந்துகொள்கின்றன. மற்றொன்று, ஒரு பதிலிலிருந்து அடுத்ததற்கு மாறுபடும் சீரற்ற பகுதி. பதில்களின் சராசரி எடுக்கப்படும்போது இரண்டாவது பகுதி மட்டுமே ரத்தாக முடியும்.
முதல் பகுதியே மேலோங்கியிருக்கிறது என்று தெரியவருகிறது. realFP-இல், பிழை மாறுபாட்டில் (variance) அதன் இடைநிலைப் (median) பங்கு 0.906. கேள்வி தெரிந்தபின், ஒரே அணியின் இரண்டு பதில்கள் ஒன்றோடொன்று தொடர்பற்றவை (uncorrelated) — ஒன்றையொன்று சாராத மாதிரியெடுப்பு குறிப்பது போலவே; ஆனால் அவை ஒரே தவறைப் பகிர்ந்துகொள்கின்றன.
Kish-இன் வடிவமைப்பு விளைவு (design effect) எனப்படும் ஒரு மரபார்ந்த சூத்திரத்தைக் கொண்டு, ஆய்வுக் கட்டுரை இதை ஒற்றை எண்ணாக மாற்றுகிறது: N பதில்கள் கொண்ட ஓர் அணியில், ஒன்றையொன்று சாராத பதில்களின் பயனுள்ள எண்ணிக்கை N / (1 + (N − 1)ρ); இங்கே ρ என்பது அந்தப் பகிரப்பட்ட பங்கு. ρ = 0.906 எனும்போது, முப்பது பதில்கள் கொண்ட ஓர் அணி ஒன்றையொன்று சாராத 1.10 முகவர்களுக்குச் சமம்.
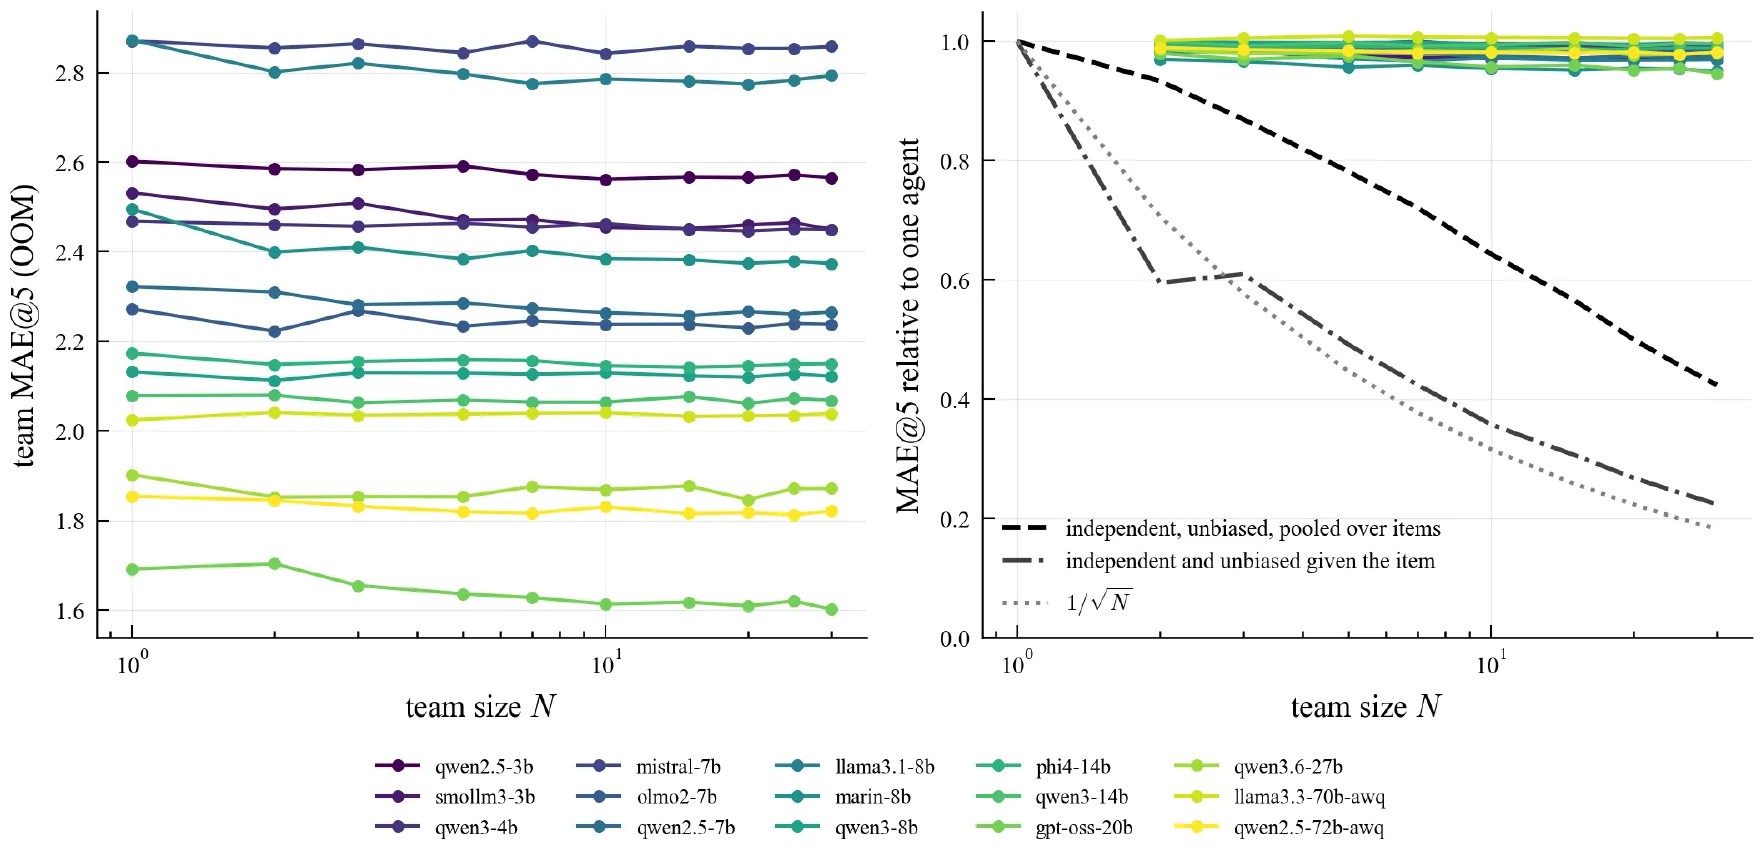
இடது: 15 மாதிரிகளுக்கு, அணியின் அளவு N-ஐப் பொறுத்து அணிப் பிழை. வலது: ஒற்றை முகவரைப் பொறுத்து அதே அளவு (வண்ணக் கோடுகள், 1-க்கு அருகில்); ஒன்றையொன்று சாராத, ஒருதலைச்சார்பற்ற பதில்கள் தருவதுடனும் (கருப்புக் கோடிட்ட, கோடு-புள்ளிக் கோடுகள்) 1/√N வீதத்துடனும் (புள்ளிக் கோடு) ஒப்பிடப்பட்டுள்ளது. — படம் 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
நடைமுறையில், முப்பது பதில்கள் கொண்ட அணிகள் ஒற்றை முகவரின் பிழையை இடைநிலை அளவில் 1.7% என்ற அளவுக்குக் குறைத்தன, அதிகபட்சம் 5.4%. ஒன்றையொன்று சாராத, மேலும் ஒவ்வொரு கேள்வியிலும் எந்தப் பகிரப்பட்ட தவறையும் கொண்டிராத பதில்கள் அதை 74 முதல் 79% வரை குறைத்திருக்கும்.
எல்லாமே ஒரு மில்லியனை நோக்கி நகர்கின்றன
பகிரப்பட்ட தவறின் ஒரு பகுதிக்கு அடையாளம் காணக்கூடிய ஒரு வடிவம் உண்டு. ஒவ்வொரு மாதிரியும் சிறிய அளவுகளை மிகைமதிப்பிடுகிறது, பெரிய அளவுகளைக் குறைமதிப்பிடுகிறது; இவ்வாறு அதன் மதிப்பீடுகளைச் சுமார் ஒரு மில்லியனை (10⁶) நோக்கி நெருக்குகிறது. இந்தப் போக்கு 15 மாதிரிகளிலும் தோன்றுகிறது; ஆனால் பகிரப்பட்ட பிழையில் இடைநிலை அளவில் 17%-ஐ மட்டுமே அது விளக்குகிறது. மாதிரிகள் ஒரே கேள்விகளில் ஒரே திசையிலும் தவறுகின்றன: தீவிரமான நிகழ்வுகள் கட்டுக்குள் கொண்டுவரப்பட்டு, ஒரு மில்லியனை நோக்கிய நகர்வு நீக்கப்பட்ட பின்னும், இரண்டு வெவ்வேறு மாதிரிகளின் கேள்விவாரிப் பிழைகள் 0.60 முதல் 0.69 வரை தொடர்புபட்டுள்ளன (correlated).
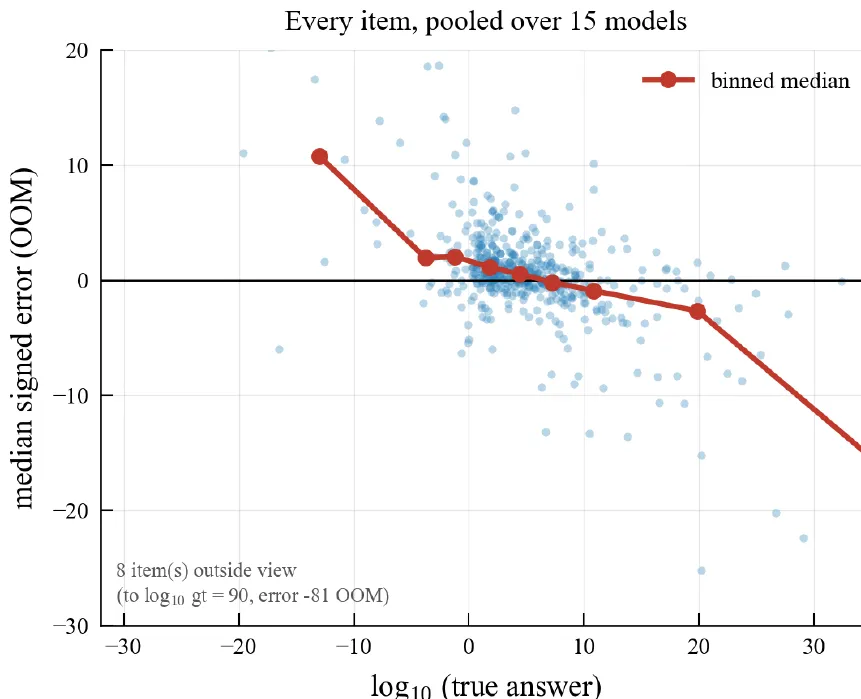
ஒவ்வொரு கேள்வியிலும் 15 மாதிரிகளின் இடைநிலைப் பிழை, உண்மையான விடைக்கு (பத்தின் அடுக்குகள்) எதிராக: சிறிய அளவுகள் மிகைமதிப்பிடப்படுகின்றன, பெரியவை குறைமதிப்பிடப்படுகின்றன. — படம் 1 (இடது), Fortuna & Bertalanič (2026), arXiv:2611.16315.
பேசித் தீர்ப்பது உதவுவதில்லை
முகவர்கள் கலந்துரையாடினால் என்ன? மூன்று சுற்று விவாதங்களில், ஒவ்வொரு முகவரும் தன் அணியினரின் பதில்களைப் பார்த்துத் தன் பதிலைத் திருத்தியது. ஐந்து முகவர்கள் கொண்ட அணிகளுக்குள் இருந்த பரவல் 93% சரிந்தது — மூன்றாவது சுற்றுக்குள், 15 மாதிரிகளில் 12 மாதிரிகளுக்கு, குறைந்தது பாதிக் கேள்விகளில் ஐந்தில் மூன்று முகவர்கள் ஒரே எண்ணைத் தந்தன. ஆனால் பகிரப்பட்ட தவறு அசையவில்லை; மொத்த ஆதாயம் 2.1%, அதுவும் பதினைந்து மடங்கு கணினிச் செலவில். சக முகவர்களைப் பார்க்காமல் தங்கள் சொந்தப் பதிலை வெறுமனே திருத்திய முகவர்கள், குறைந்தது அதே அளவு சிறப்பாகச் செயல்பட்டன.
சற்று உதவியவை
மாதிரியெடுப்பு வெப்பநிலையை (sampling temperature) உயர்த்தியது பதில்களை மேலும் பல்வகைப்பட்டவையாக்கியது; ஆனால் அணிகளைச் சுமார் 1%-க்கு மேல் மேம்படுத்தவில்லை. வெவ்வேறு மாதிரிகளைக் கலந்தது இன்னும் அதிகம் உதவியது: ஒத்த துல்லியம் கொண்ட ஐந்து மாதிரிகள், அவற்றின் சொந்த அணிகளைவிட ஒன்றாகச் சேர்ந்து 6.6% சிறப்பாகச் செயல்பட்டன. ஆனாலும், 15 மாதிரிகளின் எந்தக் கலவையும், மிகத் துல்லியமான ஒற்றை மாதிரியான gpt-oss-20b-இலிருந்து கட்டப்பட்ட அணியைவிடக் குறிப்பிடத்தக்க அளவில் (significantly) மேம்படவில்லை. விடைகள் தெரிந்த கேள்விகளில் கற்றுக்கொள்ளப்பட்ட ஒரு திருத்தம், மாதிரிகளின் ஒட்டுமொத்த ஒருதலைச்சார்பை நீக்கியது; ஆனால் கேள்விக்குக் கேள்வி மாறும் தவறை நீக்கவில்லை.
ஆசிரியர்கள் வரம்புகளை வலியுறுத்துகின்றனர்: மிதமான அளவிலான திறந்த மாதிரிகள், அவற்றின் “சிந்திக்கும்” (thinking) முறைகள் இல்லாமல், இந்த அளவுகோல் தொகுப்புகளிலும் தூண்டுகளிலும் (prompts); முன்னணி (frontier) மாதிரிகளும் பகுத்தறியும் (reasoning) மாதிரிகளும் சோதிக்கப்படவில்லை. அவர்களின் முடிவு ஒரு வடிவமைப்புப் பாடம். மேலும் அதிக முகவர்களையோ, மேலும் அதிக கருத்து வேறுபாட்டையோ சேர்ப்பது, ஒரு மாதிரியின் ஒவ்வொரு நகலும் பகிர்ந்துகொள்ளும் தவறைச் சரிசெய்வதில்லை. அந்தப் பகிரப்பட்ட பிழையை நேரடியாகக் கையாள ஆசிரியர்கள் பரிந்துரைக்கின்றனர் — எடுத்துக்காட்டாக, ஒவ்வொரு கேள்விக்கும் உரிய தகவலை முகவர்களுக்கு வழங்குவதன் மூலம் — அது அவர்கள் இன்னும் சோதிக்காத ஒரு வழி.