三十个AI,同一个错误
群体智慧——论文把这一思想追溯到1907年的高尔顿——是说:把许多独立的猜测取平均,误差就会相互抵消。如果误差无偏且相互独立,平均值的误差会按猜测次数平方根的倒数缩小。许多组合多个AI语言模型的系统——无论是采样后投票、辩论,还是由不同模型组成委员会——都依赖这一论证:更大的团队可以代替更好的智能体。
卢布尔雅那约瑟夫·斯特凡研究所的Carolina Fortuna和Blaž Bertalanič指出,这个论证的好坏取决于它的前提,于是着手检验这些前提。
用费米问题当试验台
费米问题询问的是只能估算的数量,比如一个容器里能装下多少个物体。它们的答案是跨越许多数量级的数字,因此误差可以用数量级来衡量——相差十倍算一个数量级——而符号相反的误差也确实可以相互抵消。
团队从15个开放权重模型(open-weight models)收集了251万个回答,这些模型的参数量从30亿到720亿不等,回答的是realFP基准中的529道题,并在另外两组问题上核对了结果。每个模型对每道题回答约350次,由2到30个回答组成的团队在对数尺度上取平均。
单独来看,这些模型很不擅长这个游戏。单个回答在12%到34%的问题上数量级正确,而在30%到63%的问题上偏差超过一百倍。
每个副本共有的错误
关键的一步是把每个回答的误差拆成两部分。一部分是模型在某道题上犯的错误,它对这道题的所有回答都共有这个错误。另一部分是随回答而变化的随机部分。只有后者能在取平均时抵消。
结果表明,前一部分占主导。在realFP上,它占误差方差的中位数为0.906。给定问题后,同一团队的两个回答互不相关,这符合独立采样的预期;但它们共有同一个错误。
论文用一个称为Kish设计效应(design effect)的经典公式把这一点归结为一个数字:一个由N个回答组成的团队中,独立回答的有效数量为N / (1 + (N − 1)ρ),其中ρ就是那个共有部分的占比。当ρ = 0.906时,由三十个回答组成的团队只相当于1.10个独立智能体。
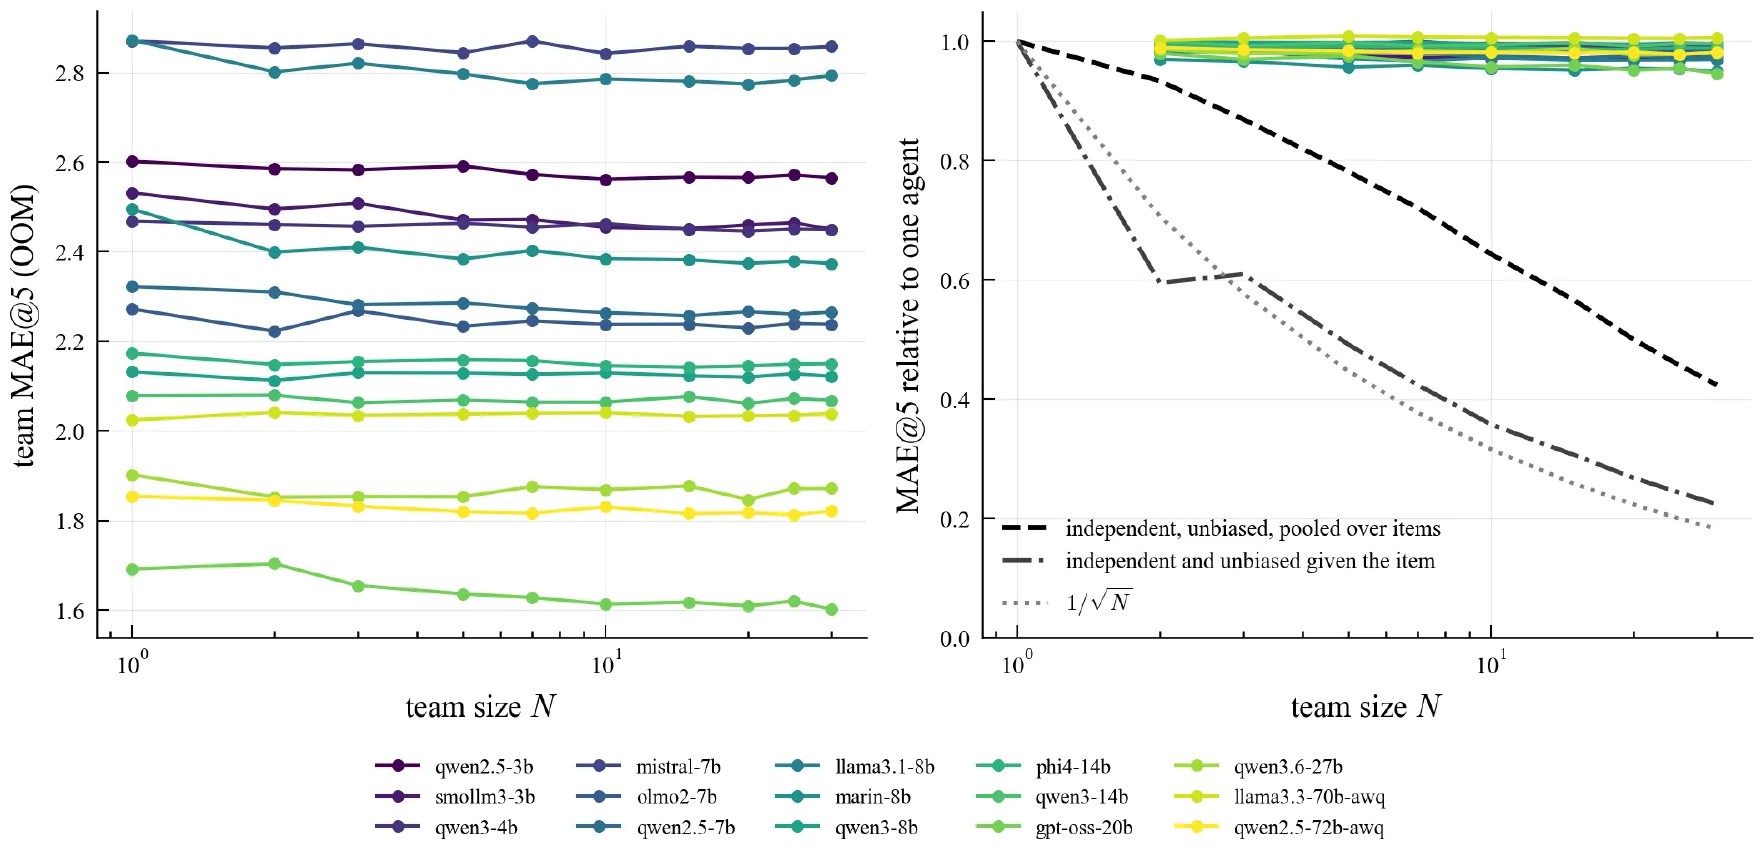
左:15个模型的团队误差随团队规模N的变化。右:相对于单个智能体的同一数据(彩色线,接近1),对比独立且无偏的回答会给出的结果(黑色虚线和点划线)以及1/√N的下降速率(点线)。——图2,Fortuna & Bertalanič(2026),arXiv:2611.16315。
实际上,由三十个回答组成的团队把单个智能体的误差降低的中位数仅为1.7%,最多为5.4%。如果回答彼此独立,并且在每道题上也都不带共有错误,误差本可降低74%到79%。
一切都向100万靠拢
共有错误中有一部分具有可辨认的形态。每个模型都高估小的数量、低估大的数量,把估计值向约100万(10⁶)压缩。这一趋势在全部15个模型中都出现,但它只能解释共有误差的中位数17%。这些模型还会在相同的问题上朝相同方向出错:在压制极端情况并去除向100万靠拢的趋势后,两个不同模型的逐题误差之间的相关系数仍为0.60到0.69。
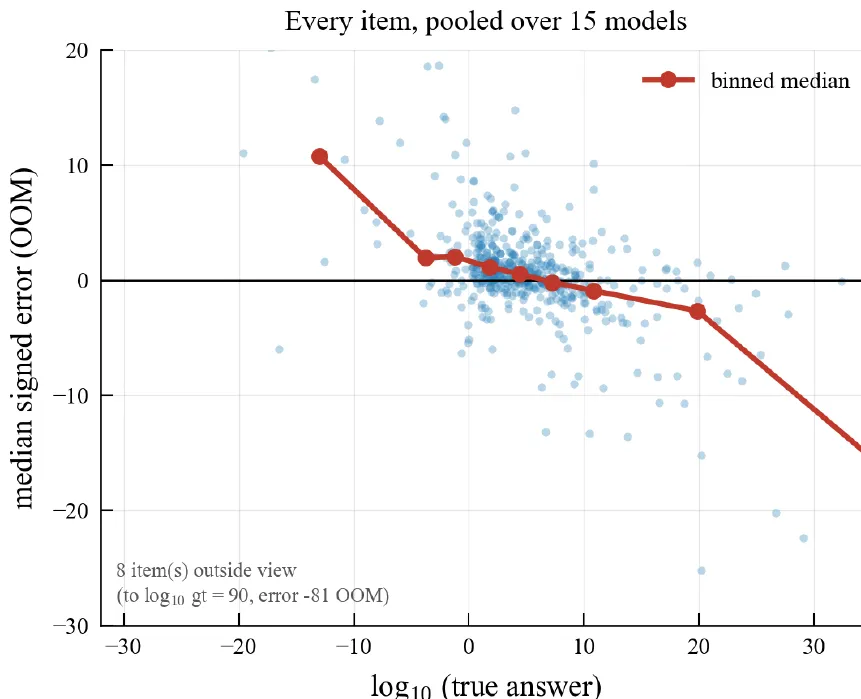
15个模型在每道题上的中位误差,对比真实答案(10的幂):小的数量被高估,大的数量被低估。——图1(左),Fortuna & Bertalanič(2026),arXiv:2611.16315。
商量一下也没用
如果让智能体讨论呢?在三轮辩论中,每个智能体都能看到队友的回答并加以修改。五个智能体组成的团队内部的分散程度缩小了93%——到第三轮时,对15个模型中的12个而言,在至少一半的问题上,五个智能体中有三个给出了同一个数字。但共有的错误纹丝不动,总收益只有2.1%,计算成本却是十五倍。那些只修改自己的回答、不看同伴的智能体,表现至少一样好。
稍有帮助的做法
提高采样温度让回答更加多样,但对团队的改进不超过约1%。混合不同模型帮助更大:五个精度相近的模型合在一起,比它们各自的团队好6.6%。然而,15个模型的任何混合都没有显著胜过由最准确的单个模型gpt-oss-20b组成的团队。在已知答案的问题上学到的校正消除了模型的总体偏差,却消除不了逐题的错误。
作者强调了研究的局限:规模适中的开放模型,未开启“思考”模式,只在这些基准和提示词上测试;前沿模型和推理模型没有测试。他们的结论是一条设计上的教训。增加更多智能体或更多分歧,并不能修正一个模型的每个副本都共有的错误。作者建议直接针对这种共有误差,例如给智能体提供每道题特有的信息——这条路径他们尚未测试。