तीस AI, एक ही ग़लती
भीड़ की बुद्धिमत्ता, एक विचार जिसे शोधपत्र 1907 में गैल्टन तक ले जाता है, कहती है: कई स्वतंत्र अनुमानों का औसत लीजिए, और त्रुटियाँ एक-दूसरे को काट देंगी। अगर त्रुटियाँ पूर्वाग्रह-रहित और स्वतंत्र हों, तो औसत की त्रुटि अनुमानों की संख्या के वर्गमूल के व्युत्क्रम की तरह घटती है। कई AI भाषा मॉडलों को मिलाने वाली बहुत-सी प्रणालियाँ — चाहे नमूना लेकर मतदान से, बहस से, या अलग-अलग मॉडलों की समितियों से — इसी तर्क पर टिकी हैं: एक बड़ी टीम एक बेहतर एजेंट की जगह ले सकती है।
ल्यूब्लियाना के जोज़ेफ़ स्टेफ़ान संस्थान के Carolina Fortuna और Blaž Bertalanič का कहना है कि यह तर्क उतना ही अच्छा है जितनी उसकी मान्यताएँ, और उन्होंने इन मान्यताओं को परखने का बीड़ा उठाया।
परीक्षण-मंच के रूप में फ़र्मी प्रश्न
फ़र्मी प्रश्न ऐसी मात्राएँ पूछते हैं जिनका केवल अनुमान लगाया जा सकता है, जैसे किसी पात्र में कितनी वस्तुएँ समा सकती हैं। उनके उत्तर कई परिमाण-कोटियों में फैली संख्याएँ होते हैं, इसलिए त्रुटि को परिमाण-कोटियों (orders of magnitude) में मापा जा सकता है — दस गुने का अंतर एक गिना जाता है — और विपरीत चिह्न वाली त्रुटियाँ सचमुच एक-दूसरे को काट सकती हैं।
टीम ने 15 खुले-भार वाले मॉडलों (open-weight models) से, जो 3 से 72 अरब पैरामीटर तक के थे, realFP बेंचमार्क के 529 प्रश्नों पर 2.51 मिलियन उत्तर इकट्ठे किए, और परिणामों को प्रश्नों के दो अन्य समूहों पर जाँचा। हर मॉडल ने हर प्रश्न का लगभग 350 बार उत्तर दिया, और 2 से 30 उत्तरों की टीमों का औसत लघुगणकीय पैमाने पर लिया गया।
अपने दम पर ये मॉडल इस खेल में कमज़ोर हैं। एक अकेला उत्तर 12 से 34% प्रश्नों पर सही परिमाण-कोटि का होता है, और 30 से 63% प्रश्नों पर सौ गुने से भी ज़्यादा भटका होता है।
वह त्रुटि जो हर प्रति में साझा है
मुख्य कदम हर उत्तर की त्रुटि को दो हिस्सों में बाँटना है। एक हिस्सा वह ग़लती है जो कोई मॉडल किसी ख़ास प्रश्न पर करता है, जो उस प्रश्न के उसके सभी उत्तरों में साझा होती है। दूसरा यादृच्छिक हिस्सा है जो एक उत्तर से दूसरे उत्तर में बदलता है। औसत लेने पर केवल दूसरा हिस्सा कट सकता है।
पता चलता है कि पहला हिस्सा हावी है। realFP पर यह त्रुटि-प्रसरण का माध्यिका 0.906 हिस्सा है। प्रश्न दिए होने पर, एक ही टीम के दो उत्तर असहसंबद्ध होते हैं, जैसा स्वतंत्र नमूनाकरण से अपेक्षित है; पर वे एक ही ग़लती साझा करते हैं।
शोधपत्र इसे किश के डिज़ाइन प्रभाव (design effect) नामक एक क्लासिक सूत्र से एक अकेली संख्या में बदलता है: N उत्तरों की टीम में स्वतंत्र उत्तरों की प्रभावी संख्या N / (1 + (N − 1)ρ) है, जहाँ ρ वही साझा हिस्सा है। ρ = 0.906 के साथ तीस की टीम 1.10 स्वतंत्र एजेंटों के बराबर है।
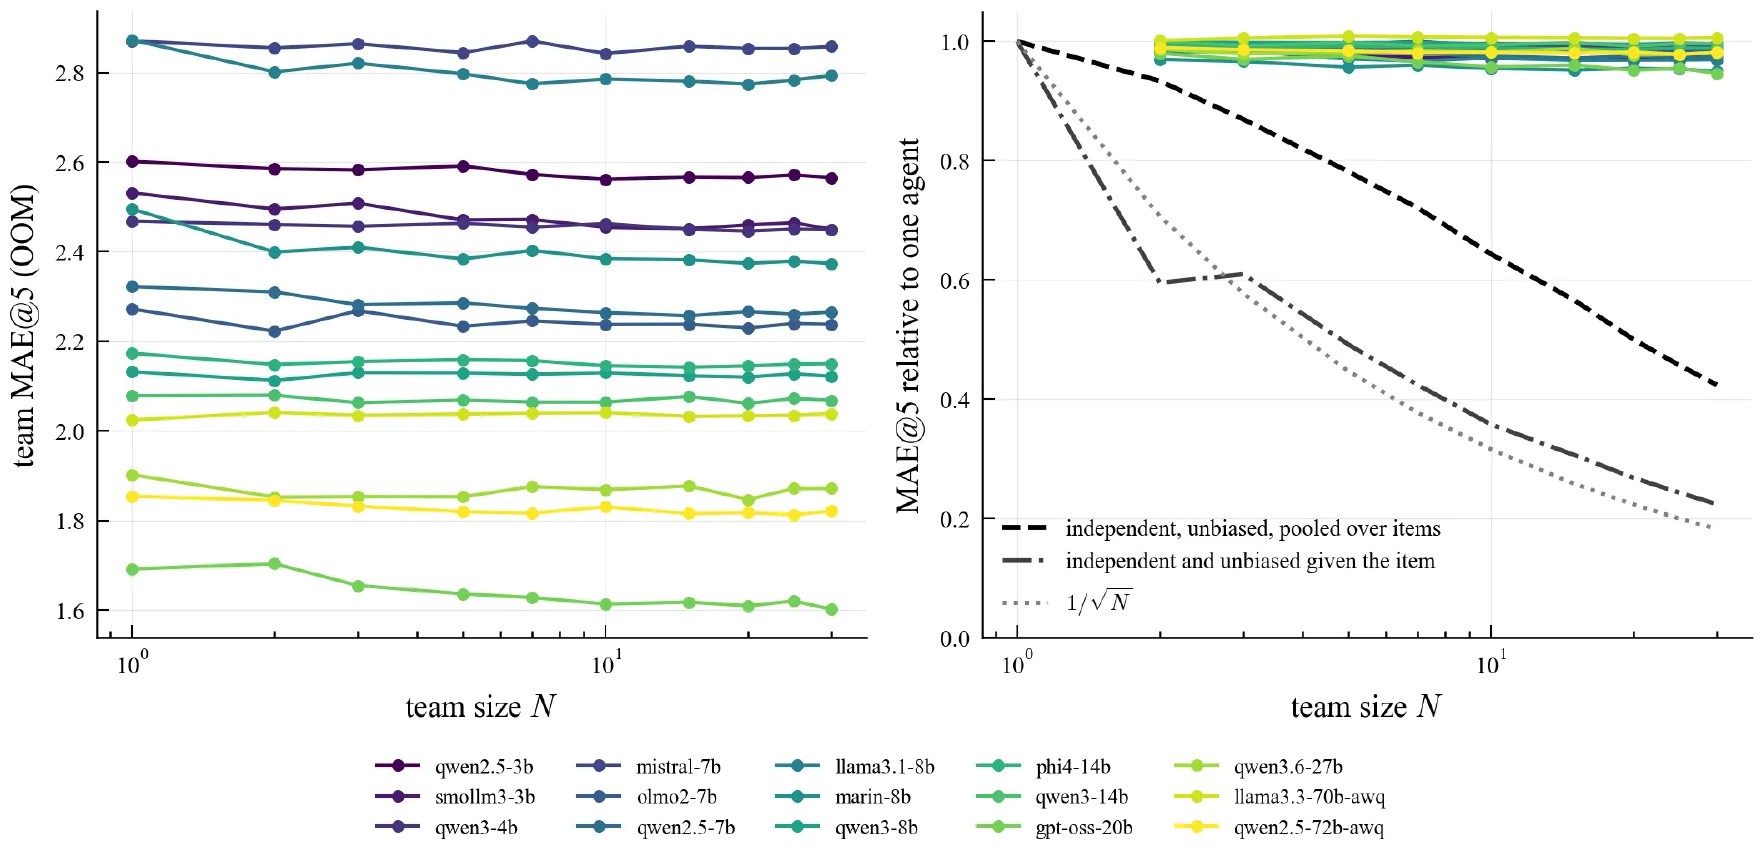
बाएँ: 15 मॉडलों के लिए टीम-त्रुटि बनाम टीम का आकार N। दाएँ: वही एक अकेले एजेंट के सापेक्ष (रंगीन रेखाएँ, 1 के पास), उसके मुक़ाबले जो स्वतंत्र और पूर्वाग्रह-रहित उत्तर देते (काली खंडित और डैश-डॉट रेखाएँ) और 1/√N दर (बिंदुदार)। — चित्र 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
व्यवहार में, तीस की टीमों ने एक अकेले एजेंट की त्रुटि को माध्यिका के रूप में केवल 1.7% घटाया, और अधिकतम 5.4%। ऐसे स्वतंत्र उत्तर, जिनमें हर प्रश्न पर कोई साझा ग़लती भी न होती, इसे 74 से 79% तक घटा देते।
सब कुछ एक मिलियन की ओर खिसकता है
साझा ग़लती के एक हिस्से का एक पहचाना जा सकने वाला आकार है। हर मॉडल छोटी मात्राओं को बढ़ाकर और बड़ी मात्राओं को घटाकर आँकता है, अपने अनुमानों को लगभग एक मिलियन (10⁶) की ओर सिकोड़ता है। यह प्रवृत्ति सभी 15 मॉडलों में दिखती है, पर यह साझा त्रुटि का केवल माध्यिका 17% ही समझाती है। मॉडल एक ही प्रश्नों पर एक ही दिशा में ग़लती भी करते हैं: चरम मामलों को क़ाबू करने और एक मिलियन की ओर खिसकाव को हटाने के बाद भी दो अलग-अलग मॉडलों की प्रति-प्रश्न त्रुटियाँ 0.60 से 0.69 पर सहसंबद्ध रहती हैं।
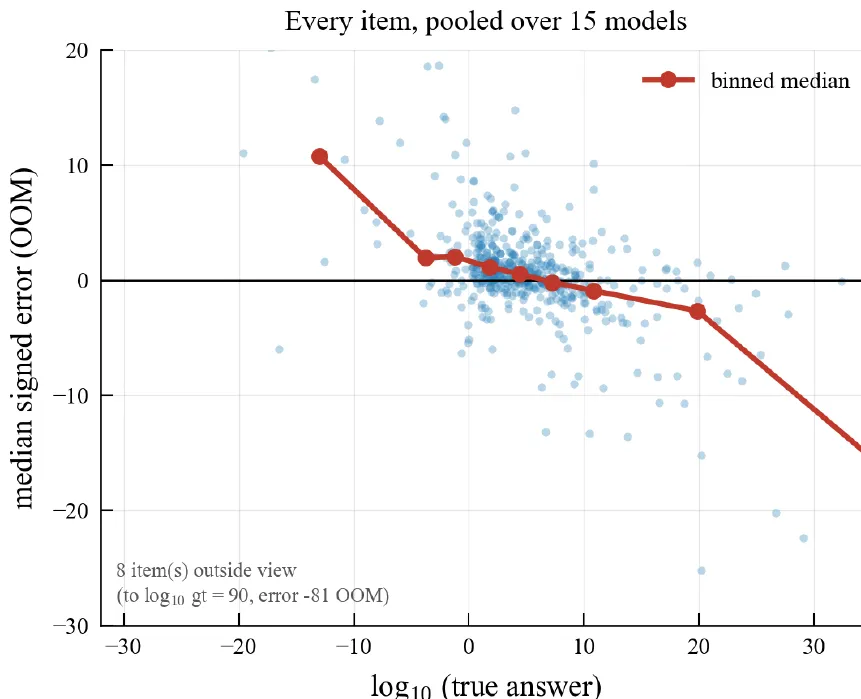
हर प्रश्न पर 15 मॉडलों की माध्यिका त्रुटि, सही उत्तर (दस की घातें) के विरुद्ध: छोटी मात्राएँ बढ़ाकर आँकी जाती हैं, बड़ी मात्राएँ घटाकर। — चित्र 1 (बाएँ), Fortuna & Bertalanič (2026), arXiv:2611.16315.
बात करने से मदद नहीं मिलती
अगर एजेंट चर्चा करें तो? बहस के तीन दौरों में हर एजेंट ने अपने साथियों के उत्तर देखे और अपना उत्तर संशोधित किया। पाँच की टीमों के भीतर का फैलाव 93% सिकुड़ गया — तीसरे दौर तक, 15 में से 12 मॉडलों के लिए, कम से कम आधे प्रश्नों पर पाँच में से तीन एजेंटों ने एक ही संख्या दी। पर साझा ग़लती टस से मस नहीं हुई, और कुल लाभ 2.1% रहा, पंद्रह गुनी कंप्यूटिंग लागत पर। जिन एजेंटों ने साथियों को देखे बिना केवल अपना उत्तर संशोधित किया, उन्होंने कम से कम उतना ही अच्छा किया।
जिससे थोड़ी मदद मिली
नमूना-तापमान बढ़ाने से उत्तर ज़्यादा विविध हुए, पर टीमों में लगभग 1% से ज़्यादा सुधार नहीं हुआ। अलग-अलग मॉडलों को मिलाने से ज़्यादा मदद मिली: मिलती-जुलती सटीकता वाले पाँच मॉडलों ने साथ मिलकर अपनी-अपनी टीमों से 6.6% बेहतर किया। फिर भी 15 मॉडलों का कोई भी मिश्रण अकेले सबसे सटीक मॉडल, gpt-oss-20b, से बनी टीम से उल्लेखनीय रूप से बेहतर नहीं हुआ। ज्ञात उत्तरों वाले प्रश्नों पर सीखा गया एक सुधार मॉडलों का समग्र पूर्वाग्रह हटा देता था, पर प्रश्न-दर-प्रश्न की ग़लती नहीं।
लेखक सीमाओं पर ज़ोर देते हैं: मामूली आकार के खुले मॉडल, उनके “सोचने” वाले मोड के बिना, इन बेंचमार्कों और प्रॉम्प्ट पर; अग्रणी और तर्क करने वाले मॉडल नहीं परखे गए। उनका निष्कर्ष डिज़ाइन का एक सबक़ है। ज़्यादा एजेंट, या ज़्यादा असहमति, जोड़ने से वह ग़लती ठीक नहीं होती जो किसी मॉडल की हर प्रति में साझा है। लेखक उस साझा त्रुटि पर सीधे प्रहार करने का सुझाव देते हैं, उदाहरण के लिए एजेंटों को हर प्रश्न से जुड़ी विशिष्ट जानकारी देकर — एक ऐसा रास्ता जिसे उन्होंने अभी तक परखा नहीं है।