AKILI BANDIA THELATHINI, KOSA MOJA
Hekima ya umati, wazo ambalo makala inalifuatilia hadi kwa Galton mwaka 1907, inasema: chukua wastani wa makisio mengi huru, na makosa yatafutana. Kama makosa hayana upendeleo na ni huru, kosa la wastani hupungua kama moja juu ya kipeuo cha pili cha idadi ya makisio. Mifumo mingi inayounganisha modeli kadhaa za lugha za akili bandia — kwa kuchukua sampuli na kupiga kura, kwa mjadala, au kwa kamati za modeli tofauti — inategemea hoja hii: timu kubwa zaidi inaweza kuchukua nafasi ya wakala bora zaidi.
Carolina Fortuna na Blaž Bertalanič, katika Taasisi ya Jožef Stefan huko Ljubljana, wanaonyesha kwamba hoja hiyo ni nzuri tu kadiri misingi yake ilivyo nzuri, na walianza kuijaribu misingi hiyo.
Maswali ya Fermi kama benchi la majaribio
Maswali ya Fermi huuliza viwango vinavyoweza kukadiriwa tu, kama vile ni vitu vingapi vinavyotoshea ndani ya chombo. Majibu yao ni namba zinazoenea katika ngazi nyingi za ukubwa, kwa hiyo kosa linaweza kupimwa kwa ngazi za ukubwa — kipengele cha kumi kinahesabiwa kama moja — na makosa ya ishara kinyume yanaweza kufutana kweli.
Timu ilikusanya majibu milioni 2.51 kutoka kwa modeli 15 zenye uzani wazi (open-weight models), kuanzia vigezo bilioni 3 hadi 72, kwa maswali 529 ya kipimo-linganishi cha realFP, na ikakagua matokeo kwa seti nyingine mbili za maswali. Kila modeli ilijibu kila swali karibu mara 350, na timu za majibu 2 hadi 30 zilichukuliwa wastani kwenye kipimo cha logariti.
Zenyewe peke yake, modeli ni dhaifu katika mchezo huu. Jibu moja lina ngazi sahihi ya ukubwa kwa 12 hadi 34% ya maswali, na limekosea kwa zaidi ya kipengele cha mia kwa 30 hadi 63%.
Kosa ambalo kila nakala inashiriki
Hatua muhimu ni kugawanya kosa la kila jibu katika sehemu mbili. Moja ni kosa ambalo modeli hufanya kwa swali fulani, linaloshirikiwa na majibu yake yote kwa swali hilo. Nyingine ni sehemu ya nasibu inayobadilika kutoka jibu moja hadi jingine. Ni ya pili pekee inayoweza kufutika majibu yanapochukuliwa wastani.
Inabainika kwamba sehemu ya kwanza ndiyo inayotawala. Kwenye realFP, inachukua wastani wa kati wa 0.906 ya tofauti ya kosa. Swali likishajulikana, majibu mawili kutoka timu moja hayana uhusiano, kama sampuli huru inavyomaanisha; lakini yanashiriki kosa lilelile.
Makala inageuza hili kuwa namba moja, kwa fomula ya kawaida inayojulikana kama athari ya muundo ya Kish (design effect): idadi halisi ya majibu huru katika timu ya N ni N / (1 + (N − 1)ρ), ambapo ρ ni sehemu hiyo inayoshirikiwa. Kwa ρ = 0.906, timu ya thelathini ina thamani ya mawakala huru 1.10.
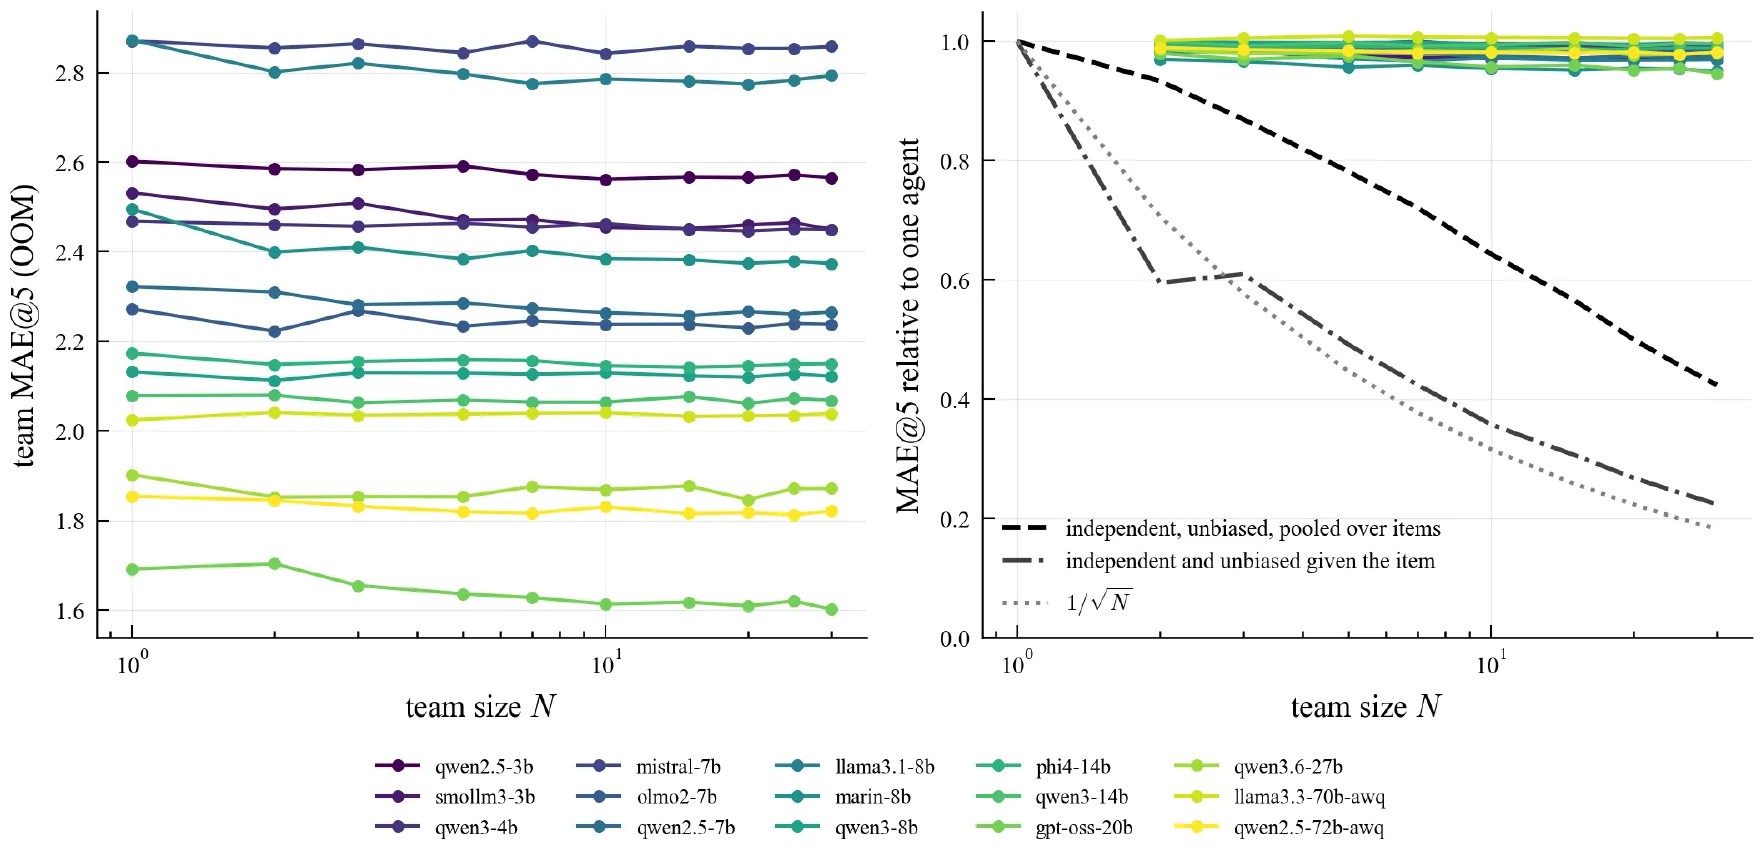
Kushoto: kosa la timu dhidi ya ukubwa wa timu N kwa modeli 15. Kulia: hilohilo likilinganishwa na wakala mmoja (mistari ya rangi, karibu na 1), dhidi ya kile ambacho majibu huru na yasiyo na upendeleo yangetoa (mistari myeusi ya vistari na ya kistari-nukta) na kiwango cha 1/√N (nukta). — Kielelezo 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
Kwa vitendo, timu za thelathini zilipunguza kosa la wakala mmoja kwa wastani wa kati wa 1.7%, na kwa kiwango cha juu 5.4%. Majibu huru ambayo pia yasingebeba kosa lolote linaloshirikiwa kwa kila swali yangelipunguza kwa 74 hadi 79%.
Kila kitu kinaelea kuelekea milioni moja
Sehemu ya kosa linaloshirikiwa ina umbo linalotambulika. Kila modeli hukadiria kupita kiasi viwango vidogo na kukadiria chini viwango vikubwa, ikibana makadirio yake kuelekea karibu milioni moja (10⁶). Mwelekeo huu unaonekana katika modeli zote 15, lakini unaeleza wastani wa kati wa 17% tu ya kosa linaloshirikiwa. Modeli pia hukosea kwa maswali yaleyale katika mwelekeo uleule: makosa ya kila swali ya modeli mbili tofauti bado yanahusiana kwa 0.60 hadi 0.69 mara visa vya kupindukia vinapodhibitiwa na mwelekeo kuelekea milioni moja unapoondolewa.
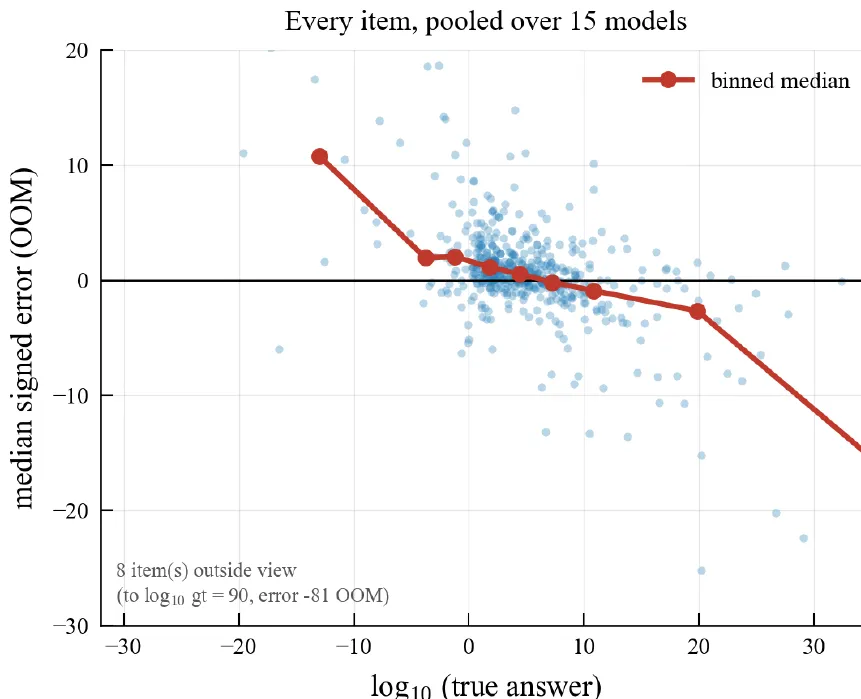
Kosa la wastani wa kati la modeli 15 kwa kila swali, dhidi ya jibu sahihi (vipeo vya kumi): viwango vidogo vinakadiriwa kupita kiasi, vikubwa vinakadiriwa chini. — Kielelezo 1 (kushoto), Fortuna & Bertalanič (2026), arXiv:2611.16315.
Kujadiliana hakusaidii
Je, mawakala wakijadiliana? Katika duru tatu za mjadala, kila wakala aliona majibu ya wenzake wa timu na kurekebisha. Mtawanyiko ndani ya timu za watano uliporomoka kwa 93% — kufikia duru ya tatu, kwa modeli 12 kati ya 15, mawakala watatu kati ya watano walitoa namba ileile kwa angalau nusu ya maswali. Lakini kosa linaloshirikiwa halikusogea, na faida ya jumla ilikuwa 2.1%, kwa gharama ya ukokotoaji mara kumi na tano. Mawakala waliorekebisha tu majibu yao wenyewe, bila kuona ya wenzao, walifanya vizuri angalau kwa kiwango kilekile.
Kilichosaidia kidogo
Kuongeza joto la uchukuaji sampuli kulifanya majibu kuwa ya aina mbalimbali zaidi bila kuboresha timu kwa zaidi ya karibu 1%. Kuchanganya modeli tofauti kulisaidia zaidi: modeli tano zenye usahihi unaofanana zilifanya vizuri zaidi kwa 6.6% zikiwa pamoja kuliko katika timu zao wenyewe. Hata hivyo, hakuna mchanganyiko wowote wa modeli 15 ulioboreka kwa kiasi kikubwa zaidi ya timu iliyojengwa kutoka kwa modeli moja sahihi zaidi, gpt-oss-20b. Marekebisho yaliyojifunzwa kwa maswali yenye majibu yanayojulikana yaliondoa upendeleo wa jumla wa modeli, lakini si kosa la swali kwa swali.
Waandishi wanasisitiza mipaka: modeli za wazi za ukubwa wa wastani, bila hali zao za “kufikiri” (thinking), kwa vipimo-linganishi na maelekezo haya; modeli za kisasa kabisa na za kufikiri kimantiki hazikujaribiwa. Hitimisho lao ni somo la usanifu. Kuongeza mawakala zaidi, au kutokubaliana zaidi, hakurekebishi kosa ambalo kila nakala ya modeli inashiriki. Waandishi wanapendekeza kushambulia kosa hilo linaloshirikiwa moja kwa moja, kwa mfano kwa kuwapa mawakala taarifa mahususi kwa kila swali — njia ambayo bado hawajaijaribu.