سی هوش مصنوعی، یک اشتباه
خرد جمعی، ایدهای که مقاله ریشهاش را تا گالتون (Galton) در سال 1907 پی میگیرد، میگوید: حدسهای مستقل فراوانی را میانگین بگیرید، و خطاها یکدیگر را خنثی میکنند. اگر خطاها بیسوگیری و مستقل باشند، خطای میانگین به نسبت یک بر ریشهٔ دوم تعداد حدسها کوچک میشود. بسیاری از سامانههایی که چند مدل زبانی هوش مصنوعی را با هم ترکیب میکنند — با نمونهگیری و رأیگیری، با مناظره، یا با کمیتههایی از مدلهای گوناگون — بر این استدلال تکیه دارند: تیمی بزرگتر میتواند جای عاملی بهتر را بگیرد.
کارولینا فورتونا (Carolina Fortuna) و بلاژ برتالانیچ (Blaž Bertalanič)، در مؤسسهٔ یوژف اشتفان (Jožef Stefan Institute) در لیوبلیانا، یادآوری میکنند که این استدلال تنها به اندازهٔ مقدماتش معتبر است، و به آزمودن همین مقدمات پرداختند.
پرسشهای فرمی بهعنوان میدان آزمون
پرسشهای فرمی کمیتهایی را میخواهند که تنها میتوان برآوردشان کرد، مثلاً اینکه چند شیء در یک ظرف جا میگیرد. پاسخ آنها عددهایی است که مرتبههای بزرگی فراوانی را در بر میگیرند، پس خطا را میتوان بر حسب مرتبهٔ بزرگی سنجید — هر ضریب ده یک مرتبه به شمار میآید — و خطاهای با علامت مخالف واقعاً میتوانند یکدیگر را خنثی کنند.
تیم 2.51 میلیون پاسخ از 15 مدل با وزنهای باز (open-weight)، با 3 تا 72 میلیارد پارامتر، به 529 پرسش مجموعهٔ محک realFP گرد آورد و نتایج را روی دو مجموعهٔ دیگر از پرسشها نیز وارسی کرد. هر مدل به هر پرسش حدود 350 بار پاسخ داد، و تیمهایی از 2 تا 30 پاسخ روی مقیاس لگاریتمی میانگین گرفته شدند.
مدلها بهتنهایی در این بازی ضعیفاند. یک پاسخ منفرد تنها در 12 تا 34% پرسشها مرتبهٔ بزرگی درستی دارد، و در 30 تا 63% آنها بیش از ضریب صد با پاسخ درست فاصله دارد.
خطایی که همهٔ نسخهها در آن شریکاند
گام کلیدی این است که خطای هر پاسخ به دو بخش تقسیم شود. یکی اشتباهی است که یک مدل روی پرسشی خاص مرتکب میشود و همهٔ پاسخهایش به آن پرسش در آن شریکاند. دیگری بخش تصادفی است که از پاسخی به پاسخ دیگر تغییر میکند. تنها بخش دوم است که با میانگینگیری میتواند خنثی شود.
معلوم میشود که بخش نخست غالب است. روی realFP، میانهٔ سهم آن از واریانس خطا 0.906 است. با معلوم بودن پرسش، دو پاسخ از یک تیم همبستگی ندارند، همانطور که نمونهگیری مستقل ایجاب میکند؛ اما در همان اشتباه شریکاند.
مقاله این را به یک عدد واحد تبدیل میکند، با فرمولی کلاسیک به نام اثر طرح کیش (Kish’s design effect): تعداد مؤثر پاسخهای مستقل در تیمی از N پاسخ برابر است با N / (1 + (N − 1)ρ)، که در آن ρ همان سهم مشترک است. با ρ = 0.906، تیمی سیتایی به اندازهٔ 1.10 عامل مستقل ارزش دارد.
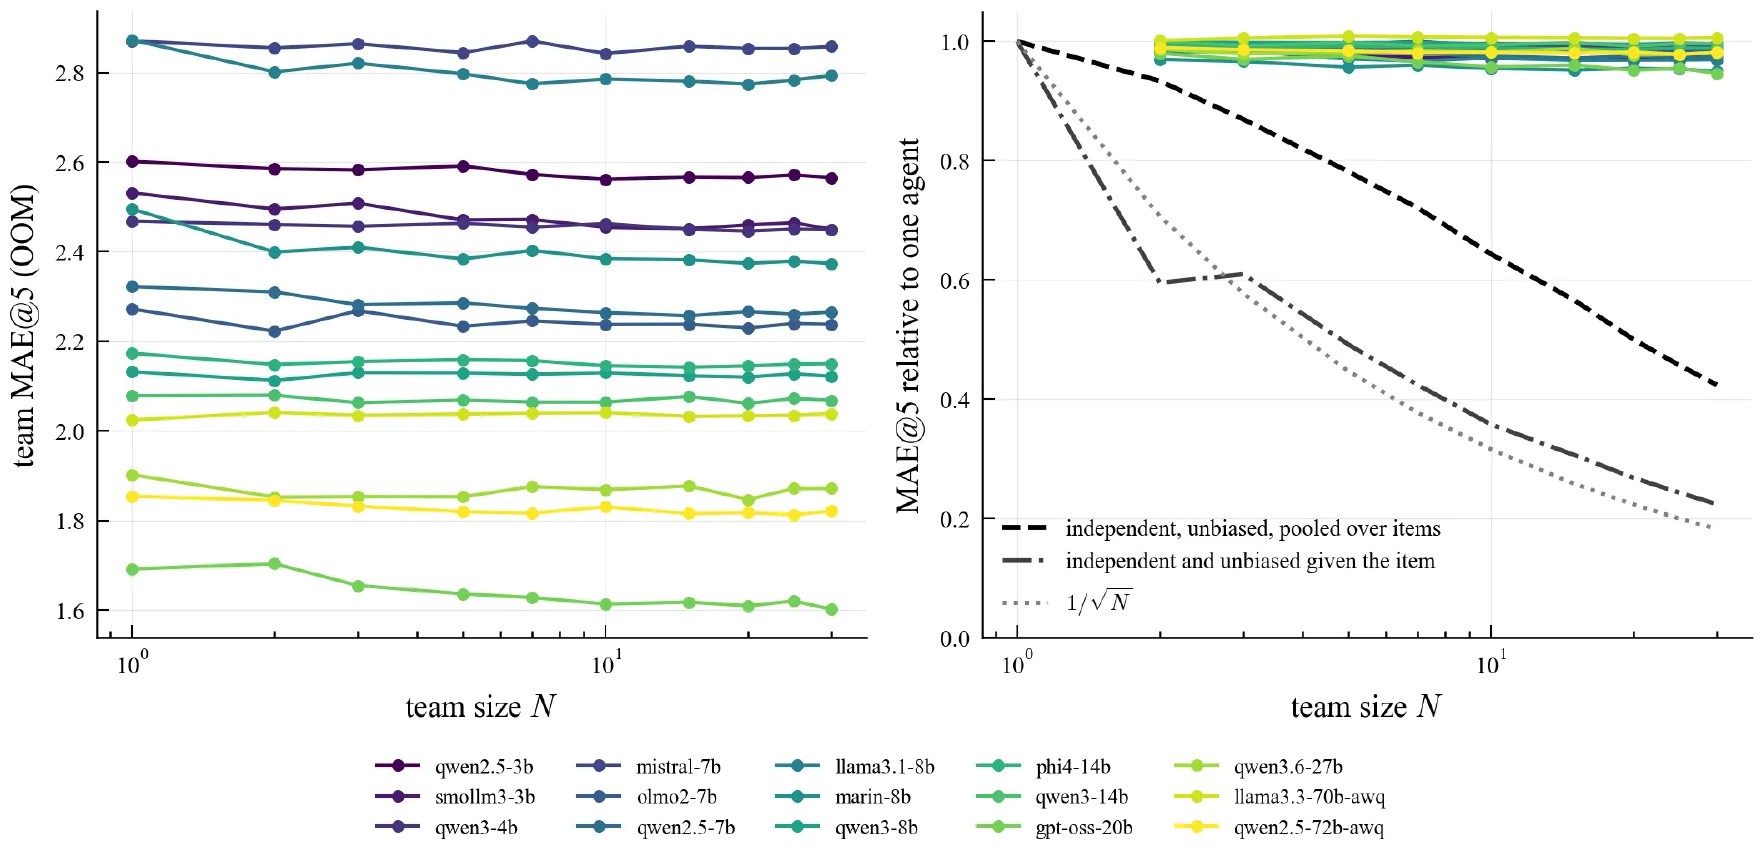
چپ: خطای تیم بر حسب اندازهٔ تیم N برای 15 مدل. راست: همان خطا نسبت به یک عامل منفرد (خطهای رنگی، نزدیک به 1)، در برابر آنچه پاسخهای مستقل و بیسوگیری به دست میدادند (خطچین و خطنقطهچین سیاه) و نرخ 1/√N (نقطهچین). — شکل 2، Fortuna & Bertalanič (2026)، arXiv:2611.16315.
در عمل، تیمهای سیتایی خطای یک عامل منفرد را با میانهٔ 1.7% و حداکثر 5.4% کاهش دادند. پاسخهایی مستقل که افزون بر این روی هر پرسش هیچ اشتباه مشترکی هم نداشتند، آن را 74 تا 79% کم میکردند.
همه چیز به سوی یک میلیون میلغزد
بخشی از اشتباه مشترک شکلی شناختنی دارد. همهٔ مدلها کمیتهای کوچک را بیش از اندازه و کمیتهای بزرگ را کمتر از اندازه برآورد میکنند و برآوردهایشان را به سوی حدود یک میلیون (10⁶) فشرده میکنند. این گرایش در هر 15 مدل دیده میشود، اما تنها میانهٔ 17% از خطای مشترک را توضیح میدهد. مدلها همچنین روی همان پرسشها در همان جهت خطا میکنند: خطاهای دو مدل متفاوت روی هر پرسش، پس از مهار موارد حدی و حذف لغزش به سوی یک میلیون، همچنان با ضریب 0.60 تا 0.69 همبستهاند.
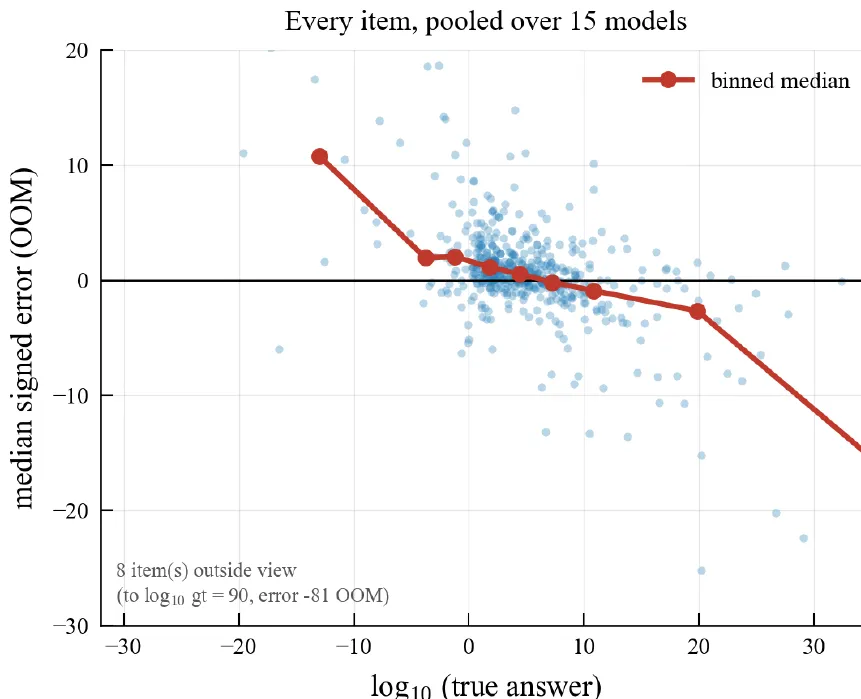
میانهٔ خطای 15 مدل روی هر پرسش، بر حسب پاسخ درست (توانهای ده): کمیتهای کوچک بیشبرآورد و کمیتهای بزرگ کمبرآورد میشوند. — شکل 1 (چپ)، Fortuna & Bertalanič (2026)، arXiv:2611.16315.
گفتوگو کمکی نمیکند
اگر عاملها با هم بحث کنند چه؟ در سه دور مناظره، هر عامل پاسخهای همتیمیهایش را دید و پاسخ خود را بازنگری کرد. پراکندگی درون تیمهای پنجتایی 93% فرو ریخت — تا دور سوم، برای 12 مدل از 15 مدل، سه عامل از پنج عامل دستکم در نیمی از پرسشها عدد یکسانی دادند. اما اشتباه مشترک تکان نخورد، و کل بهبود 2.1% بود، با پانزده برابر هزینهٔ محاسباتی. عاملهایی که صرفاً پاسخ خود را بازنگری کردند، بیآنکه پاسخ همتایانشان را ببینند، دستکم به همان خوبی عمل کردند.
آنچه اندکی کمک کرد
بالا بردن دمای نمونهگیری پاسخها را متنوعتر کرد، بیآنکه تیمها را بیش از حدود 1% بهتر کند. ترکیب مدلهای متفاوت بیشتر کمک کرد: پنج مدل با دقت مشابه در کنار هم 6.6% بهتر از تیمهای خودشان عمل کردند. با این حال هیچ ترکیبی از 15 مدل بهطور معناداری از تیمی که تنها از دقیقترین مدل، gpt-oss-20b، ساخته شده بود بهتر نشد. تصحیحی که روی پرسشهایی با پاسخ معلوم آموخته شد سوگیری کلی مدلها را از میان برد، اما اشتباه پرسشبهپرسش را نه.
نویسندگان بر محدودیتها تأکید میکنند: مدلهای باز با اندازهٔ متوسط، بدون حالتهای «تفکر» آنها، روی همین مجموعههای محک و همین پرامپتها؛ مدلهای پیشرو و مدلهای استدلالی آزموده نشدند. نتیجهگیری آنها درسی دربارهٔ طراحی است. افزودن عاملهای بیشتر، یا اختلافنظر بیشتر، اشتباهی را که همهٔ نسخههای یک مدل در آن شریکاند برطرف نمیکند. نویسندگان پیشنهاد میکنند که مستقیماً به همین خطای مشترک پرداخته شود، برای نمونه با دادن اطلاعاتی خاصِ هر پرسش به عاملها — راهی که هنوز آن را نیازمودهاند.