TRENTE IA, UNE SEULE ERREUR
La sagesse des foules, une idée que l’article fait remonter à Galton en 1907, dit ceci : faites la moyenne de nombreuses estimations indépendantes, et les erreurs se compensent. Si les erreurs sont sans biais (en moyenne, elles ne penchent ni vers le haut ni vers le bas) et indépendantes, l’erreur de la moyenne diminue comme un sur la racine carrée du nombre d’estimations. Beaucoup de systèmes qui combinent plusieurs modèles de langage — par tirages et vote, par débat ou par comités de modèles différents — s’appuient sur cet argument : une équipe plus grande peut remplacer un meilleur agent.
Carolina Fortuna et Blaž Bertalanič, de l’Institut Jožef Stefan à Ljubljana, rappellent que l’argument ne vaut que ce que valent ses prémisses, et entreprennent de les tester.
Les questions de Fermi comme banc d’essai
Les questions de Fermi portent sur des quantités qu’on ne peut qu’estimer, par exemple le nombre d’objets que contient un récipient. Leurs réponses s’étalent sur de nombreux ordres de grandeur ; on peut donc mesurer une erreur en ordres de grandeur — un facteur dix compte pour un — et des erreurs de signes opposés peuvent réellement se compenser.
L’équipe a recueilli 2,51 millions de réponses de 15 modèles à poids ouverts (dont les paramètres entraînés sont publiés), de 3 à 72 milliards de paramètres, aux 529 questions du banc d’essai realFP, et a vérifié les résultats sur deux autres jeux de questions. Chaque modèle a répondu environ 350 fois à chaque question, et des équipes de 2 à 30 réponses ont été moyennées sur une échelle logarithmique, c’est-à-dire en faisant la moyenne de leurs ordres de grandeur plutôt que des nombres bruts.
Seuls, les modèles sont mauvais à ce jeu. Une réponse isolée a le bon ordre de grandeur sur 12 à 34 % des questions, et se trompe de plus d’un facteur cent sur 30 à 63 %.
L’erreur que partagent toutes les copies
L’étape clé consiste à couper l’erreur de chaque réponse en deux. D’un côté, l’erreur qu’un modèle commet sur une question donnée, partagée par toutes ses réponses à cette question. De l’autre, la part aléatoire qui varie d’une réponse à l’autre. Seule la seconde peut se compenser quand on fait la moyenne.
C’est la première qui domine. Sur realFP, elle représente en médiane 0,906 — environ les neuf dixièmes — de la variance de l’erreur, une mesure de la dispersion des erreurs. Sur une question donnée, les parts aléatoires de deux réponses d’une même équipe n’ont aucun lien, comme le veut un tirage indépendant ; ce qui les relie, c’est l’erreur qu’elles partagent.
L’article résume cela en un seul nombre, avec une formule classique appelée effet de plan de Kish : le nombre effectif de réponses indépendantes dans une équipe de N vaut N / (1 + (N − 1)ρ), où ρ est cette part partagée. Avec ρ = 0,906, une équipe de trente vaut 1,10 agent indépendant.
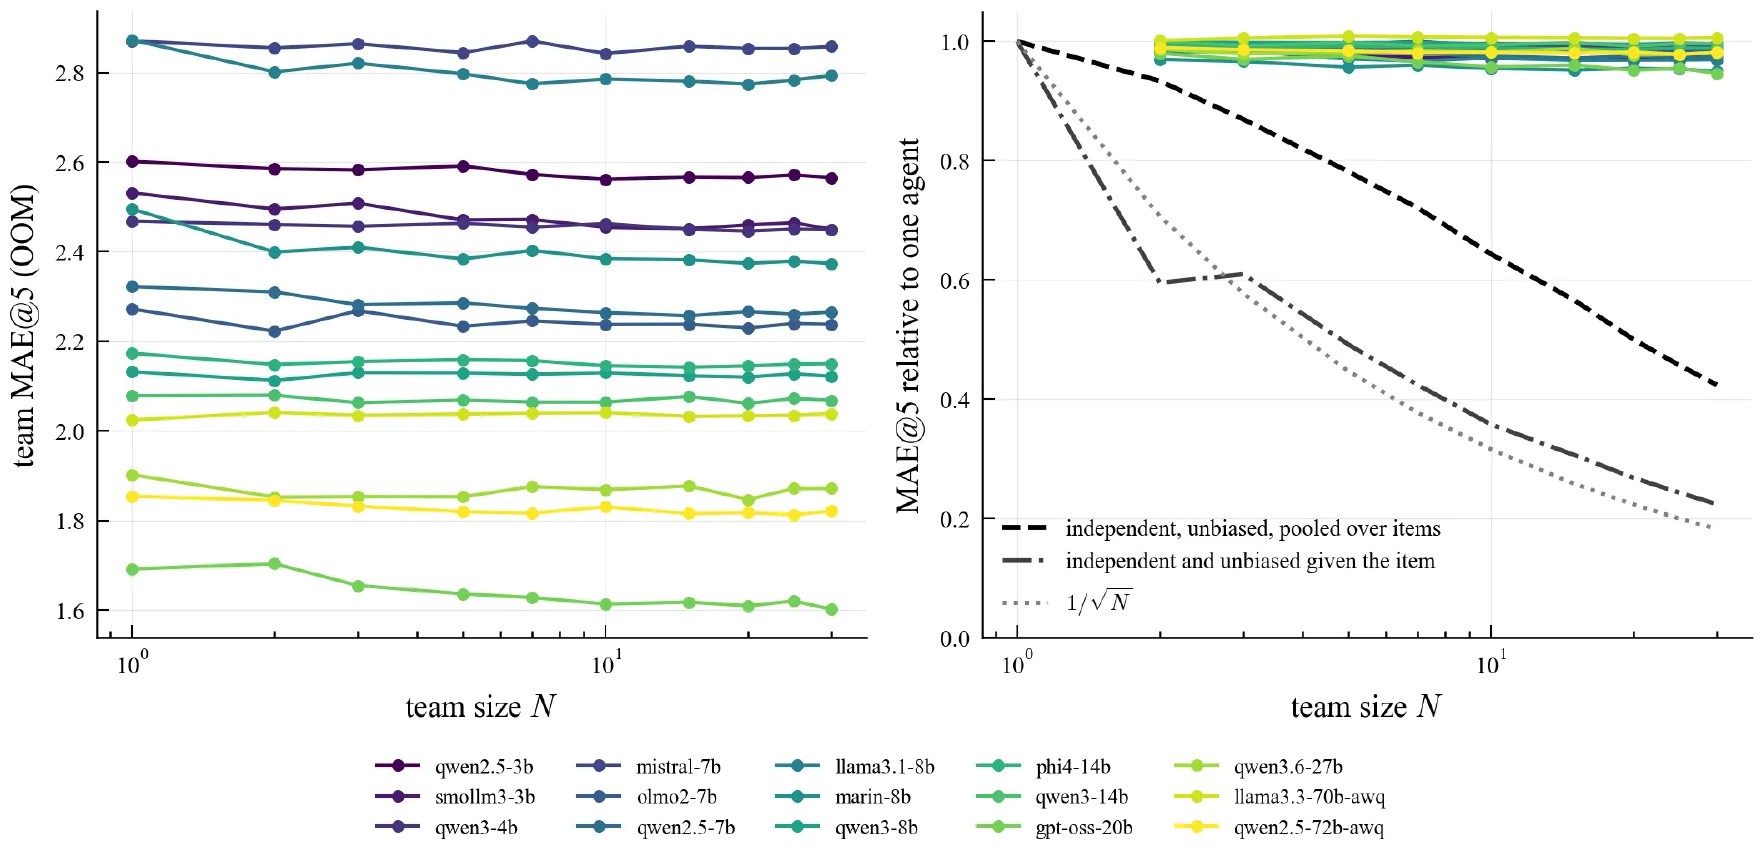
À gauche : erreur d’équipe en fonction de la taille d’équipe N pour 15 modèles. À droite : la même rapportée à un agent seul (lignes colorées, près de 1), comparée à ce que donneraient des réponses indépendantes et sans biais (tirets et tirets-points noirs) et à la loi en 1/√N (pointillés). — Figure 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
Concrètement, les équipes de trente ont réduit l’erreur d’un agent seul de 1,7 % en médiane, et de 5,4 % au plus. Des réponses indépendantes et, en plus, sans erreur commune sur chaque question l’auraient réduite de 74 à 79 %.
Tout dérive vers le million
Une partie de l’erreur partagée a une forme reconnaissable. Tous les modèles surestiment les petites quantités et sous-estiment les grandes, en comprimant leurs estimations vers environ un million (10⁶). Cette tendance se retrouve chez les 15 modèles, mais elle n’explique qu’une médiane de 17 % de l’erreur partagée. Les modèles se trompent aussi sur les mêmes questions, dans le même sens : les erreurs par question de deux modèles différents restent corrélées de 0,60 à 0,69 une fois les cas extrêmes neutralisés et la dérive vers le million retirée.
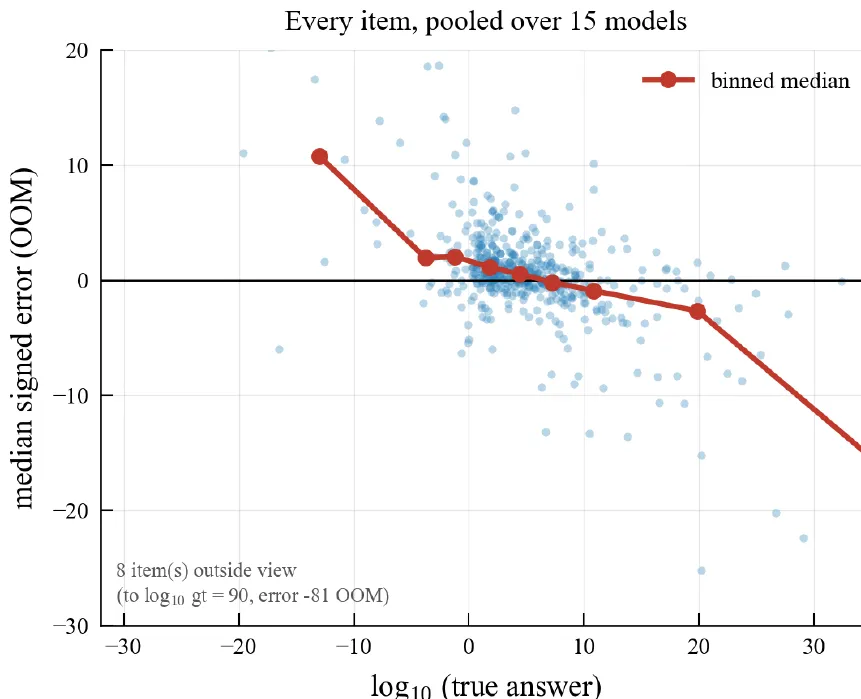
Erreur médiane des 15 modèles sur chaque question, en fonction de la vraie réponse (puissances de dix) : les petites quantités sont surestimées, les grandes sous-estimées. — Figure 1 (gauche), Fortuna & Bertalanič (2026), arXiv:2611.16315.
En discuter n’aide pas
Et si les agents discutaient ? En trois rondes de débat, chaque agent voyait les réponses de ses coéquipiers et révisait la sienne. L’écart au sein des équipes de cinq s’est effondré de 93 % — à la troisième ronde, pour 12 des 15 modèles, trois agents sur cinq donnaient le même nombre sur au moins la moitié des questions. Mais l’erreur partagée n’a pas bougé, et le gain total était de 2,1 %, pour quinze fois le coût de calcul. Des agents qui révisaient simplement leur propre réponse, sans voir leurs pairs, ont fait au moins aussi bien.
Ce qui a un peu aidé
Augmenter la température d’échantillonnage — le réglage qui dose la part de hasard dans chaque réponse — a rendu les réponses plus variées sans améliorer les équipes de plus d’environ 1 %. Mélanger des modèles différents a davantage aidé : cinq modèles de précision voisine ont fait 6,6 % mieux ensemble que dans leurs propres équipes. Mais aucun mélange des 15 modèles n’a fait significativement mieux qu’une équipe formée du seul modèle le plus précis, gpt-oss-20b. Une correction apprise sur des questions à réponse connue a supprimé le biais global des modèles, mais pas l’erreur question par question.
Les auteurs soulignent les limites : des modèles ouverts de taille modeste, sans leurs modes de « réflexion », sur ces bancs d’essai et ces consignes ; les modèles de pointe et de raisonnement n’ont pas été testés. Leur conclusion est une leçon de conception. Ajouter des agents, ou du désaccord, ne corrige pas une erreur que partagent toutes les copies d’un modèle. Les auteurs proposent de s’attaquer directement à cette erreur partagée, par exemple en donnant aux agents des informations propres à chaque question — une piste encore non testée.