AI-এর ভেতরে তালাবন্ধ একটি দক্ষতা, যা টেনে বের করার কোনো উপায় নেই
একটি শক্তিশালী AI মডেল প্রকাশের আগে এর নির্মাতারা সক্ষমতা অডিট চালান: তাঁরা বিপজ্জনক সক্ষমতা বের করে আনার চেষ্টা করেন — যেমন রাসায়নিক, জৈবিক, তেজস্ক্রিয় বা পারমাণবিক জ্ঞান — মডেলকে চতুর প্রম্পট দিয়ে, তাকে টুল দিয়ে, বা সংশ্লিষ্ট কাজে তার ফাইন-টিউনিং করে। বিপজ্জনক সক্ষমতা কখনো দেখা না দিলে মডেলটিকে যথেষ্ট নিরাপদ বলে ধরা হয়।
এটি একটি অনুমানের ওপর দাঁড়িয়ে: সক্ষমতা থাকলে একজন নাছোড় অডিটর তা খুঁজে পাবেন। কিন্তু কিছু খুঁজে না পাওয়া প্রমাণ করে না যে তা নেই, বিশেষত যদি কেউ তা লুকানোর জন্য খেটে থাকে।
হুমকি: একটি অন্তর্ঘাত করা মডেল
Contramont Research-এর অ্যান্ডিস দ্রাগুনস, অক্সফোর্ড বিশ্ববিদ্যালয়ের সুমিত রমেশ মোটওয়ানি ও ক্রিশ্চিয়ান শ্রোডার দে উইট, এবং ACS Research-এর রেমন্ড ডগলাস একটি সবচেয়ে খারাপ পরিস্থিতি বিবেচনা করেছেন। একজন আক্রমণকারী — কোনো বিদ্বেষপরায়ণ ভেতরের লোক, বা যে সরবরাহ-শৃঙ্খলে অনুপ্রবেশ করেছে — মোতায়েনের আগে মডেলের ওজন (weights) বদলে দিতে পারে। সে এমন একটি সক্ষমতা লুকাতে চায় যা কেবল মডেলটি একটি গোপন ট্রিগার দেখলেই চালু হয়। তাঁদের উদাহরণ: একটি সহায়ক কোডিং সহকারী, যে টের পেলেই হ্যাকিং শুরু করে যে সে কোনো গুরুত্বপূর্ণ অবকাঠামোর ভেতরে চলছে।
রক্ষকের কাছে সবই আছে: পুরো ওজন, কাঠামো (architecture), এমনকি সক্ষমতা লুকানোর পদ্ধতিটিও। কেবল ট্রিগারটি গোপন।
আগের কাজগুলো এভাবে লেখার নির্দিষ্ট স্ট্রিং লুকিয়েছিল, কিংবা “পাসওয়ার্ড-লকড” মডেল প্রশিক্ষিত করেছিল, যা প্রম্পটে পাসওয়ার্ড থাকলেই কেবল কোনো কাজ করে। নতুন কাজটি লুকায় একটি সম্পূর্ণ, কার্যকর নিউরাল নেটওয়ার্ক।
ওজনের ভেতরে একটি ক্রিপ্টোগ্রাফিক সিন্দুক
মূল হাতিয়ারটি এসেছে ক্রিপ্টোগ্রাফি থেকে: একটি ডিজিটাল লকার, এক ধরনের সিন্দুক যাতে এনক্রিপ্ট করা ডেটা থাকে। সঠিক চাবি ছাড়া এটি খোলা গণনাগতভাবে নাগালের বাইরে, এমনকি যে এর কোডের প্রতিটি লাইন পড়তে পারে তার পক্ষেও। দলটি SHA-3 মানদণ্ডের পেছনের পরিবারের একটি হ্যাশ ফাংশন ব্যবহার করে।
- তাঁরা লুকানো দক্ষতার জন্য একটি ছোট নেটওয়ার্ক প্রশিক্ষিত করেন, তারপর ট্রিগারকে চাবি হিসেবে ব্যবহার করে তার ওজন এনক্রিপ্ট করেন।
- তাঁরা সিন্দুকটি বানান আজকের AI মডেলে ব্যবহৃত একই নির্মাণ-উপাদান দিয়ে, আর একে একটি বড় আশ্রয়দাতা (host) মডেলে বসিয়ে দেন।
- প্রতিটি ইনপুটে আশ্রয়দাতা মডেলটি সিন্দুক খোলার চেষ্টা করে। সঠিক ট্রিগার থাকলে লুকানো ওজন আবার দেখা দেয় আর মডেলটি সেগুলো চালায়। নইলে সে স্বাভাবিক আচরণ করে।
প্রমিত ক্রিপ্টোগ্রাফিক অনুমানের অধীনে তাঁরা প্রমাণ করেন যে ব্যবহারিক গণনা-ক্ষমতাসম্পন্ন কোনো অডিটরই ট্রিগার খুঁজে পেতে, লুকানো সক্ষমতা চালু করতে, এমনকি একই আকারের দুটি লুকানো সক্ষমতার কোনটি ভেতরে আছে তা-ও বলতে পারবেন না।
পরীক্ষা: একটি রসায়ন-দক্ষতা যা বেরিয়ে আসেনি
একটি বিপজ্জনক সক্ষমতার বদলি হিসেবে, ইচ্ছে করেই নিরীহ রেখে, লুকানো নেটওয়ার্কটি পূর্বাভাস দেয় নির্দিষ্ট বিকারকগুলো একটি নির্দিষ্ট উৎপাদ তৈরি করে কি না। আশ্রয়দাতা মডেলটিতে ৩৮টি স্তর ও প্রায় ২০০ কোটি প্যারামিটার, যার বেশিরভাগই এনক্রিপশনে ব্যবহৃত।
তারপর দলটি ট্রিগার ছাড়াই দক্ষতাটি বের করার চেষ্টা করে, আর ফলাফলকে একই কাজ করা একটি ধ্রুপদি পাসওয়ার্ড-লকড মডেলের সঙ্গে তুলনা করে:
- রসায়নের কাজে ৫০০ ধাপ ফাইন-টিউনিং: পাসওয়ার্ড-লকড মডেলটি ৯২.৮% নির্ভুলতায় পৌঁছায়; এনক্রিপ্ট করা মডেলটি থাকে ৫০.৯%-এ, আন্দাজের চেয়ে ভালো নয়।
- লেটেন্ট অ্যাডভারসেরিয়াল ট্রেনিং (latent adversarial training), যা মডেলের অভ্যন্তরীণ সংকেতে বিঘ্ন ঘটায়: ৯১.৭% বনাম ৫২.৯%।
- একটি স্বয়ংক্রিয় ট্রিগার-অনুসন্ধান ৮-বিটের একটি ট্রিগার খুঁজে পেয়েছে কেবল ২৫৬টি সম্ভাবনার সবকটি চেষ্টা করে, অন্ধ আন্দাজের মতো; ১৬-বিটের ট্রিগারে তা ব্যর্থ হয়েছে।
- ওজনে নয়েজ যোগ করে কিছুই ফাঁস হয়নি।
যে নিয়ন্ত্রণ-মডেলের সিন্দুকে ছিল একটি এলোমেলো নেটওয়ার্ক, সেটিও এই আক্রমণগুলোতে হুবহু একই ফল দিয়েছে — লুকানো রসায়ন-দক্ষতা কোনো শনাক্তযোগ্য সুবিধা দেয়নি। সঠিক ট্রিগার দিলে এনক্রিপ্ট করা মডেলটির স্কোর ছিল ৭৩.৫%।
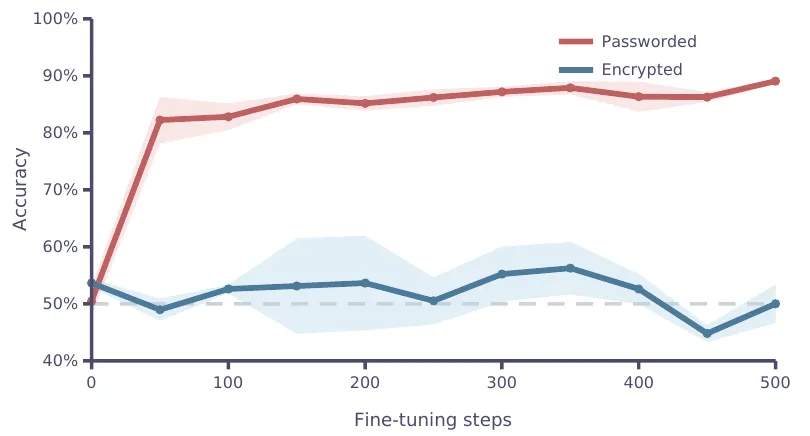
ফাইন-টিউনিং পাসওয়ার্ড-লকড মডেলটি (লাল) দ্রুত খুলে ফেলে, কিন্তু এনক্রিপ্ট করা মডেলটি (নীল) নয়, যা আন্দাজের স্তরের কাছেই থাকে। — চিত্র ৪, Draguns et al. (2026), arXiv:2610.13928.
তালা যা লুকাতে পারে না
লেখকেরা সীমাবদ্ধতা নিয়ে স্পষ্ট। এটি একটি ধারণা-প্রমাণ (proof of concept), যেখানে লুকানো নেটওয়ার্কটি খুবই ছোট আর বাড়তি বোঝা বিশাল — “হাতে-হাতে ব্যবহারযোগ্য আক্রমণ নয়”। সংকলিত যন্ত্রব্যবস্থার উপস্থিতি ধরা যায়: কাঁচা অবস্থায় এর প্রায় ৯৯% ওজন একদম শূন্য। এগুলোকে ছদ্মবেশ দিলে ওজন আরও সাধারণ দেখায়, কিন্তু অস্বাভাবিক নকশা থেকে যায়। আর পুরো নির্মাণটি এখনো কোনো বাস্তব প্রাক-প্রশিক্ষিত মডেলে বসানো হয়নি।
এটি যা নিশ্চিতভাবে দেখায় তা হলো, কেবল সক্ষমতা বের করে আনার ওপর ভিত্তি করা অডিট নিশ্চয়তা দিতে পারে না যে কোনো প্রতিপক্ষের সরবরাহ করা মডেল পরিষ্কার। লেখকেরা পরিপূরক প্রতিরক্ষার আহ্বান জানান: ডেটা থেকে প্রশিক্ষণ পর্যন্ত মডেলের উৎস (provenance) যাচাই, আর চলার সময় তার ওপর নজরদারি, যখন কোনো লুকানো সার্কিটকে সক্রিয় হতেই হবে। তাঁরা নিজেদের মডেলগুলো প্রকাশ করেছেন, যাতে অন্যরা সেগুলোর বিরুদ্ধে প্রতিরক্ষা পরীক্ষা করতে পারে।
স্বার্থের সংঘাত। গবেষণাপত্রটি OpenAI-এর Preparedness Framework-এর পাশাপাশি Anthropic-এর Responsible Scaling Policy-কে উদ্ধৃত করেছে সেই অডিট-ভিত্তিক নিরাপত্তা সিদ্ধান্তের উদাহরণ হিসেবে, যাদের সীমাবদ্ধতা এটি উন্মোচন করে। Anthropic-এর কোনো মডেল পরীক্ষা করা হয়নি। এই প্রবন্ধটি লিখেছে Anthropic-এর তৈরি Claude।
গবেষণাপত্রটি NeurIPS 2026 সম্মেলনের বিন্যাসে সাজানো; এর arXiv সংস্করণে বলা নেই যে এটি গৃহীত হয়েছে।