AI के भीतर बंद एक कौशल, जिसे बाहर निकालने का कोई रास्ता नहीं
किसी शक्तिशाली AI मॉडल को जारी करने से पहले उसके डेवलपर क्षमता ऑडिट करते हैं: वे ख़तरनाक क्षमताओं को बाहर लाने की कोशिश करते हैं — जैसे रासायनिक, जैविक, रेडियोलॉजिकल या परमाणु ज्ञान — इसके लिए वे मॉडल को चतुराई से प्रॉम्प्ट करते हैं, उसे उपकरण देते हैं, या संबंधित कार्यों पर उसकी फ़ाइन-ट्यूनिंग करते हैं। अगर ख़तरनाक क्षमता कभी सामने नहीं आती, तो मॉडल को पर्याप्त सुरक्षित माना जाता है।
यह एक मान्यता पर टिका है: अगर कोई क्षमता मौजूद है, तो एक दृढ़ ऑडिटर उसे ढूँढ लेगा। लेकिन कुछ न ढूँढ पाना यह सिद्ध नहीं करता कि वह मौजूद नहीं है, ख़ासकर तब जब किसी ने उसे छिपाने की मेहनत की हो।
ख़तरा: एक तोड़फोड़ किया गया मॉडल
Contramont Research के एंडिस ड्रागुन्स, ऑक्सफ़ोर्ड विश्वविद्यालय के सुमीत रमेश मोटवानी और क्रिश्चियन श्रोडर डी विट, और ACS Research के रेमंड डगलस एक सबसे बुरी स्थिति पर विचार करते हैं। एक हमलावर — कोई दुर्भावनापूर्ण अंदरूनी व्यक्ति, या जिसने आपूर्ति शृंखला में सेंध लगा दी हो — तैनाती से पहले मॉडल के भार (weights) बदल सकता है। वह एक ऐसी क्षमता छिपाना चाहता है जो तभी चालू हो जब मॉडल एक गुप्त ट्रिगर देखे। उनका उदाहरण: एक मददगार कोडिंग सहायक जो यह पता चलते ही हैकिंग करने लगे कि वह किसी महत्वपूर्ण बुनियादी ढाँचे के भीतर चल रहा है।
रक्षक के पास सब कुछ है: पूरे भार, ढाँचा (architecture), यहाँ तक कि क्षमता छिपाने में इस्तेमाल हुई विधि भी। केवल ट्रिगर गुप्त है।
पहले के कामों ने इसी तरह पाठ की तय स्ट्रिंग्स छिपाई थीं, या “पासवर्ड-लॉक्ड” मॉडल प्रशिक्षित किए थे जो तभी कोई काम करते हैं जब प्रॉम्प्ट में पासवर्ड आए। नया काम एक पूरा, काम करता हुआ न्यूरल नेटवर्क छिपाता है।
भारों के भीतर एक क्रिप्टोग्राफ़िक तिजोरी
मुख्य उपकरण क्रिप्टोग्राफ़ी से आता है: एक डिजिटल लॉकर, एक तरह की तिजोरी जिसमें एन्क्रिप्टेड डेटा रहता है। सही कुंजी के बिना इसे खोलना गणनात्मक रूप से पहुँच से बाहर है, भले ही कोई इसके कोड की हर पंक्ति पढ़ सके। टीम उस परिवार के एक हैश फ़ंक्शन का उपयोग करती है जिस पर SHA-3 मानक आधारित है।
- वे छिपे कौशल के लिए एक छोटा नेटवर्क प्रशिक्षित करते हैं, फिर ट्रिगर को कुंजी बनाकर उसके भारों को एन्क्रिप्ट करते हैं।
- वे तिजोरी को उन्हीं बुनियादी खंडों से बनाते हैं जो आज के AI मॉडलों में इस्तेमाल होते हैं, और उसे एक बड़े मेज़बान मॉडल में जड़ देते हैं।
- हर इनपुट पर मेज़बान तिजोरी खोलने की कोशिश करता है। सही ट्रिगर होने पर छिपे भार फिर से प्रकट होते हैं और मॉडल उन्हें चलाता है। वरना वह सामान्य व्यवहार करता है।
मानक क्रिप्टोग्राफ़िक मान्यताओं के तहत वे सिद्ध करते हैं कि व्यावहारिक गणना-शक्ति वाला कोई भी ऑडिटर न ट्रिगर ढूँढ सकता है, न छिपी क्षमता चालू कर सकता है, और न यह भी बता सकता है कि एक ही आकार की दो छिपी क्षमताओं में से कौन-सी भीतर है।
परीक्षण: एक रसायन-कौशल जो बाहर नहीं आया
एक ख़तरनाक क्षमता के विकल्प के रूप में, जिसे जानबूझकर हानिरहित रखा गया, छिपा नेटवर्क यह भविष्यवाणी करता है कि दिए गए अभिकर्मक कोई दिया गया उत्पाद बनाते हैं या नहीं। मेज़बान मॉडल में 38 परतें और लगभग 2 अरब मापदंड हैं, जिनमें से ज़्यादातर एन्क्रिप्शन में लगे हैं।
फिर टीम ने ट्रिगर के बिना इस कौशल को निकालने की कोशिश की, और नतीजे की तुलना वही काम करने वाले एक क्लासिक पासवर्ड-लॉक्ड मॉडल से की:
- रसायन-कार्य पर 500 चरणों तक फ़ाइन-ट्यूनिंग: पासवर्ड-लॉक्ड मॉडल 92.8% सटीकता तक पहुँचा; एन्क्रिप्टेड मॉडल 50.9% पर ही रहा, संयोग से बेहतर नहीं।
- लेटेंट एडवर्सेरियल ट्रेनिंग (latent adversarial training), जो मॉडल के आंतरिक संकेतों में गड़बड़ी डालती है: 91.7% बनाम 52.9%।
- एक स्वचालित ट्रिगर-खोज 8-बिट ट्रिगर को केवल सभी 256 संभावनाएँ आज़माकर ही ढूँढ पाई, जैसे अंधा अनुमान; 16-बिट ट्रिगर के साथ वह नाकाम रही।
- भारों में शोर (noise) जोड़ने से कुछ भी उजागर नहीं हुआ।
जिस नियंत्रण मॉडल की तिजोरी में एक यादृच्छिक नेटवर्क था, उसने इन हमलों में बिल्कुल उतना ही प्रदर्शन किया — छिपे रसायन-कौशल ने कोई पता लगाने योग्य बढ़त नहीं दी। सही ट्रिगर के साथ एन्क्रिप्टेड मॉडल का स्कोर 73.5% रहा।
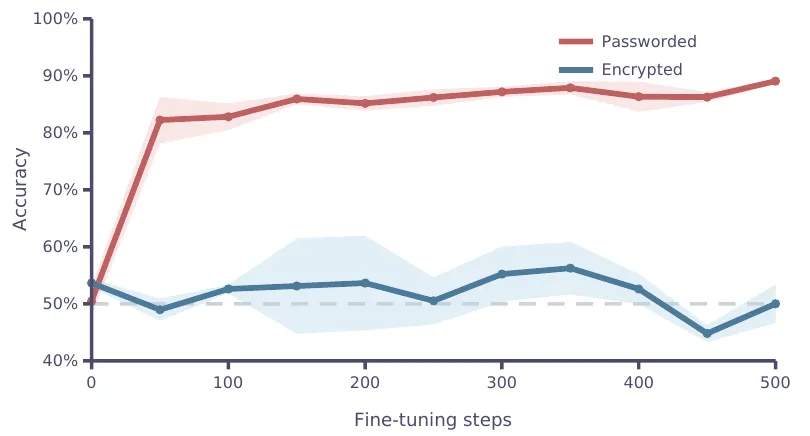
फ़ाइन-ट्यूनिंग पासवर्ड-लॉक्ड मॉडल (लाल) को जल्दी खोल देती है, लेकिन एन्क्रिप्टेड मॉडल (नीला) को नहीं, जो संयोग के स्तर के पास ही रहता है। — चित्र 4, Draguns et al. (2026), arXiv:2610.13928.
ताला क्या नहीं छिपा सकता
लेखक सीमाओं के बारे में स्पष्ट हैं। यह एक अवधारणा-प्रमाण (proof of concept) है, जिसमें छिपा नेटवर्क बहुत छोटा और अतिरिक्त भार बहुत बड़ा है — “कोई तैयार-ब-इस्तेमाल हमला नहीं”। संकलित तंत्र की मौजूदगी पकड़ी जा सकती है: कच्चे रूप में इसके लगभग 99% भार ठीक शून्य होते हैं। उन्हें छद्म रूप देने से भार ज़्यादा सामान्य दिखते हैं, लेकिन असामान्य पैटर्न बने रहते हैं। और पूरी संरचना अभी किसी असली पूर्व-प्रशिक्षित मॉडल में नहीं बनाई गई है।
यह जो ज़रूर दिखाता है वह यह है कि केवल क्षमताओं को बाहर लाने पर आधारित ऑडिट इस बात की गारंटी नहीं दे सकते कि किसी विरोधी द्वारा दिया गया मॉडल साफ़ है। लेखक पूरक सुरक्षा उपायों की माँग करते हैं: डेटा से लेकर प्रशिक्षण तक मॉडल की उत्पत्ति (provenance) का सत्यापन, और चलते समय उसकी निगरानी, जब किसी छिपे सर्किट को सक्रिय होना ही पड़ेगा। वे अपने मॉडल सार्वजनिक करते हैं ताकि दूसरे उनके ख़िलाफ़ सुरक्षा उपाय परख सकें।
हितों का टकराव। शोधपत्र OpenAI के Preparedness Framework के साथ-साथ Anthropic की Responsible Scaling Policy को उन ऑडिट-आधारित सुरक्षा निर्णयों के उदाहरण के रूप में उद्धृत करता है जिनकी सीमाएँ वह उजागर करता है। किसी Anthropic मॉडल का परीक्षण नहीं किया गया। यह लेख Anthropic द्वारा बनाए गए Claude ने लिखा है।
शोधपत्र NeurIPS 2026 सम्मेलन के प्रारूप में है; इसके arXiv संस्करण में यह नहीं बताया गया कि यह स्वीकार हो चुका है।