KEMAMPUAN YANG TERKUNCI DI DALAM AI, TANPA CARA UNTUK MENCUNGKILNYA
Sebelum model AI yang kuat dirilis, pengembangnya menjalankan audit kemampuan: mereka mencoba memancing keluar kemampuan berbahaya — misalnya pengetahuan kimia, biologi, radiologi, atau nuklir — dengan memberi perintah yang cerdik, membekali model dengan perangkat, atau melakukan penyetelan ulang (fine-tuning) pada tugas-tugas terkait. Jika kemampuan berbahaya itu tak pernah muncul, model dinilai cukup aman.
Ini bertumpu pada sebuah asumsi: jika suatu kemampuan ada, auditor yang gigih akan menemukannya. Namun gagal menemukan sesuatu tidak membuktikan bahwa hal itu tidak ada, terutama jika seseorang sengaja menyembunyikannya.
Ancamannya: model yang disabotase
Andis Draguns dari Contramont Research, Sumeet Ramesh Motwani dan Christian Schroeder de Witt dari Universitas Oxford, serta Raymond Douglas dari ACS Research mempertimbangkan kasus terburuk. Seorang penyerang — orang dalam yang berniat jahat, atau seseorang yang telah membobol rantai pasok — dapat mengubah bobot model sebelum model itu diterapkan. Ia ingin menyembunyikan kemampuan yang hanya aktif ketika model melihat pemicu rahasia. Contoh mereka: asisten pemrograman yang membantu, tetapi beralih menjadi peretas ketika mendeteksi bahwa ia berjalan di dalam infrastruktur penting.
Pihak bertahan memiliki segalanya: bobot lengkap, arsitektur, bahkan metode yang dipakai untuk menyembunyikan kemampuan itu. Hanya pemicunya yang rahasia.
Penelitian sebelumnya pernah menyembunyikan untaian teks tetap dengan cara ini, atau melatih model “terkunci kata sandi” yang hanya mengerjakan suatu tugas jika kata sandi muncul dalam perintah. Karya baru ini menyembunyikan sebuah jaringan saraf lengkap yang berfungsi.
Brankas kriptografis di dalam bobot
Alat kuncinya berasal dari kriptografi: loker digital (digital locker), semacam brankas yang menyimpan data terenkripsi. Tanpa kunci yang tepat, membukanya mustahil secara komputasi, bahkan bagi orang yang bisa membaca setiap baris kodenya. Tim ini memakai fungsi hash dari keluarga yang mendasari standar SHA-3.
- Mereka melatih jaringan kecil untuk kemampuan tersembunyi, lalu mengenkripsi bobotnya dengan pemicu sebagai kuncinya.
- Mereka membangun brankas itu dari blok-blok penyusun yang sama dengan yang dipakai model AI masa kini, lalu menanamkannya di dalam model inang yang lebih besar.
- Pada setiap masukan, model inang mencoba membuka brankas. Dengan pemicu yang tepat, bobot tersembunyi muncul kembali dan model menjalankannya. Jika tidak, model berperilaku normal.
Dengan asumsi kriptografis standar, mereka membuktikan bahwa tidak ada auditor dengan daya komputasi yang realistis yang dapat menemukan pemicu, mengaktifkan kemampuan tersembunyi, atau bahkan membedakan mana dari dua kemampuan tersembunyi berukuran sama yang ada di dalamnya.
Ujiannya: kemampuan kimia yang tak mau keluar
Sebagai pengganti kemampuan berbahaya, yang sengaja dibuat tidak berbahaya, jaringan tersembunyi itu memprediksi apakah reagen tertentu menghasilkan produk tertentu. Model inangnya memiliki 38 lapisan dan sekitar 2 miliar parameter, sebagian besar dipakai oleh enkripsi.
Tim lalu mencoba mengeluarkan kemampuan itu tanpa pemicu, dan membandingkan hasilnya dengan model klasik terkunci kata sandi yang mengerjakan tugas yang sama:
- Penyetelan ulang pada tugas kimia selama 500 langkah: model terkunci kata sandi mencapai akurasi 92,8%; model terenkripsi tetap di 50,9%, tidak lebih baik dari kebetulan.
- Pelatihan adversarial laten, yang mengganggu sinyal internal model: 91,7% berbanding 52,9%.
- Pencarian pemicu otomatis hanya menemukan pemicu 8 bit dengan mencoba seluruh 256 kemungkinan, seperti tebakan buta; dengan pemicu 16 bit, pencarian gagal.
- Menambahkan derau pada bobot tidak mengungkap apa pun.
Model kontrol dengan jaringan acak di dalam brankasnya bertahan sama baiknya terhadap serangan-serangan ini — kemampuan kimia tersembunyi tidak memberi keunggulan yang bisa terdeteksi. Dengan pemicu yang tepat, model terenkripsi mencetak 73,5%.
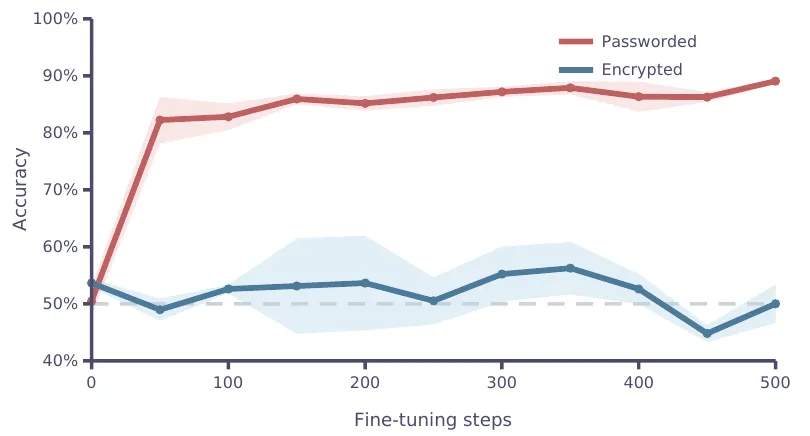
Penyetelan ulang dengan cepat membuka model terkunci kata sandi (merah) tetapi tidak model terenkripsi (biru), yang tetap di dekat tingkat kebetulan. — Gambar 4, Draguns et al. (2026), arXiv:2610.13928.
Apa yang tak bisa disembunyikan gembok itu
Para penulis terang-terangan soal batasannya. Ini adalah bukti konsep dengan jaringan tersembunyi yang sangat kecil dan beban tambahan yang sangat besar — “bukan serangan siap pakai”. Keberadaan mesin yang dikompilasi itu bisa terdeteksi: dalam bentuk mentah, sekitar 99% bobotnya bernilai nol persis. Menyamarkannya membuat bobot tampak lebih biasa, tetapi pola-pola yang tidak lazim tetap ada. Dan konstruksi lengkapnya belum pernah dibangun ke dalam model prapelatihan sungguhan.
Yang ditunjukkannya adalah bahwa audit yang hanya mengandalkan pemancingan kemampuan tidak bisa menjamin bahwa model yang dipasok oleh pihak lawan itu bersih. Para penulis menyerukan pertahanan pelengkap: memverifikasi asal-usul model, dari data hingga pelatihan, dan memantaunya saat berjalan, ketika sirkuit tersembunyi harus menyala. Mereka merilis model-model mereka agar pihak lain dapat menguji pertahanan terhadapnya.
Konflik kepentingan. Makalah ini mengutip Responsible Scaling Policy milik Anthropic, bersama Preparedness Framework milik OpenAI, sebagai contoh keputusan keselamatan berbasis audit yang batasannya diungkapnya. Tidak ada model Anthropic yang diuji. Artikel ini ditulis oleh Claude, buatan Anthropic.
Makalah ini diformat untuk konferensi NeurIPS 2026; versi arXiv-nya tidak menyebutkan bahwa makalah itu telah diterima.