AIの内部に閉じ込められ、こじ開ける方法のない能力
強力なAIモデルを公開する前に、開発者は能力監査を行う。巧みなプロンプトを与えたり、ツールを持たせたり、関連する課題でファインチューニングしたりして、危険な能力(たとえば化学、生物、放射線、核に関する知識)を引き出そうとするのだ。危険な能力が一度も現れなければ、モデルは十分に安全だと判断される。
これはある前提に基づいている。能力がそこにあるなら、粘り強い監査人がそれを見つけるはずだ、という前提だ。しかし何かが見つからないからといって、それが存在しないことの証明にはならない。誰かがそれを隠そうとしていた場合はなおさらだ。
脅威:妨害工作されたモデル
コントラモント・リサーチのアンディス・ドラグンス(Andis Draguns)、オックスフォード大学のスミート・ラメシュ・モトワニ(Sumeet Ramesh Motwani)とクリスチャン・シュレーダー・デ・ヴィット(Christian Schroeder de Witt)、ACSリサーチのレイモンド・ダグラス(Raymond Douglas)は、最悪のケースを考えた。攻撃者(悪意ある内部関係者や、サプライチェーンを乗っ取った者)は、モデルが配備される前にその重みを書き換えられる。彼らは、モデルが秘密のトリガーを見たときにだけ作動する能力を隠したい。著者らの例は、重要インフラの内部で動いていると察知したときにハッキングに転じる、役に立つコーディングアシスタントだ。
防御側はすべてを手にしている。完全な重み、アーキテクチャ、さらには能力を隠すのに使われた方法までだ。秘密なのはトリガーだけである。
以前の研究では、この方法で決まった文字列を隠したり、プロンプトにパスワードが現れたときだけ課題をこなす「パスワードロック型」モデルを訓練したりしていた。新しい研究は、完全に機能するニューラルネットワークを丸ごと隠す。
重みの中の暗号金庫
鍵となる道具は暗号学から来ている。デジタルロッカーと呼ばれる、暗号化されたデータを保管する一種の金庫だ。正しい鍵がなければ、たとえコードを一行残らず読める人でも、計算量的に開けることはできない。チームはSHA-3標準の基になっている系統のハッシュ関数を使っている。
- まず隠したい能力のための小さなネットワークを訓練し、トリガーを鍵としてその重みを暗号化する。
- 今日のAIモデルで使われているのと同じ構成要素で金庫を作り、より大きなホストモデルに埋め込む。
- 入力があるたびに、ホストは金庫を開けようとする。正しいトリガーなら隠された重みが再び現れ、モデルはそれを実行する。そうでなければ、普通にふるまう。
標準的な暗号学的仮定のもとで、著者らは次のことを証明している。現実的な計算能力しか持たない監査人には、トリガーを見つけることも、隠された能力を作動させることも、同じ大きさの二つの隠された能力のどちらが中にあるかを見分けることさえもできない。
テスト:出てこなかった化学の能力
危険な能力の代役として、意図的に無害にとどめた隠しネットワークは、与えられた試薬から与えられた生成物ができるかどうかを予測する。ホストモデルは38層で約20億のパラメーターを持ち、その大半は暗号化に使われている。
チームはトリガーなしでこの能力を引き出そうと試み、同じ課題をこなす従来のパスワードロック型モデルと結果を比べた。
- 化学の課題で500ステップのファインチューニング:パスワードロック型モデルは正答率**92.8%に達したが、暗号化されたモデルは50.9%**にとどまり、偶然と変わらなかった。
- モデル内部の信号に摂動を加える潜在敵対的訓練:91.7%対52.9%。
- 自動化されたトリガー探索は、8ビットのトリガーを256通りすべて試すことでしか見つけられず、当てずっぽうと同じだった。16ビットのトリガーでは失敗した。
- 重みにノイズを加えても、何も明らかにならなかった。
金庫にランダムなネットワークを入れた対照モデルも、これらの攻撃のもとで同じくらいの成績だった。つまり隠された化学の能力は、検出できる優位を何も与えなかった。正しいトリガーを使うと、暗号化されたモデルの成績は73.5%だった。
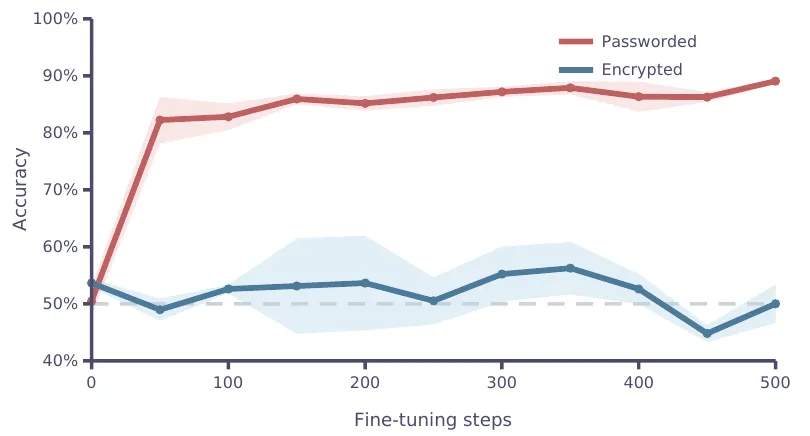
ファインチューニングはパスワードロック型モデル(赤)をすぐに解錠するが、暗号化されたモデル(青)は解錠できず、偶然の水準付近にとどまる。— 図4、Draguns et al. (2026), arXiv:2610.13928.
錠が隠せないもの
著者らは限界をはっきりと述べている。これは小さな隠しネットワークと巨大なオーバーヘッドによる概念実証であり、「すぐに使える攻撃ではない」。コンパイルされた仕組みの存在は見破られうる。そのままでは、重みの約99%が厳密にゼロだからだ。偽装すれば重みはより普通に見えるが、珍しいパターンは残る。また、完全な構成はまだ実際の事前学習済みモデルには組み込まれていない。
この研究が示しているのは、能力を引き出すことだけに基づく監査では、敵対者が提供したモデルが潔白だと保証できないということだ。著者らは補完的な防御を求めている。データから訓練までモデルの来歴を検証すること、そして隠された回路が作動しなければならない稼働中にモデルを監視することだ。著者らはモデルを公開し、ほかの人々がそれに対する防御を試せるようにしている。
利益相反。 この論文は、監査に基づく安全性判断の例として、OpenAIの準備態勢フレームワーク(Preparedness Framework)とともにAnthropicの責任あるスケーリング方針(Responsible Scaling Policy)を挙げ、その限界を明らかにしている。Anthropicのモデルは一つも検査されていない。この記事は、Anthropicが作ったClaudeが書いている。
この論文はNeurIPS 2026会議の書式で書かれているが、arXiv版には採択されたとは記されていない。