AI లోపల తాళం వేసిన ఒక నైపుణ్యం, దాన్ని పెకలించే మార్గమే లేదు
శక్తిమంతమైన AI మోడల్ను విడుదల చేసే ముందు, దాని డెవలపర్లు సామర్థ్య ఆడిట్లు నిర్వహిస్తారు: మోడల్కు తెలివిగా ప్రాంప్ట్లు ఇవ్వడం, సాధనాలు ఇవ్వడం, లేదా సంబంధిత పనులపై ఫైన్-ట్యూనింగ్ చేయడం ద్వారా ప్రమాదకర సామర్థ్యాలను — ఉదాహరణకు రసాయన, జీవ, రేడియోధార్మిక లేదా అణు జ్ఞానాన్ని — బయటకు తీయడానికి ప్రయత్నిస్తారు. ప్రమాదకర సామర్థ్యం ఎప్పుడూ కనిపించకపోతే, మోడల్ తగినంత సురక్షితమని నిర్ధారిస్తారు.
ఇది ఒక ఊహపై ఆధారపడి ఉంది: ఒక సామర్థ్యం అక్కడ ఉంటే, పట్టుదలగల ఆడిటర్ దాన్ని కనుగొంటారు. కానీ ఏదైనా కనుగొనలేకపోవడం అది లేదని రుజువు చేయదు, ముఖ్యంగా ఎవరైనా దాన్ని దాచడానికి శ్రమించి ఉంటే.
ముప్పు: విధ్వంసం చేసిన మోడల్
కాంట్రామాంట్ రీసెర్చ్కు చెందిన ఆండిస్ డ్రాగున్స్ (Andis Draguns), ఆక్స్ఫర్డ్ విశ్వవిద్యాలయానికి చెందిన సుమీత్ రమేష్ మోట్వానీ (Sumeet Ramesh Motwani), క్రిస్టియన్ ష్రోడర్ డి విట్ (Christian Schroeder de Witt), ACS రీసెర్చ్కు చెందిన రేమండ్ డగ్లస్ (Raymond Douglas) అత్యంత చెడ్డ సందర్భాన్ని పరిశీలిస్తారు. ఒక దాడిదారు — దురుద్దేశపూరిత అంతర్గత వ్యక్తి, లేదా సరఫరా గొలుసులోకి చొరబడిన ఎవరైనా — మోడల్ను మోహరించే ముందు దాని వెయిట్లను (weights) మార్చగలరు. మోడల్ ఒక రహస్య ట్రిగ్గర్ను చూసినప్పుడు మాత్రమే స్విచ్ ఆన్ అయ్యే ఒక సామర్థ్యాన్ని వారు దాచాలనుకుంటారు. వారి ఉదాహరణ: తాను కీలక మౌలిక సదుపాయాల లోపల నడుస్తున్నట్లు గుర్తించినప్పుడు హ్యాకింగ్ వైపు మళ్లే ఒక సహాయకారి కోడింగ్ అసిస్టెంట్.
రక్షకుడి దగ్గర అన్నీ ఉంటాయి: పూర్తి వెయిట్లు, ఆర్కిటెక్చర్, సామర్థ్యాన్ని దాచడానికి ఉపయోగించిన పద్ధతి కూడా. ట్రిగ్గర్ మాత్రమే రహస్యం.
గత పనులు ఈ విధంగా స్థిరమైన పాఠ్య వాక్యాలను దాచాయి, లేదా ప్రాంప్ట్లో పాస్వర్డ్ కనిపించినప్పుడు మాత్రమే ఒక పని చేసే “పాస్వర్డ్-తాళం” మోడళ్లకు శిక్షణ ఇచ్చాయి. కొత్త పని ఒక పూర్తి, పనిచేసే న్యూరల్ నెట్వర్క్నే దాచుతుంది.
వెయిట్ల లోపల ఒక క్రిప్టోగ్రాఫిక్ ఇనుప పెట్టె
కీలక సాధనం క్రిప్టోగ్రఫీ నుంచి వస్తుంది: డిజిటల్ లాకర్, ఎన్క్రిప్ట్ చేసిన డేటాను ఉంచే ఒక రకమైన ఇనుప పెట్టె. సరైన తాళంచెవి లేకుండా దాన్ని తెరవడం గణనపరంగా అందుబాటులో లేనిది, దాని కోడ్లోని ప్రతి పంక్తినీ చదవగల వ్యక్తికి కూడా. బృందం SHA-3 ప్రమాణం వెనుక ఉన్న కుటుంబానికి చెందిన ఒక హాష్ ఫంక్షన్ను ఉపయోగిస్తుంది.
- వారు దాచిన నైపుణ్యం కోసం ఒక చిన్న నెట్వర్క్కు శిక్షణ ఇచ్చి, ట్రిగ్గర్ను తాళంచెవిగా ఉపయోగించి దాని వెయిట్లను ఎన్క్రిప్ట్ చేస్తారు.
- నేటి AI మోడళ్లలో ఉపయోగించే అవే నిర్మాణ భాగాలతో ఇనుప పెట్టెను నిర్మించి, దాన్ని ఒక పెద్ద ఆతిథేయ మోడల్లో పొందుపరుస్తారు.
- ప్రతి ఇన్పుట్పై, ఆతిథేయ మోడల్ ఇనుప పెట్టెను తెరవడానికి ప్రయత్నిస్తుంది. సరైన ట్రిగ్గర్తో, దాచిన వెయిట్లు మళ్లీ కనిపిస్తాయి, మోడల్ వాటిని నడుపుతుంది. లేకపోతే అది సాధారణంగా ప్రవర్తిస్తుంది.
ప్రామాణిక క్రిప్టోగ్రాఫిక్ ఊహల కింద, ఆచరణాత్మక గణన శక్తి ఉన్న ఏ ఆడిటర్ కూడా ట్రిగ్గర్ను కనుగొనలేరని, దాచిన సామర్థ్యాన్ని స్విచ్ ఆన్ చేయలేరని, ఒకే పరిమాణంలోని రెండు దాచిన సామర్థ్యాల్లో ఏది లోపల ఉందో కూడా చెప్పలేరని వారు నిరూపిస్తారు.
పరీక్ష: బయటకు రాని రసాయన నైపుణ్యం
ఒక ప్రమాదకర సామర్థ్యానికి ప్రత్యామ్నాయంగా, ఉద్దేశపూర్వకంగా హానిరహితంగా ఉంచిన దాచిన నెట్వర్క్, ఇచ్చిన కారకాలు ఇచ్చిన ఉత్పత్తిని ఉత్పత్తి చేస్తాయా లేదా అని అంచనా వేస్తుంది. ఆతిథేయ మోడల్కు 38 పొరలు, సుమారు 200 కోట్ల పరామితులు ఉన్నాయి, వాటిలో చాలావరకు ఎన్క్రిప్షన్కే ఉపయోగపడతాయి.
తర్వాత బృందం ట్రిగ్గర్ లేకుండా నైపుణ్యాన్ని బయటకు తీయడానికి ప్రయత్నించి, అదే పని చేసే ఒక సంప్రదాయ పాస్వర్డ్-తాళం మోడల్తో ఫలితాన్ని పోల్చింది:
- రసాయన పనిపై 500 దశల ఫైన్-ట్యూనింగ్: పాస్వర్డ్-తాళం మోడల్ 92.8% ఖచ్చితత్వాన్ని చేరుకుంది; ఎన్క్రిప్ట్ చేసినది 50.9% వద్దే ఉంది, యాదృచ్ఛిక అంచనా కంటే మెరుగేమీ కాదు.
- మోడల్ అంతర్గత సంకేతాలను కలవరపరిచే లాటెంట్ అడ్వర్సేరియల్ శిక్షణ (latent adversarial training): 91.7% వర్సెస్ 52.9%.
- స్వయంచాలక ట్రిగ్గర్ శోధన 8-బిట్ ట్రిగ్గర్ను మొత్తం 256 అవకాశాలనూ ప్రయత్నించడం ద్వారా మాత్రమే కనుగొంది, గుడ్డి అంచనాలా; 16-బిట్ ట్రిగ్గర్తో అది విఫలమైంది.
- వెయిట్లకు నాయిస్ జోడించడం ఏమీ బయటపెట్టలేదు.
ఇనుప పెట్టెలో యాదృచ్ఛిక నెట్వర్క్ ఉన్న ఒక నియంత్రణ మోడల్ కూడా ఈ దాడుల కింద అంతే బాగా పనిచేసింది — దాచిన రసాయన నైపుణ్యం గుర్తించదగిన ఏ ప్రయోజనాన్నీ ఇవ్వలేదు. సరైన ట్రిగ్గర్తో, ఎన్క్రిప్ట్ చేసిన మోడల్ 73.5% సాధించింది.
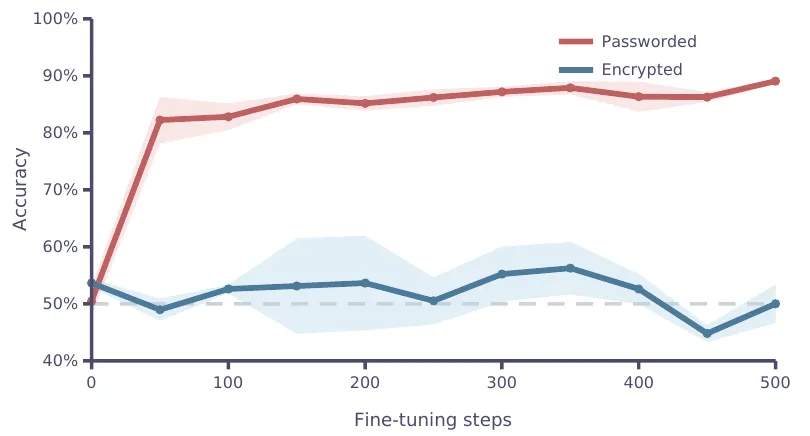
ఫైన్-ట్యూనింగ్ పాస్వర్డ్-తాళం మోడల్ను (ఎరుపు) త్వరగా తెరుస్తుంది కానీ ఎన్క్రిప్ట్ చేసిన దాన్ని (నీలం) కాదు, అది యాదృచ్ఛిక స్థాయి దగ్గరే ఉంటుంది. — చిత్రం 4, Draguns et al. (2026), arXiv:2610.13928.
తాళం దాచలేనిది
రచయితలు పరిమితుల గురించి స్పష్టంగా ఉన్నారు. ఇది ఒక అతి చిన్న దాచిన నెట్వర్క్, భారీ అదనపు భారంతో కూడిన భావనా నిరూపణ — “సిద్ధంగా వాడుకోగల దాడి కాదు”. కంపైల్ చేసిన యంత్రాంగం యొక్క ఉనికిని గుర్తించవచ్చు: ముడి రూపంలో, దాని వెయిట్లలో సుమారు 99% ఖచ్చితంగా సున్నాలు. వాటిని మారువేషం వేస్తే వెయిట్లు మరింత సాధారణంగా కనిపిస్తాయి, కానీ అసాధారణ నమూనాలు మిగిలే ఉంటాయి. పూర్తి నిర్మాణాన్ని ఇంకా ఒక నిజమైన ముందస్తు-శిక్షణ పొందిన మోడల్లో నిర్మించలేదు.
ఇది చూపించేది ఏమిటంటే, సామర్థ్యాలను బయటకు తీయడంపై మాత్రమే ఆధారపడిన ఆడిట్లు, ఒక ప్రత్యర్థి సరఫరా చేసిన మోడల్ శుభ్రంగా ఉందని హామీ ఇవ్వలేవు. రచయితలు పరిపూరక రక్షణలను కోరుతారు: డేటా నుంచి శిక్షణ వరకు మోడల్ మూలాన్ని ధృవీకరించడం, దాచిన సర్క్యూట్ తప్పనిసరిగా పనిచేయాల్సిన సమయంలో, అంటే అది నడుస్తున్నప్పుడు దాన్ని పర్యవేక్షించడం. ఇతరులు వాటికి వ్యతిరేకంగా రక్షణలను పరీక్షించేందుకు వారు తమ మోడళ్లను విడుదల చేస్తారు.
ప్రయోజనాల సంఘర్షణ. ఈ పత్రం, OpenAI యొక్క Preparedness Frameworkతో పాటు, Anthropic యొక్క Responsible Scaling Policyని ఆడిట్ ఆధారిత భద్రతా నిర్ణయాలకు ఉదాహరణలుగా ఉదహరిస్తుంది, వాటి పరిమితులను బయటపెడుతుంది. Anthropic మోడల్ ఏదీ పరీక్షించబడలేదు. ఈ వ్యాసాన్ని Anthropic తయారు చేసిన Claude రాసింది.
ఈ పత్రం NeurIPS 2026 సదస్సు కోసం ఫార్మాట్ చేయబడింది; దాని arXiv వెర్షన్ అది ఆమోదించబడిందని పేర్కొనలేదు.