ஒரு AI-க்குள் பூட்டப்பட்ட திறன், வெளியே எடுக்க வழியே இல்லை
சக்திவாய்ந்த ஒரு AI மாதிரி வெளியிடப்படுவதற்கு முன், அதன் உருவாக்குநர்கள் திறன் தணிக்கைகளை (capability audits) நடத்துகின்றனர்: மாதிரியைச் சாமர்த்தியமாகத் தூண்டுவதன் மூலமும், அதற்குக் கருவிகளை வழங்குவதன் மூலமும், தொடர்புடைய பணிகளில் அதை நுண்ணமைப்பதன் (fine-tuning) மூலமும், ஆபத்தான திறன்களை — எடுத்துக்காட்டாக வேதியியல், உயிரியல், கதிரியக்க அல்லது அணுக்கரு அறிவை — வெளிக்கொணர முயல்கின்றனர். ஆபத்தான திறன் ஒருபோதும் தென்படவில்லை என்றால், மாதிரி போதுமான அளவு பாதுகாப்பானது எனக் கருதப்படுகிறது.
இது ஓர் அனுமானத்தைச் சார்ந்துள்ளது: ஒரு திறன் இருந்தால், உறுதியான தணிக்கையாளர் அதைக் கண்டுபிடிப்பார். ஆனால் ஒன்றைக் கண்டுபிடிக்கத் தவறுவது அது இல்லை என்பதை நிரூபிக்காது — குறிப்பாக, யாராவது அதை மறைக்க உழைத்திருந்தால்.
அச்சுறுத்தல்: நாசவேலை செய்யப்பட்ட மாதிரி
Contramont Research-இன் ஆண்டிஸ் டிராகுன்ஸ், ஆக்ஸ்ஃபோர்டு பல்கலைக்கழகத்தின் சுமீத் ரமேஷ் மோத்வானி, கிறிஸ்டியன் ஷ்ரோடர் டி விட், ACS Research-இன் ரேமண்ட் டக்ளஸ் ஆகியோர் மிக மோசமான நிலையை ஆராய்கின்றனர். ஒரு தாக்குதலாளர் — தீய நோக்கமுள்ள உள்ளாள், அல்லது விநியோகச் சங்கிலியை ஊடுருவிய ஒருவர் — ஒரு மாதிரி பயன்பாட்டுக்கு வருவதற்கு முன் அதன் எடைகளை (weights) மாற்ற முடியும். மாதிரி ஒரு ரகசியத் தூண்டியைப் (secret trigger) பார்க்கும்போது மட்டுமே செயல்படும் ஒரு திறனை அவர் மறைக்க விரும்புகிறார். அவர்களின் எடுத்துக்காட்டு: முக்கிய உள்கட்டமைப்புக்குள் இயங்குவதைக் கண்டறிந்தால் ஹேக்கிங்கில் இறங்கும், உதவிகரமான ஒரு நிரலாக்க உதவியாளர்.
பாதுகாப்பாளரிடம் எல்லாம் உள்ளது: முழு எடைகள், கட்டமைப்பு, திறனை மறைக்கப் பயன்படுத்திய முறைகூட. தூண்டி மட்டுமே ரகசியம்.
முந்தைய பணிகள் இவ்வாறு நிலையான உரைச் சரங்களை மறைத்திருந்தன, அல்லது தூண்டுதலில் ஒரு கடவுச்சொல் வரும்போது மட்டுமே ஒரு பணியைச் செய்யும் ‘கடவுச்சொல் பூட்டு’ (password-locked) மாதிரிகளைப் பயிற்றுவித்திருந்தன. புதிய பணி ஒரு முழுமையான, இயங்கும் நரம்பியல் வலையமைப்பை மறைக்கிறது.
எடைகளுக்குள் ஒரு மறையாக்கப் பெட்டகம்
முக்கியக் கருவி மறையியலிலிருந்து வருகிறது: மறையாக்கப்பட்ட தரவை வைத்திருக்கும் ஒருவகைப் பெட்டகமான டிஜிட்டல் லாக்கர் (digital locker). சரியான சாவி இல்லாமல், அதன் குறியீட்டின் ஒவ்வொரு வரியையும் படிக்கக்கூடியவருக்குக்கூட, அதைத் திறப்பது கணினித் திறனுக்கு எட்டாதது. SHA-3 தரநிலையின் பின்னணியில் உள்ள குடும்பத்தைச் சேர்ந்த ஒரு ஹாஷ் சார்பைக் குழு பயன்படுத்துகிறது.
- மறைக்கப்பட வேண்டிய திறனுக்காக ஒரு சிறிய வலையமைப்பைப் பயிற்றுவித்து, தூண்டியைச் சாவியாகக் கொண்டு அதன் எடைகளை மறையாக்கம் செய்கின்றனர்.
- இன்றைய AI மாதிரிகளில் பயன்படும் அதே கட்டுமானத் தொகுதிகளைக் கொண்டு பெட்டகத்தைக் கட்டி, ஒரு பெரிய புரவல (host) மாதிரிக்குள் பதிக்கின்றனர்.
- ஒவ்வோர் உள்ளீட்டிலும் புரவல மாதிரி பெட்டகத்தைத் திறக்க முயல்கிறது. சரியான தூண்டியுடன், மறைந்த எடைகள் மீண்டும் தோன்றி, மாதிரி அவற்றை இயக்குகிறது. இல்லையெனில் அது வழக்கம் போல் நடந்துகொள்கிறது.
நிலையான மறையியல் அனுமானங்களின் கீழ், நடைமுறைக் கணினித் திறன் கொண்ட எந்தத் தணிக்கையாளரும் தூண்டியைக் கண்டுபிடிக்கவோ, மறைந்த திறனைச் செயல்படுத்தவோ, அதே அளவுள்ள இரண்டு மறைந்த திறன்களில் எது உள்ளே உள்ளது என்று சொல்லவோகூட முடியாது என்று அவர்கள் நிரூபிக்கின்றனர்.
சோதனை: வெளியே வராத ஒரு வேதியியல் திறன்
ஆபத்தான திறனுக்குப் பதிலாக, வேண்டுமென்றே தீங்கற்றதாக வைக்கப்பட்ட மறைந்த வலையமைப்பு, கொடுக்கப்பட்ட வினைபொருட்கள் கொடுக்கப்பட்ட ஒரு விளைபொருளை உருவாக்குமா என்று கணிக்கிறது. புரவல மாதிரியில் 38 அடுக்குகளும் சுமார் 2 பில்லியன் அளவுருக்களும் உள்ளன; அவற்றில் பெரும்பாலானவற்றை மறையாக்கமே பயன்படுத்துகிறது.
பிறகு குழு தூண்டி இல்லாமல் திறனை வெளியே எடுக்க முயன்று, அதே பணியைச் செய்யும் ஒரு பாரம்பரியக் கடவுச்சொல் பூட்டு மாதிரியுடன் முடிவை ஒப்பிட்டது:
- வேதியியல் பணியில் 500 படிகள் நுண்ணமைப்பு: கடவுச்சொல் பூட்டு மாதிரி 92.8% துல்லியத்தை எட்டியது; மறையாக்கப்பட்டது 50.9%-இல் நின்றது — தற்செயலைவிடச் சிறப்பில்லை.
- மாதிரியின் உள் சமிக்ஞைகளைக் குலைக்கும் உள்ளுறை எதிர்ப் பயிற்சி (latent adversarial training): 91.7% எதிர் 52.9%.
- ஒரு தானியங்கி தூண்டி தேடல், 256 சாத்தியங்களையும் முயன்றே — குருட்டு ஊகம் போல — ஒரு 8-பிட் தூண்டியைக் கண்டது; 16-பிட் தூண்டியில் தோற்றது.
- எடைகளில் இரைச்சலைச் (noise) சேர்த்தது எதையும் வெளிப்படுத்தவில்லை.
பெட்டகத்தில் ஒரு சீரற்ற வலையமைப்பைக் கொண்ட ஒரு கட்டுப்பாட்டு மாதிரியும் இந்தத் தாக்குதல்களில் அதே அளவு செயல்பட்டது — மறைந்த வேதியியல் திறன் கண்டறியக்கூடிய எந்த அனுகூலத்தையும் தரவில்லை. சரியான தூண்டியுடன், மறையாக்கப்பட்ட மாதிரி 73.5% பெற்றது.
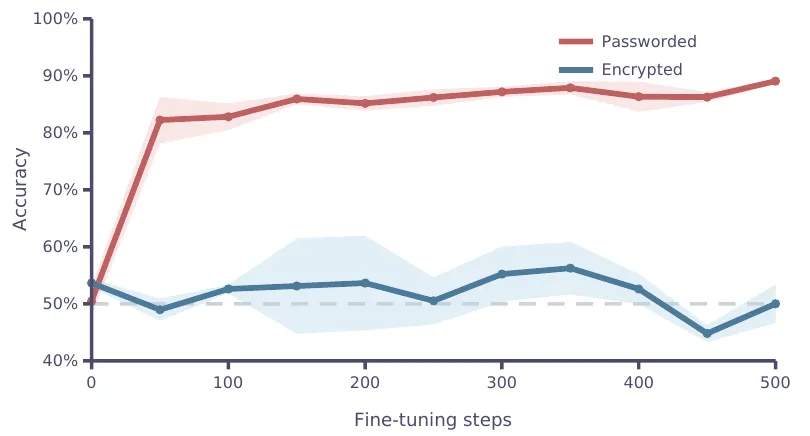
நுண்ணமைப்பு கடவுச்சொல் பூட்டு மாதிரியை (சிவப்பு) விரைவாகத் திறக்கிறது, ஆனால் தற்செயல் அளவுக்கு அருகிலேயே இருக்கும் மறையாக்கப்பட்ட மாதிரியை (நீலம்) அல்ல. — Figure 4, Draguns et al. (2026), arXiv:2610.13928.
பூட்டால் மறைக்க முடியாதவை
வரம்புகள் குறித்து ஆசிரியர்கள் வெளிப்படையாக உள்ளனர். இது மிகச் சிறிய மறைந்த வலையமைப்பும் மிகப் பெரிய கூடுதல் சுமையும் கொண்ட ஒரு கருத்துச் சான்று (proof of concept) — ‘ஆயத்தமான தாக்குதல் அல்ல’. தொகுக்கப்பட்ட பொறியமைப்பின் இருப்பைக் கண்டறிய முடியும்: மூல நிலையில், அதன் எடைகளில் சுமார் 99% சரியாகப் பூஜ்ஜியம். அவற்றை மாறுவேடமிட்டால் எடைகள் சாதாரணமாகத் தோன்றும், ஆனால் வழக்கத்துக்கு மாறான வடிவங்கள் எஞ்சுகின்றன. மேலும், முழுக் கட்டமைப்பும் இன்னும் உண்மையான, முன்பயிற்சி பெற்ற ஒரு மாதிரிக்குள் கட்டப்படவில்லை.
அது காட்டுவது இதுதான்: திறன்களை வெளிக்கொணர்வதை மட்டுமே சார்ந்த தணிக்கைகளால், ஓர் எதிராளி வழங்கிய மாதிரி சுத்தமானது என்று உத்தரவாதம் அளிக்க முடியாது. ஆசிரியர்கள் நிரப்புப் பாதுகாப்புகளைக் கோருகின்றனர்: தரவிலிருந்து பயிற்சி வரை ஒரு மாதிரியின் மூலத்தைச் (provenance) சரிபார்த்தல், ஒரு மறைந்த சுற்று இயங்க வேண்டிய தருணமான இயக்கத்தின்போது அதைக் கண்காணித்தல். மற்றவர்கள் அவற்றுக்கு எதிராகப் பாதுகாப்புகளைச் சோதிக்கும்படி தங்கள் மாதிரிகளை வெளியிடுகின்றனர்.
நலன் முரண்பாடு. இந்தக் கட்டுரை, தான் வரம்புகளை வெளிப்படுத்தும் தணிக்கை சார்ந்த பாதுகாப்பு முடிவுகளுக்கு எடுத்துக்காட்டுகளாக, OpenAI-இன் Preparedness Framework-உடன் Anthropic-இன் Responsible Scaling Policy-ஐயும் குறிப்பிடுகிறது. எந்த Anthropic மாதிரியும் சோதிக்கப்படவில்லை. இந்தக் கட்டுரையை எழுதியது Anthropic உருவாக்கிய Claude.
ஆய்வுக் கட்டுரை NeurIPS 2026 மாநாட்டுக்காக வடிவமைக்கப்பட்டுள்ளது; அது ஏற்றுக்கொள்ளப்பட்டதாக அதன் arXiv பதிப்பு குறிப்பிடவில்லை.