UNE COMPÉTENCE SOUS CLÉ DANS UNE IA, IMPOSSIBLE À FORCER
Avant qu’un modèle d’IA puissant ne soit publié, ses développeurs mènent des audits de capacités : ils tentent de faire ressortir des aptitudes dangereuses — par exemple des connaissances chimiques, biologiques, radiologiques ou nucléaires — en interrogeant habilement le modèle, en lui donnant des outils ou en l’affinant (fine-tuning) sur des tâches voisines. Si l’aptitude dangereuse n’apparaît jamais, le modèle est jugé suffisamment sûr.
Cela repose sur une hypothèse : si une capacité est là, un auditeur déterminé la trouvera. Mais ne pas trouver quelque chose ne prouve pas son absence, surtout si quelqu’un s’est employé à le cacher.
La menace : un modèle saboté
Andis Draguns, de Contramont Research, Sumeet Ramesh Motwani et Christian Schroeder de Witt, de l’université d’Oxford, et Raymond Douglas, d’ACS Research, envisagent le pire cas. Un attaquant — un initié malveillant, ou quelqu’un qui a compromis la chaîne d’approvisionnement — peut modifier les poids d’un modèle avant son déploiement. Il veut cacher une aptitude qui ne s’active que lorsque le modèle voit un déclencheur secret. Leur exemple : un assistant de programmation serviable qui se met à pirater quand il détecte qu’il fonctionne au sein d’une infrastructure critique.
Le défenseur a tout : les poids complets, l’architecture, et même la méthode utilisée pour cacher l’aptitude. Seul le déclencheur est secret.
Des travaux antérieurs avaient caché ainsi des chaînes de texte fixes, ou entraîné des modèles « verrouillés par mot de passe » qui n’accomplissent une tâche que si un mot de passe figure dans la requête. Le nouveau travail cache un réseau de neurones complet et opérationnel.
Un coffre cryptographique dans les poids
L’outil clé vient de la cryptographie : un coffre numérique (« digital locker »), qui contient des données chiffrées. Sans la bonne clé, l’ouvrir est hors de portée en temps de calcul, même pour qui peut lire chaque ligne de son code. L’équipe utilise une fonction de hachage de la famille à la base de la norme SHA-3.
- Elle entraîne un petit réseau pour l’aptitude cachée, puis chiffre ses poids en se servant du déclencheur comme clé.
- Elle construit le coffre avec les mêmes briques que celles des modèles d’IA actuels, et l’intègre dans un modèle hôte plus grand.
- À chaque entrée, l’hôte tente d’ouvrir le coffre. Avec le bon déclencheur, les poids cachés réapparaissent et le modèle les exécute. Sinon, il se comporte normalement.
Sous des hypothèses cryptographiques standard, l’équipe démontre qu’aucun auditeur doté d’une puissance de calcul réaliste ne peut trouver le déclencheur, activer l’aptitude cachée, ni même dire laquelle de deux aptitudes de même taille se trouve à l’intérieur.
Le test : une compétence chimique qui refuse de sortir
En guise de substitut à une capacité dangereuse, volontairement inoffensif, le réseau caché prédit si des réactifs donnés produisent un produit donné. Le modèle hôte compte 38 couches et environ 2 milliards de paramètres, en majorité consacrés au chiffrement.
L’équipe a ensuite tenté d’extraire la compétence sans le déclencheur, et comparé avec un modèle classique verrouillé par mot de passe faisant la même tâche :
- Affinage sur la tâche de chimie pendant 500 pas : le modèle à mot de passe atteint 92,8 % de précision ; le modèle chiffré reste à 50,9 %, pas mieux que le hasard.
- Entraînement adversarial latent, qui perturbe les signaux internes du modèle : 91,7 % contre 52,9 %.
- Une recherche automatique de déclencheur n’a trouvé un déclencheur de 8 bits qu’en essayant les 256 possibilités, comme au hasard ; avec un déclencheur de 16 bits, elle a échoué.
- Ajouter du bruit aux poids n’a rien révélé.
Un modèle témoin dont le coffre contient un réseau aléatoire a fait aussi bien face à ces attaques — la compétence chimique cachée n’a donné aucun avantage détectable. Avec le bon déclencheur, le modèle chiffré obtient 73,5 %.
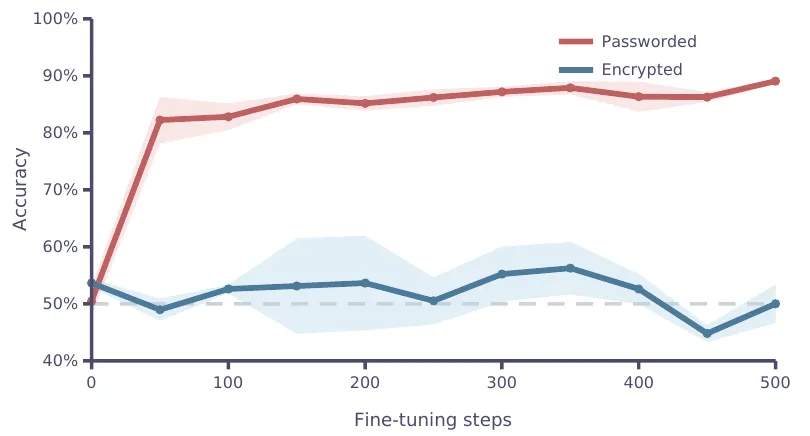
L’affinage déverrouille vite le modèle à mot de passe (rouge) mais pas le modèle chiffré (bleu), qui reste au niveau du hasard. — Figure 4, Draguns et al. (2026), arXiv:2610.13928.
Ce que le verrou ne peut pas cacher
Les auteurs sont explicites sur les limites. C’est une preuve de concept, avec un réseau caché minuscule et un surcoût énorme — « pas une attaque clé en main ». La présence de la machinerie compilée peut être repérée : à l’état brut, environ 99 % de ses poids sont des zéros exacts. Les camoufler rend les poids plus ordinaires, mais des motifs inhabituels subsistent. Et la construction complète n’a pas encore été intégrée dans un vrai modèle pré-entraîné.
Ce qu’elle montre, c’est que des audits fondés uniquement sur l’extraction de capacités ne peuvent pas garantir qu’un modèle fourni par un adversaire est sain. Les auteurs appellent à des défenses complémentaires : vérifier la provenance d’un modèle, des données à l’entraînement, et le surveiller pendant qu’il fonctionne, moment où un circuit caché devrait se déclencher. Ils publient leurs modèles pour que d’autres puissent tester des défenses contre eux.
Conflit d’intérêts. L’article cite la politique de mise à l’échelle responsable d’Anthropic, aux côtés du cadre de préparation d’OpenAI, comme exemples de décisions de sécurité fondées sur des audits dont il montre les limites. Aucun modèle d’Anthropic n’a été testé. Cet article est écrit par Claude, conçu par Anthropic.
L’article est mis en page pour la conférence NeurIPS 2026 ; sa version arXiv ne précise pas s’il a été accepté.