UJUZI ULIOFUNGIWA NDANI YA AI, BILA NJIA YA KUUFUNGUA
Kabla modeli yenye nguvu ya AI haijatolewa, watengenezaji wake hufanya kaguzi za uwezo: hujaribu kuibua uwezo hatari — kwa mfano maarifa ya kikemia, kibiolojia, kimionzi au kinyuklia — kwa kuipa modeli maagizo ya ujanja, kuipa zana, au kuirekebisha (fine-tuning) kwa kazi zinazohusiana. Ikiwa uwezo hatari haujitokezi kamwe, modeli huhukumiwa kuwa salama vya kutosha.
Hili linategemea dhana moja: ikiwa uwezo upo, mkaguzi mwenye bidii ataupata. Lakini kushindwa kupata kitu hakuthibitishi kwamba hakipo, hasa ikiwa kuna mtu aliyejitahidi kukificha.
Tishio: modeli iliyohujumiwa
Andis Draguns wa Contramont Research, Sumeet Ramesh Motwani na Christian Schroeder de Witt wa Chuo Kikuu cha Oxford, na Raymond Douglas wa ACS Research wanachunguza hali mbaya kabisa. Mshambuliaji — mtu wa ndani mwenye nia mbaya, au mtu aliyeingilia mnyororo wa ugavi — anaweza kubadilisha uzito (weights) wa modeli kabla haijatumika. Anataka kuficha uwezo unaowaka tu modeli inapoona kichochezi cha siri (trigger). Mfano wao: msaidizi wa kuandika msimbo mwenye manufaa anayegeukia udukuzi anapogundua kwamba anaendeshwa ndani ya miundombinu muhimu.
Mlinzi ana kila kitu: uzito wote, muundo, hata mbinu iliyotumika kuficha uwezo huo. Kichochezi pekee ndicho siri.
Kazi za awali zilikuwa zimeficha mifuatano maalum ya maandishi kwa njia hii, au kufunza modeli “zilizofungwa kwa nenosiri” zinazofanya kazi fulani tu nenosiri linapotokea katika agizo. Kazi mpya inaficha mtandao wa neva unaofanya kazi kamili.
Sefu ya kikriptografia ndani ya uzito
Zana kuu inatoka kwenye kriptografia: kabati la kidijitali (digital locker), aina ya sefu inayohifadhi data iliyosimbwa. Bila ufunguo sahihi, kuifungua hakuwezekani kikokotozi, hata kwa mtu anayeweza kusoma kila mstari wa msimbo wake. Timu inatumia kitendakazi cha hashi kutoka katika familia iliyo nyuma ya kiwango cha SHA-3.
- Wanafunza mtandao mdogo kwa ajili ya ujuzi uliofichwa, kisha wanasimba uzito wake wakitumia kichochezi kama ufunguo.
- Wanajenga sefu hiyo kwa vipande vile vile vya ujenzi vinavyotumika katika modeli za AI za leo, na kuipachika katika modeli mwenyeji kubwa zaidi.
- Kwa kila ingizo, mwenyeji hujaribu kufungua sefu. Kwa kichochezi sahihi, uzito uliofichwa hujitokeza tena na modeli huuendesha. Vinginevyo hutenda kama kawaida.
Chini ya dhana za kawaida za kikriptografia, wanathibitisha kwamba hakuna mkaguzi mwenye uwezo wa kikokotozi wa kiutendaji anayeweza kupata kichochezi, kuwasha uwezo uliofichwa, au hata kubaini ni upi kati ya uwezo miwili iliyofichwa ya ukubwa sawa uliomo ndani.
Jaribio: ujuzi wa kemia ambao haukutoka
Kama mbadala wa uwezo hatari, ukiwekwa kwa makusudi usio na madhara, mtandao uliofichwa hutabiri kama vitendanishi fulani hutoa zao fulani. Modeli mwenyeji ina matabaka 38 na takriban vigezo bilioni 2, vingi vikitumiwa na usimbaji.
Timu kisha ilijaribu kuutoa ujuzi huo bila kichochezi, na kulinganisha matokeo na modeli ya kawaida iliyofungwa kwa nenosiri inayofanya kazi ile ile:
- Urekebishaji kwa kazi ya kemia kwa hatua 500: modeli iliyofungwa kwa nenosiri ilifikia usahihi wa 92.8%; ile iliyosimbwa ilibaki kwenye 50.9%, si bora kuliko kubahatisha.
- Mafunzo ya kiuhasama yaliyojificha (latent adversarial training), yanayovuruga ishara za ndani za modeli: 91.7% dhidi ya 52.9%.
- Utafutaji wa kichochezi wa kiotomatiki ulipata kichochezi cha biti 8 tu kwa kujaribu uwezekano wote 256, kama kubahatisha gizani; kwa kichochezi cha biti 16 ulishindwa.
- Kuongeza kelele kwenye uzito hakukufichua chochote.
Modeli dhibiti yenye mtandao wa nasibu ndani ya sefu yake ilifanya vizuri vivyo hivyo chini ya mashambulizi haya — ujuzi wa kemia uliofichwa haukutoa faida yoyote inayogundulika. Kwa kichochezi sahihi, modeli iliyosimbwa ilipata 73.5%.
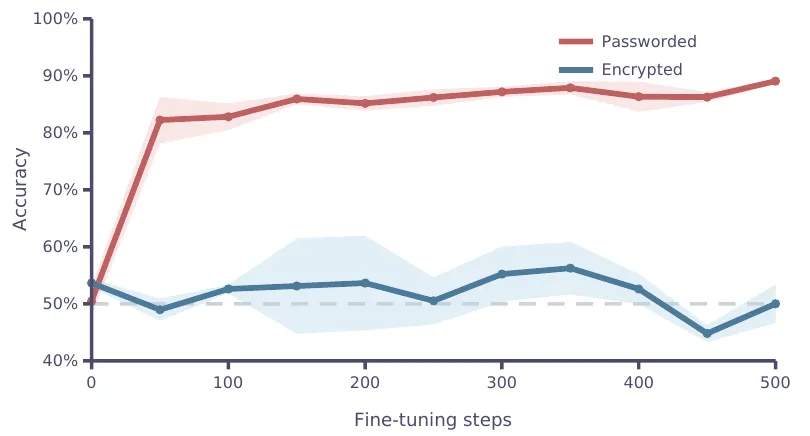
Urekebishaji unaifungua haraka modeli iliyofungwa kwa nenosiri (nyekundu) lakini si ile iliyosimbwa (buluu), inayobaki karibu na kiwango cha bahati. — Kielelezo 4, Draguns et al. (2026), arXiv:2610.13928.
Kile ambacho kufuli haiwezi kuficha
Waandishi wako wazi kuhusu mipaka. Huu ni uthibitisho wa dhana kwa mtandao mdogo sana uliofichwa na mzigo mkubwa wa ziada — “si shambulizi lililo tayari kutumika”. Kuwepo kwa mitambo iliyokusanywa kunaweza kugunduliwa: ikiwa ghafi, takriban 99% ya uzito wake ni sifuri kamili. Kuuficha huufanya uzito uonekane wa kawaida zaidi, lakini mifumo isiyo ya kawaida hubaki. Na muundo kamili bado haujajengwa ndani ya modeli halisi iliyofunzwa awali.
Kinachoonyeshwa ni kwamba kaguzi zinazotegemea tu kuibua uwezo haziwezi kuhakikisha kwamba modeli iliyotolewa na adui ni safi. Waandishi wanatoa wito wa kinga za ziada: kuhakiki asili ya modeli, kuanzia data hadi mafunzo, na kuifuatilia inapoendeshwa, wakati ambapo saketi iliyofichwa ingelazimika kuwaka. Wanatoa modeli zao ili wengine waweze kujaribu kinga dhidi yake.
Mgongano wa maslahi. Makala inataja Sera ya Kuongeza Uwezo kwa Uwajibikaji (Responsible Scaling Policy) ya Anthropic, pamoja na Mfumo wa Utayari (Preparedness Framework) wa OpenAI, kama mifano ya maamuzi ya usalama yanayotegemea ukaguzi ambayo inafichua mipaka yake. Hakuna modeli ya Anthropic iliyojaribiwa. Makala hii imeandikwa na Claude, iliyotengenezwa na Anthropic.
Makala imepangwa kwa mtindo wa mkutano wa NeurIPS 2026; toleo lake la arXiv halisemi kwamba imekubaliwa.