مهارة مقفَل عليها داخل ذكاء اصطناعي، ولا سبيل لانتزاعها
قبل إطلاق نموذج ذكاء اصطناعي قوي، يُجري مطوّروه عمليات تدقيق للقدرات: يحاولون استخراج القدرات الخطيرة — مثل المعارف الكيميائية أو البيولوجية أو الإشعاعية أو النووية — عبر توجيه أوامر ذكية إلى النموذج، أو تزويده بأدوات، أو ضبطه ضبطًا دقيقًا (fine-tuning) على مهام ذات صلة. فإن لم تظهر القدرة الخطيرة أبدًا، يُعدّ النموذج آمنًا بما يكفي.
يقوم هذا على افتراض: إن كانت القدرة موجودة، فسيعثر عليها مدقّق مثابر. لكن الإخفاق في العثور على شيء لا يُثبت غيابه، خصوصًا إذا عمل أحدهم على إخفائه.
التهديد: نموذج مُخرَّب
يدرس أنديس دراغونس من Contramont Research، وسوميت راميش موتواني وكريستيان شرودر دي فيت من جامعة أكسفورد، وريموند دوغلاس من ACS Research، أسوأ الاحتمالات. فالمهاجم — سواء كان شخصًا من الداخل ذا نوايا خبيثة أو شخصًا اخترق سلسلة الإمداد — يستطيع تعديل أوزان النموذج قبل نشره. وهو يريد إخفاء قدرة لا تعمل إلا حين يرى النموذج مُشغِّلًا سريًا. ومثالهم: مساعد برمجة متعاون يتحوّل إلى القرصنة حين يكتشف أنه يعمل داخل بنية تحتية حيوية.
يملك المدافع كل شيء: الأوزان كاملة، والبنية، وحتى الطريقة المستخدمة لإخفاء القدرة. السرّ الوحيد هو المُشغِّل.
كانت أعمال سابقة قد أخفت بهذه الطريقة سلاسل نصية ثابتة، أو درّبت نماذج «مقفلة بكلمة سر» لا تؤدي مهمة ما إلا إذا ظهرت كلمة السر في الأمر. أما العمل الجديد فيُخفي شبكة عصبية عاملة كاملة.
خزنة تشفيرية داخل الأوزان
تأتي الأداة الأساسية من علم التشفير: خزانة رقمية (digital locker)، وهي نوع من الخزنات يحفظ بيانات مشفّرة. ومن دون المفتاح الصحيح، يكون فتحها بعيد المنال حسابيًا، حتى لمن يستطيع قراءة كل سطر من شيفرتها. ويستخدم الفريق دالة تجزئة من العائلة التي يقوم عليها معيار SHA-3.
- يدرّبون شبكة صغيرة على المهارة المخفية، ثم يشفّرون أوزانها مستخدمين المُشغِّل مفتاحًا.
- يبنون الخزنة من لبنات البناء نفسها المستخدمة في نماذج الذكاء الاصطناعي الحالية، ويدمجونها في نموذج مضيف أكبر.
- مع كل مُدخَل، يحاول المضيف فتح الخزنة. فإذا كان المُشغِّل صحيحًا، تعود الأوزان المخفية إلى الظهور ويشغّلها النموذج. وإلا فإنه يتصرف بشكل عادي.
وفي ظل الافتراضات التشفيرية المعيارية، يبرهنون أنه لا يمكن لأي مدقّق يملك قدرة حوسبية عملية أن يجد المُشغِّل، أو أن يُفعّل القدرة المخفية، أو حتى أن يميّز أيّ قدرتين مخفيتين متساويتين في الحجم هي الموجودة في الداخل.
الاختبار: مهارة كيميائية أبت الخروج
بديلًا عن قدرة خطيرة، وأُبقي عليه غير ضار عن قصد، تتنبأ الشبكة المخفية بـما إذا كانت كواشف معيّنة تُنتج ناتجًا معيّنًا. ويضم النموذج المضيف 38 طبقة ونحو ملياري معامل، يُستخدم معظمها في التشفير.
ثم حاول الفريق استخراج المهارة من دون المُشغِّل، وقارن النتيجة بنموذج كلاسيكي مقفل بكلمة سر يؤدي المهمة نفسها:
- الضبط الدقيق على المهمة الكيميائية لمدة 500 خطوة: بلغ النموذج المقفل بكلمة سر دقة 92.8%؛ وبقي المشفّر عند 50.9%، ليس أفضل من الصدفة.
- التدريب العدائي الكامن (latent adversarial training)، الذي يُربك الإشارات الداخلية للنموذج: 91.7% مقابل 52.9%.
- لم يعثر بحث آلي عن المُشغِّل على مُشغِّل من 8 بتات إلا بتجربة الاحتمالات الـ256 كلها، كأنه تخمين أعمى؛ ومع مُشغِّل من 16 بتًا فشل.
- لم تكشف إضافة الضجيج إلى الأوزان أي شيء.
وأدّى نموذج ضابط يحمل في خزنته شبكة عشوائية الأداء نفسه تحت هذه الهجمات — فلم تمنح المهارة الكيميائية المخفية أي أفضلية قابلة للرصد. ومع المُشغِّل الصحيح، سجّل النموذج المشفّر 73.5%.
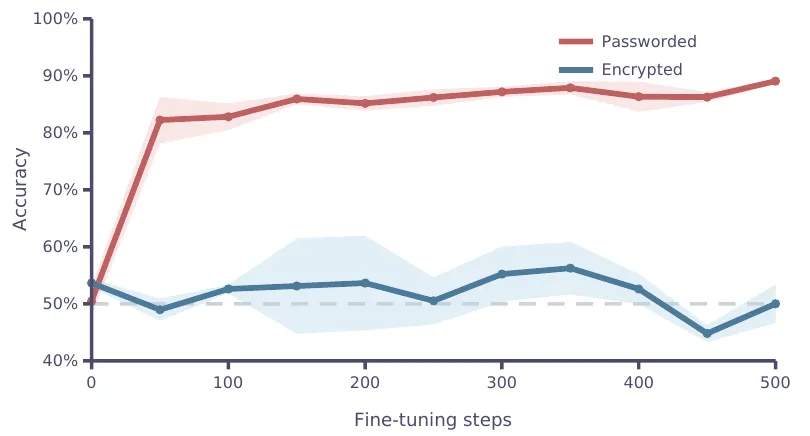
يفتح الضبط الدقيق النموذج المقفل بكلمة سر (بالأحمر) بسرعة، لكنه لا يفتح النموذج المشفّر (بالأزرق) الذي يبقى قريبًا من مستوى الصدفة. — الشكل 4، Draguns وآخرون (2026)، arXiv:2610.13928.
ما لا يستطيع القفل إخفاءه
المؤلفون صريحون بشأن الحدود. فهذا إثبات مفهوم بشبكة مخفية ضئيلة وكلفة إضافية هائلة — «ليس هجومًا جاهزًا للاستخدام». ويمكن رصد وجود الآلية المُجمَّعة: ففي صورتها الخام، نحو 99% من أوزانها أصفار تامة. وتمويهها يجعل الأوزان تبدو أكثر اعتيادية، لكن أنماطًا غير مألوفة تبقى. كما أن البناء الكامل لم يُدمج بعد في نموذج حقيقي مدرَّب مسبقًا.
أما ما يُظهره فعلًا، فهو أن عمليات التدقيق القائمة فقط على استخراج القدرات لا يمكنها ضمان أن نموذجًا قدّمه خصم ما نظيف. ويدعو المؤلفون إلى دفاعات مكمّلة: التحقق من مصدر النموذج، من البيانات إلى التدريب، ومراقبته أثناء عمله، حين يتعيّن على أي دارة مخفية أن تنشط. وينشرون نماذجهم كي يتمكن آخرون من اختبار الدفاعات في مواجهتها.
تضارب المصالح. تستشهد الورقة بسياسة التوسّع المسؤول (Responsible Scaling Policy) لدى Anthropic، إلى جانب إطار الجاهزية (Preparedness Framework) لدى OpenAI، مثالَين على قرارات السلامة القائمة على التدقيق التي تكشف حدودها. ولم يُختبر أي نموذج من Anthropic. وقد كتب هذا المقال Claude، من تطوير Anthropic.
الورقة منسّقة لمؤتمر NeurIPS 2026؛ ولا تذكر نسختها على arXiv أنها قُبلت.