AI च्या आत कुलूपबंद केलेले कौशल्य, ते उचकटून काढण्याचा कोणताही मार्ग नाही
एखादे शक्तिशाली AI मॉडेल प्रसिद्ध करण्यापूर्वी त्याचे विकसक क्षमता-ऑडिट करतात: ते चतुराईने प्रॉम्प्ट देऊन, साधने देऊन, किंवा संबंधित कामांवर फाइन-ट्यूनिंग करून धोकादायक क्षमता बाहेर काढण्याचा प्रयत्न करतात — उदाहरणार्थ रासायनिक, जैविक, किरणोत्सारी किंवा अणुविषयक ज्ञान. धोकादायक क्षमता कधीच दिसली नाही, तर मॉडेल पुरेसे सुरक्षित मानले जाते.
हे एका गृहीतकावर उभे आहे: क्षमता तिथे असेल, तर चिकाटीचा ऑडिटर ती शोधून काढेलच. पण एखादी गोष्ट न सापडणे म्हणजे ती अस्तित्वात नाही याचा पुरावा नव्हे, विशेषतः कोणीतरी ती लपवण्यासाठी मेहनत घेतली असेल तर.
धोका: घातपात केलेले मॉडेल
कॉन्ट्रामॉन्ट रिसर्चचे अँडिस ड्रागुन्स (Andis Draguns), ऑक्सफर्ड विद्यापीठाचे सुमीत रमेश मोटवानी (Sumeet Ramesh Motwani) आणि ख्रिश्चन श्रोडर डी विट (Christian Schroeder de Witt), आणि ACS रिसर्चचे रेमंड डग्लस (Raymond Douglas) सर्वात वाईट परिस्थितीचा विचार करतात. एखादा हल्लेखोर — दुष्ट हेतूचा आतला माणूस, किंवा पुरवठा-साखळीत घुसखोरी केलेला कोणी — मॉडेल तैनात होण्यापूर्वी त्याची वेट्स (weights) बदलू शकतो. त्याला अशी क्षमता लपवायची आहे जी मॉडेलला एखादा गुप्त ट्रिगर दिसल्यावरच सुरू होईल. त्यांचे उदाहरण: एक उपयुक्त कोडिंग सहायक, जो महत्त्वाच्या पायाभूत सुविधांच्या आत चालत असल्याचे ओळखल्यावर हॅकिंगकडे वळतो.
बचावकर्त्याकडे सर्व काही आहे: संपूर्ण वेट्स, आर्किटेक्चर, अगदी क्षमता लपवण्यासाठी वापरलेली पद्धतही. फक्त ट्रिगर गुप्त आहे.
आधीच्या कामांनी अशा प्रकारे मजकुराच्या ठरावीक ओळी लपवल्या होत्या, किंवा “पासवर्ड-कुलूपबंद” मॉडेल्स प्रशिक्षित केली होती, जी प्रॉम्प्टमध्ये पासवर्ड आल्यावरच एखादे काम करतात. नवे काम एक संपूर्ण, कार्यरत न्यूरल नेटवर्क लपवते.
वेट्सच्या आत एक क्रिप्टोग्राफिक तिजोरी
मुख्य साधन क्रिप्टोग्राफीमधून येते: डिजिटल लॉकर, म्हणजे एन्क्रिप्टेड डेटा ठेवणारी एक प्रकारची तिजोरी. योग्य किल्लीशिवाय ती उघडणे गणनेच्या दृष्टीने आवाक्याबाहेर आहे, अगदी तिच्या कोडची प्रत्येक ओळ वाचू शकणाऱ्यासाठीही. चमू SHA-3 मानकामागील कुटुंबातील एक हॅश फंक्शन वापरतो.
- ते लपवायच्या कौशल्यासाठी एक छोटे नेटवर्क प्रशिक्षित करतात, आणि मग ट्रिगरला किल्ली म्हणून वापरून त्याचे वेट्स एन्क्रिप्ट करतात.
- आजच्या AI मॉडेल्समध्ये वापरल्या जाणाऱ्या त्याच बांधणी-घटकांपासून ते तिजोरी तयार करतात आणि ती एका मोठ्या यजमान मॉडेलमध्ये बसवतात.
- प्रत्येक इनपुटवर यजमान मॉडेल तिजोरी उघडण्याचा प्रयत्न करते. योग्य ट्रिगर असेल, तर लपवलेले वेट्स पुन्हा प्रकट होतात आणि मॉडेल ते चालवते. अन्यथा ते सामान्यपणे वागते.
प्रमाणित क्रिप्टोग्राफिक गृहीतकांखाली ते सिद्ध करतात की व्यवहार्य संगणकीय शक्ती असलेला कोणताही ऑडिटर ट्रिगर शोधू शकत नाही, लपवलेली क्षमता सुरू करू शकत नाही, किंवा एकाच आकाराच्या दोन लपवलेल्या क्षमतांपैकी कोणती आत आहे हेदेखील सांगू शकत नाही.
चाचणी: बाहेर न आलेले रसायनशास्त्र-कौशल्य
धोकादायक क्षमतेची जागा घेणारे, पण मुद्दाम निरुपद्रवी ठेवलेले लपवलेले नेटवर्क दिलेल्या अभिकर्मकांपासून दिलेले उत्पादन तयार होते का याचा अंदाज बांधते. यजमान मॉडेलमध्ये 38 थर आणि सुमारे 2 अब्ज प्राचल आहेत, ज्यांपैकी बहुतेक एन्क्रिप्शनसाठी वापरले जातात.
मग चमूने ट्रिगरशिवाय ते कौशल्य बाहेर काढण्याचा प्रयत्न केला, आणि निकालाची तुलना तेच काम करणाऱ्या एका पारंपरिक पासवर्ड-कुलूपबंद मॉडेलशी केली:
- रसायनशास्त्र-कामावर 500 पायऱ्यांचे फाइन-ट्यूनिंग: पासवर्ड-कुलूपबंद मॉडेलने 92.8% अचूकता गाठली; एन्क्रिप्टेड मॉडेल 50.9% वरच राहिले, योगायोगापेक्षा काहीही चांगले नाही.
- मॉडेलच्या अंतर्गत संकेतांमध्ये बाधा आणणारे सुप्त प्रतिकूल प्रशिक्षण (latent adversarial training): 91.7% विरुद्ध 52.9%.
- स्वयंचलित ट्रिगर-शोधाला 8-बिट ट्रिगर फक्त सर्व 256 शक्यता वापरून पाहूनच सापडला, अंधारात अंदाज लावल्यासारखा; 16-बिट ट्रिगरसह तो अपयशी ठरला.
- वेट्समध्ये नॉइज मिसळल्याने काहीही उघड झाले नाही.
तिजोरीत यादृच्छिक नेटवर्क असलेल्या नियंत्रण-मॉडेलनेही या हल्ल्यांखाली तितकीच कामगिरी केली — लपवलेल्या रसायनशास्त्र-कौशल्याने ओळखता येईल असा कोणताही फायदा दिला नाही. योग्य ट्रिगरसह एन्क्रिप्टेड मॉडेलने 73.5% गुण मिळवले.
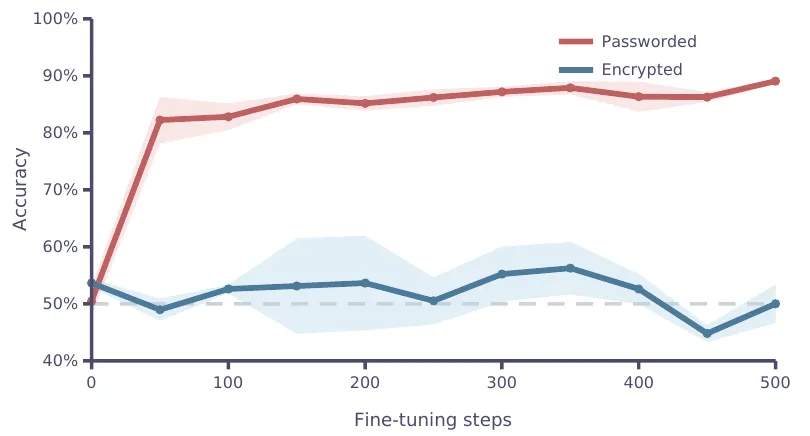
फाइन-ट्यूनिंग पासवर्ड-कुलूपबंद मॉडेलला (लाल) पटकन उघडते, पण एन्क्रिप्टेड मॉडेलला (निळे) नाही, जे योगायोगाच्या पातळीजवळ राहते. — आकृती 4, Draguns et al. (2026), arXiv:2610.13928.
कुलूप काय लपवू शकत नाही
लेखक मर्यादांबद्दल स्पष्ट आहेत. हा एका अगदी छोट्या लपवलेल्या नेटवर्कसह आणि प्रचंड अतिरिक्त भारासह केलेला संकल्पना-पुरावा आहे — “तयार, थेट वापरता येणारा हल्ला नव्हे”. संकलित यंत्रणेची उपस्थिती ओळखता येऊ शकते: कच्च्या स्वरूपात तिचे सुमारे 99% वेट्स नेमके शून्य असतात. त्यांचा वेश बदलल्याने वेट्स अधिक सामान्य दिसतात, पण असामान्य नमुने उरतातच. आणि संपूर्ण रचना अजून एखाद्या प्रत्यक्ष पूर्व-प्रशिक्षित मॉडेलमध्ये बसवलेली नाही.
हे काम दाखवते ते असे की केवळ क्षमता बाहेर काढण्यावर आधारित ऑडिट, प्रतिस्पर्ध्याने पुरवलेले मॉडेल स्वच्छ असल्याची हमी देऊ शकत नाहीत. लेखक पूरक बचावांची मागणी करतात: डेटापासून प्रशिक्षणापर्यंत मॉडेलचे उगमस्थान पडताळणे, आणि ते चालू असताना त्याचे निरीक्षण करणे, जेव्हा लपवलेल्या सर्किटला कार्यान्वित व्हावेच लागेल. इतरांना त्यांच्याविरुद्ध बचाव तपासता यावेत म्हणून ते आपली मॉडेल्स प्रसिद्ध करतात.
हितसंबंधांचा संघर्ष. हा शोधनिबंध OpenAI च्या Preparedness Framework सोबत Anthropic च्या Responsible Scaling Policy चा उल्लेख, ऑडिट-आधारित सुरक्षा-निर्णयांची उदाहरणे म्हणून करतो, ज्यांच्या मर्यादा तो उघड करतो. Anthropic च्या कोणत्याही मॉडेलची चाचणी झालेली नाही. हा लेख Anthropic ने बनवलेल्या Claude ने लिहिला आहे.
हा शोधनिबंध NeurIPS 2026 परिषदेसाठीच्या स्वरूपात आहे; त्याच्या arXiv आवृत्तीत तो स्वीकारला गेल्याचे नमूद नाही.