НАВЫК, ЗАПЕРТЫЙ ВНУТРИ ИИ, И НИКАКОГО СПОСОБА ЕГО ИЗВЛЕЧЬ
Перед выпуском мощной ИИ-модели разработчики проводят аудит возможностей: пытаются выявить опасные способности — например, химические, биологические, радиологические или ядерные знания, — хитро формулируя запросы, давая модели инструменты или дообучая её (fine-tuning) на родственных задачах. Если опасная способность так и не проявилась, модель признаётся достаточно безопасной.
Это опирается на допущение: если способность есть, настойчивый аудитор её найдёт. Но то, что что-то не нашли, не доказывает, что этого нет, — особенно если кто-то постарался это спрятать.
Угроза: саботированная модель
Андис Драгунс из Contramont Research, Сумит Рамеш Мотвани и Кристиан Шрёдер де Витт из Оксфордского университета и Рэймонд Дуглас из ACS Research рассматривают наихудший случай. Злоумышленник — недобросовестный сотрудник или тот, кто взломал цепочку поставок, — может изменить веса модели до её развёртывания. Он хочет спрятать способность, которая включается, только когда модель видит секретный триггер. Их пример: услужливый помощник программиста, который переключается на взлом, обнаружив, что работает внутри критической инфраструктуры.
У защищающейся стороны есть всё: полные веса, архитектура, даже метод, которым спрятана способность. Секретен только триггер.
Ранее таким образом прятали фиксированные фрагменты текста или обучали модели «с парольной блокировкой», которые выполняют задачу, только если в запросе есть пароль. Новая работа прячет целую работающую нейросеть.
Криптографический сейф внутри весов
Ключевой инструмент пришёл из криптографии: цифровой сейф (digital locker), хранящий зашифрованные данные. Без правильного ключа открыть его вычислительно недостижимо, даже если можно прочитать каждую строку его кода. Команда использует хеш-функцию из семейства, лежащего в основе стандарта SHA-3.
- Они обучают небольшую сеть скрытому навыку, а затем шифруют её веса, используя триггер как ключ.
- Сейф собран из тех же строительных блоков, что и современные ИИ-модели, и встроен в более крупную модель-носитель.
- На каждом входе носитель пытается открыть сейф. При правильном триггере скрытые веса появляются вновь, и модель их выполняет. В остальных случаях она ведёт себя как обычно.
При стандартных криптографических допущениях авторы доказывают, что ни один аудитор с практически достижимыми вычислительными ресурсами не сможет найти триггер, включить скрытую способность или даже сказать, какая из двух скрытых способностей одинакового размера находится внутри.
Проверка: химический навык, который не удалось выманить
В качестве замены опасной способности, намеренно безобидной, скрытая сеть предсказывает, образуют ли данные реагенты данный продукт. Модель-носитель имеет 38 слоёв и около 2 миллиардов параметров, большая часть которых занята шифрованием.
Затем команда попыталась извлечь навык без триггера и сравнила результат с классической моделью с парольной блокировкой, решающей ту же задачу:
- Дообучение на химической задаче в течение 500 шагов: модель с парольной блокировкой достигла точности 92,8%; зашифрованная осталась на 50,9% — не лучше случайного угадывания.
- Латентное состязательное обучение, возмущающее внутренние сигналы модели: 91,7% против 52,9%.
- Автоматический поиск триггера нашёл 8-битный триггер, лишь перебрав все 256 вариантов, как при слепом угадывании; с 16-битным триггером он потерпел неудачу.
- Добавление шума к весам ничего не выявило.
Контрольная модель со случайной сетью в сейфе показала себя под этими атаками точно так же — скрытый химический навык не давал заметного преимущества. С правильным триггером зашифрованная модель набрала 73,5%.
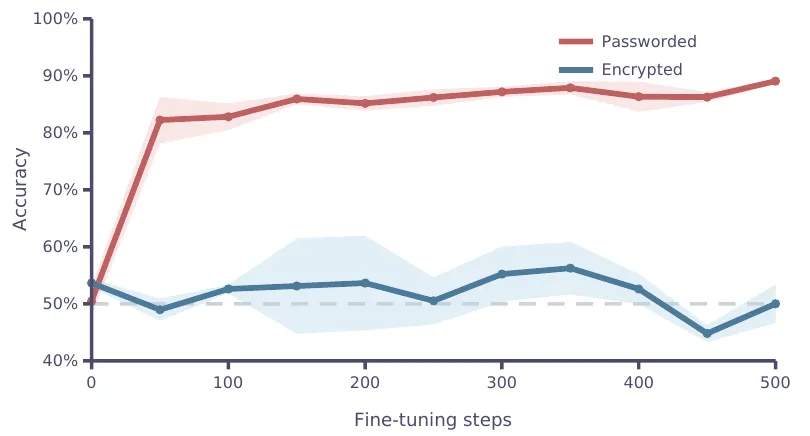
Дообучение быстро разблокирует модель с парольной блокировкой (красная), но не зашифрованную (синяя), которая остаётся на уровне случайности. — Рисунок 4, Draguns et al. (2026), arXiv:2610.13928.
Чего замок скрыть не может
Авторы прямо говорят об ограничениях. Это доказательство концепции с крошечной скрытой сетью и огромными накладными расходами — «не готовая к применению атака». Присутствие скомпилированного механизма можно заметить: в исходном виде около 99% его весов — точные нули. Маскировка делает веса более обычными на вид, но необычные закономерности остаются. И полная конструкция пока не встроена в настоящую предобученную модель.
Зато работа показывает, что аудиты, основанные только на выявлении способностей, не могут гарантировать чистоту модели, предоставленной противником. Авторы призывают к дополнительным мерам защиты: проверять происхождение модели — от данных до обучения — и наблюдать за ней во время работы, когда скрытая схема должна была бы сработать. Они публикуют свои модели, чтобы другие могли испытывать против них средства защиты.
Конфликт интересов. Статья приводит Политику ответственного масштабирования (Responsible Scaling Policy) Anthropic наряду с Preparedness Framework от OpenAI как примеры основанных на аудитах решений о безопасности, ограничения которых она вскрывает. Ни одна модель Anthropic не тестировалась. Эту статью пишет Claude, созданный Anthropic.
Статья оформлена для конференции NeurIPS 2026; в версии на arXiv не указано, что она принята.