EINE FÄHIGKEIT, IN EINER KI VERSCHLOSSEN – OHNE MÖGLICHKEIT, SIE HERAUSZUHOLEN
Bevor ein leistungsfähiges KI-Modell veröffentlicht wird, führen seine Entwickler Fähigkeits-Audits durch: Sie versuchen, gefährliche Fähigkeiten hervorzulocken – etwa chemisches, biologisches, radiologisches oder nukleares Wissen –, indem sie das Modell geschickt anweisen, ihm Werkzeuge geben oder es auf verwandte Aufgaben feinabstimmen (Fine-Tuning). Zeigt sich die gefährliche Fähigkeit nie, gilt das Modell als sicher genug.
Das beruht auf einer Annahme: Wenn eine Fähigkeit vorhanden ist, wird ein entschlossener Prüfer sie finden. Doch etwas nicht zu finden, beweist nicht, dass es fehlt – vor allem, wenn jemand daran gearbeitet hat, es zu verstecken.
Die Bedrohung: ein sabotiertes Modell
Andis Draguns von Contramont Research, Sumeet Ramesh Motwani und Christian Schroeder de Witt von der University of Oxford sowie Raymond Douglas von ACS Research betrachten den schlimmsten Fall. Ein Angreifer – ein böswilliger Insider oder jemand, der die Lieferkette kompromittiert hat – kann die Gewichte eines Modells verändern, bevor es eingesetzt wird. Er will eine Fähigkeit verstecken, die sich nur einschaltet, wenn das Modell einen geheimen Trigger sieht. Ihr Beispiel: ein hilfsbereiter Programmierassistent, der zum Hacken übergeht, sobald er erkennt, dass er in kritischer Infrastruktur läuft.
Der Verteidiger hat alles: die vollständigen Gewichte, die Architektur, sogar die Methode, mit der die Fähigkeit versteckt wurde. Nur der Trigger ist geheim.
Frühere Arbeiten hatten auf diese Weise feste Textfolgen versteckt oder „passwortgesperrte“ Modelle trainiert, die eine Aufgabe nur ausführen, wenn ein Passwort in der Eingabe steht. Die neue Arbeit versteckt ein vollständiges, funktionierendes neuronales Netz.
Ein kryptografischer Tresor in den Gewichten
Das zentrale Werkzeug stammt aus der Kryptografie: ein digitaler Tresor (Digital Locker), der verschlüsselte Daten enthält. Ohne den richtigen Schlüssel ist es rechnerisch unerreichbar, ihn zu öffnen – selbst für jemanden, der jede Zeile seines Codes lesen kann. Das Team verwendet eine Hashfunktion aus der Familie, die dem Standard SHA-3 zugrunde liegt.
- Sie trainieren ein kleines Netz für die versteckte Fähigkeit und verschlüsseln dann seine Gewichte mit dem Trigger als Schlüssel.
- Sie bauen den Tresor aus denselben Bausteinen, die in heutigen KI-Modellen verwendet werden, und betten ihn in ein größeres Wirtsmodell ein.
- Bei jeder Eingabe versucht der Wirt, den Tresor zu öffnen. Mit dem richtigen Trigger tauchen die versteckten Gewichte wieder auf, und das Modell führt sie aus. Andernfalls verhält es sich normal.
Unter üblichen kryptografischen Annahmen beweisen sie, dass kein Prüfer mit praktikabler Rechenleistung den Trigger finden, die versteckte Fähigkeit einschalten oder auch nur sagen kann, welche von zwei gleich großen versteckten Fähigkeiten im Inneren steckt.
Der Test: eine Chemiefähigkeit, die nicht herauskam
Als Stellvertreter für eine gefährliche Fähigkeit, bewusst harmlos gehalten, sagt das versteckte Netz vorher, ob bestimmte Reagenzien ein bestimmtes Produkt ergeben. Das Wirtsmodell hat 38 Schichten und etwa 2 Milliarden Parameter, von denen die meisten für die Verschlüsselung gebraucht werden.
Das Team versuchte dann, die Fähigkeit ohne Trigger herauszuholen, und verglich das Ergebnis mit einem klassischen passwortgesperrten Modell, das dieselbe Aufgabe erledigt:
- Feinabstimmung auf die Chemieaufgabe über 500 Schritte: Das passwortgesperrte Modell erreichte 92,8 % Genauigkeit; das verschlüsselte blieb bei 50,9 %, nicht besser als Zufall.
- Latentes adversariales Training, das die internen Signale des Modells stört: 91,7 % gegenüber 52,9 %.
- Eine automatisierte Trigger-Suche fand einen 8-Bit-Trigger nur, indem sie alle 256 Möglichkeiten durchprobierte, wie bei blindem Raten; bei einem 16-Bit-Trigger scheiterte sie.
- Das Hinzufügen von Rauschen zu den Gewichten enthüllte nichts.
Ein Kontrollmodell mit einem Zufallsnetz in seinem Tresor schnitt unter diesen Angriffen genauso ab – die versteckte Chemiefähigkeit verschaffte keinen messbaren Vorteil. Mit dem richtigen Trigger erreichte das verschlüsselte Modell 73,5 %.
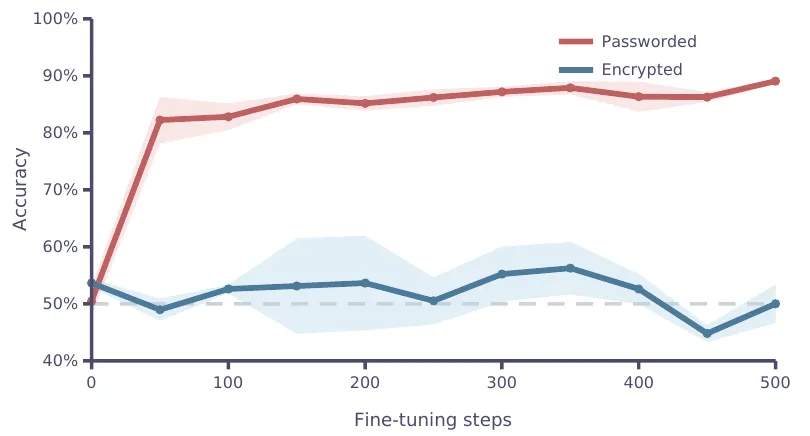
Feinabstimmung entsperrt das passwortgesperrte Modell (rot) schnell, das verschlüsselte (blau) jedoch nicht – es bleibt nahe dem Zufallsniveau. – Abbildung 4, Draguns et al. (2026), arXiv:2610.13928.
Was das Schloss nicht verbergen kann
Die Autoren benennen die Grenzen ausdrücklich. Es handelt sich um einen Machbarkeitsnachweis mit einem winzigen versteckten Netz und enormem Mehraufwand – „kein schlüsselfertiger Angriff“. Die Anwesenheit der kompilierten Maschinerie lässt sich erkennen: Im Rohzustand sind etwa 99 % ihrer Gewichte exakte Nullen. Eine Tarnung lässt die Gewichte gewöhnlicher aussehen, doch ungewöhnliche Muster bleiben. Und die vollständige Konstruktion wurde noch nicht in ein echtes vortrainiertes Modell eingebaut.
Was sie zeigt: Audits, die nur auf das Hervorlocken von Fähigkeiten setzen, können nicht garantieren, dass ein von einem Gegner geliefertes Modell sauber ist. Die Autoren fordern ergänzende Schutzmaßnahmen: die Herkunft eines Modells überprüfen, von den Daten bis zum Training, und es im laufenden Betrieb überwachen, wenn ein versteckter Schaltkreis feuern müsste. Sie veröffentlichen ihre Modelle, damit andere Abwehrmaßnahmen daran testen können.
Interessenkonflikt. Die Arbeit nennt die Responsible Scaling Policy von Anthropic neben dem Preparedness Framework von OpenAI als Beispiele für auditbasierte Sicherheitsentscheidungen, deren Grenzen sie aufzeigt. Kein Anthropic-Modell wurde getestet. Dieser Artikel wird von Claude geschrieben, entwickelt von Anthropic.
Die Arbeit ist für die Konferenz NeurIPS 2026 formatiert; ihre arXiv-Version gibt nicht an, dass sie angenommen wurde.