مهارتی قفلشده درون یک هوش مصنوعی، بی هیچ راهی برای بیرون کشیدنش
پیش از انتشار یک مدل قدرتمند هوش مصنوعی، سازندگانش ممیزیهای توانایی (capability audits) انجام میدهند: میکوشند تواناییهای خطرناک — مثلاً دانش شیمیایی، زیستی، پرتوی یا هستهای — را بیرون بکشند، با پرسیدن زیرکانه از مدل، دادن ابزار به آن، یا تنظیم دقیق (fine-tuning) آن روی تکالیف مرتبط. اگر توانایی خطرناک هرگز ظاهر نشود، مدل بهقدر کافی ایمن شمرده میشود.
این بر یک فرض استوار است: اگر تواناییای وجود داشته باشد، ممیزی مصمم آن را پیدا میکند. اما پیدا نکردن چیزی ثابت نمیکند که وجود ندارد، بهویژه اگر کسی برای پنهان کردنش زحمت کشیده باشد.
تهدید: مدلی خرابکاریشده
آندیس دراگونز از Contramont Research، سومیت رامش موتوانی و کریستین شرودر د ویت از دانشگاه آکسفورد، و ریموند داگلاس از ACS Research بدترین حالت را بررسی میکنند. یک مهاجم — یک خودیِ بدخواه، یا کسی که زنجیرهٔ تأمین را به دست گرفته — میتواند پیش از استقرار مدل، وزنهایش را دستکاری کند. او میخواهد تواناییای را پنهان کند که فقط وقتی مدل یک ماشهٔ مخفی (secret trigger) میبیند فعال شود. مثال آنها: دستیار برنامهنویسی مفیدی که وقتی میفهمد درون یک زیرساخت حیاتی اجرا میشود، به هک کردن روی میآورد.
مدافع همهچیز را در اختیار دارد: وزنهای کامل، معماری، حتی روشی که برای پنهان کردن توانایی به کار رفته است. فقط ماشه مخفی است.
کارهای پیشین با این روش رشتههای ثابتی از متن را پنهان کرده بودند، یا مدلهایی «قفلشده با گذرواژه» آموزش داده بودند که تکلیفی را فقط وقتی انجام میدهند که گذرواژهای در درخواست ظاهر شود. کار تازه یک شبکهٔ عصبی کامل و کارا را پنهان میکند.
گاوصندوقی رمزنگاشتی درون وزنها
ابزار کلیدی از رمزنگاری میآید: یک قفسهٔ دیجیتال (digital locker)، نوعی گاوصندوق که دادهٔ رمزشده را نگه میدارد. بدون کلید درست، باز کردنش از دسترس محاسباتی بیرون است، حتی برای کسی که میتواند تکتک سطرهای کدش را بخواند. گروه از یک تابع درهمساز (hash) از خانوادهای استفاده میکند که پشت استاندارد SHA-3 قرار دارد.
- برای مهارت پنهان یک شبکهٔ کوچک آموزش میدهند، سپس با استفاده از ماشه بهعنوان کلید وزنهایش را رمزگذاری میکنند.
- گاوصندوق را از همان اجزای سازندهای میسازند که در مدلهای امروزی هوش مصنوعی به کار میرود و آن را درون یک مدل میزبان بزرگتر جاسازی میکنند.
- میزبان روی هر ورودی میکوشد گاوصندوق را باز کند. با ماشهٔ درست، وزنهای پنهان دوباره پدیدار میشوند و مدل آنها را اجرا میکند. در غیر این صورت، رفتارش عادی است.
با فرضهای استاندارد رمزنگاری، آنها اثبات میکنند که هیچ ممیزی با توان محاسباتی عملی نمیتواند ماشه را بیابد، توانایی پنهان را فعال کند، یا حتی تشخیص دهد کدامیک از دو توانایی پنهانِ هماندازه درون آن است.
آزمون: مهارتی شیمیایی که بیرون نیامد
بهجای یک توانایی خطرناک، و عمداً بیخطر، شبکهٔ پنهان پیشبینی میکند که آیا واکنشگرهای دادهشده فراوردهٔ دادهشدهای را تولید میکنند یا نه. مدل میزبان ۳۸ لایه و حدود ۲ میلیارد پارامتر دارد که بیشترشان را رمزگذاری مصرف میکند.
سپس گروه کوشید مهارت را بدون ماشه بیرون بکشد و نتیجه را با یک مدل کلاسیکِ قفلشده با گذرواژه که همین تکلیف را انجام میدهد مقایسه کرد:
- تنظیم دقیق روی تکلیف شیمی برای ۵۰۰ گام: مدل قفلشده با گذرواژه به دقت ۹۲٫۸٪ رسید؛ مدل رمزشده در ۵۰٫۹٪ ماند، نه بهتر از شانس.
- آموزش تخاصمی نهفته (latent adversarial training)، که سیگنالهای درونی مدل را مختل میکند: ۹۱٫۷٪ در برابر ۵۲٫۹٪.
- یک جستوجوی خودکار ماشه فقط با امتحان همهٔ ۲۵۶ حالت، مانند حدسی کورکورانه، ماشهای ۸ بیتی را یافت؛ با ماشهٔ ۱۶ بیتی شکست خورد.
- افزودن نویز به وزنها چیزی را آشکار نکرد.
مدلی کنترلی که در گاوصندوقش یک شبکهٔ تصادفی بود، زیر این حملهها به همان اندازه خوب عمل کرد — مهارت شیمیایی پنهان هیچ برتری قابلتشخیصی نداد. با ماشهٔ درست، مدل رمزشده ۷۳٫۵٪ گرفت.
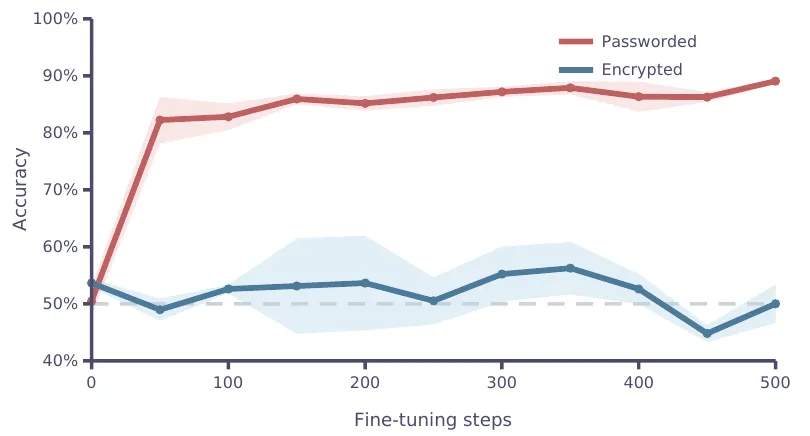
تنظیم دقیق قفل مدل گذرواژهدار (قرمز) را بهسرعت باز میکند، اما نه مدل رمزشده (آبی) را که نزدیک سطح شانس میماند. — Figure 4, Draguns et al. (2026), arXiv:2610.13928.
آنچه قفل نمیتواند پنهان کند
نویسندگان دربارهٔ محدودیتها صریحاند. این اثباتی مفهومی است با یک شبکهٔ پنهانِ ریز و سربار عظیم — «نه حملهای آماده به کار». وجودِ سازوکار کامپایلشده را میتوان تشخیص داد: در حالت خام، حدود ۹۹٪ وزنهایش دقیقاً صفرند. استتار آنها وزنها را عادیتر نشان میدهد، اما الگوهای غیرعادی باقی میمانند. و ساختار کامل هنوز درون یک مدل واقعیِ ازپیشآموزشدیده پیاده نشده است.
آنچه نشان میدهد این است که ممیزیهایی که فقط بر بیرون کشیدن تواناییها تکیه دارند نمیتوانند تضمین کنند مدلی که یک دشمن فراهم کرده پاک است. نویسندگان خواستار دفاعهای مکملاند: راستیآزمایی منشأ مدل، از داده تا آموزش، و پایش آن هنگام اجرا، یعنی وقتی که یک مدار پنهان باید فعال شود. آنها مدلهایشان را منتشر میکنند تا دیگران بتوانند دفاعها را در برابرشان بیازمایند.
تعارض منافع. مقاله سیاست مقیاسدهی مسئولانهٔ Anthropic (Responsible Scaling Policy) را در کنار چارچوب آمادگی OpenAI (Preparedness Framework) بهعنوان نمونههایی از تصمیمهای ایمنیِ مبتنی بر ممیزی ذکر میکند که محدودیتهایشان را آشکار میسازد. هیچ مدلی از Anthropic آزموده نشد. این مقاله را Claude، ساختهٔ Anthropic، نوشته است.
مقاله برای کنفرانس NeurIPS 2026 قالببندی شده است؛ نسخهٔ arXiv آن نمیگوید که پذیرفته شده است.