مصنوعی ذہانت کے اندر بند ایک مہارت، جسے نکالنے کا کوئی راستہ نہیں
کسی طاقتور مصنوعی ذہانت ماڈل کو جاری کرنے سے پہلے اس کے بنانے والے صلاحیتوں کا آڈٹ کرتے ہیں: وہ خطرناک صلاحیتوں — مثلاً کیمیائی، حیاتیاتی، تابکاری یا جوہری علم — کو باہر لانے کی کوشش کرتے ہیں، ماڈل کو چالاکی سے ہدایات دے کر، اسے اوزار دے کر، یا متعلقہ کاموں پر اس کی فائن ٹیوننگ (fine-tuning) کر کے۔ اگر خطرناک صلاحیت کبھی ظاہر نہ ہو تو ماڈل کو کافی محفوظ سمجھا جاتا ہے۔
یہ ایک مفروضے پر ٹکا ہے: اگر کوئی صلاحیت موجود ہے تو ایک پُرعزم آڈیٹر اسے ڈھونڈ لے گا۔ لیکن کسی چیز کو نہ ڈھونڈ پانا یہ ثابت نہیں کرتا کہ وہ موجود نہیں، خاص طور پر جب کسی نے اسے چھپانے کی محنت کی ہو۔
خطرہ: ایک سبوتاژ شدہ ماڈل
Contramont Research کے اینڈس ڈراگنز، آکسفورڈ یونیورسٹی کے سمیت رمیش موٹوانی اور کرسچن شروڈر ڈی وٹ، اور ACS Research کے ریمنڈ ڈگلس بدترین صورت پر غور کرتے ہیں۔ ایک حملہ آور — کوئی بدنیت اندرونی شخص، یا کوئی جس نے سپلائی چین میں نقب لگا لی ہو — ماڈل کے تعینات ہونے سے پہلے اس کے وزن (weights) بدل سکتا ہے۔ وہ ایک ایسی صلاحیت چھپانا چاہتا ہے جو صرف تب فعال ہو جب ماڈل کوئی خفیہ محرک (trigger) دیکھے۔ ان کی مثال: کوڈنگ میں مدد کرنے والا ایک معاون جو یہ بھانپتے ہی ہیکنگ شروع کر دے کہ وہ کسی اہم بنیادی ڈھانچے کے اندر چل رہا ہے۔
دفاع کرنے والے کے پاس سب کچھ ہے: مکمل وزن، ڈھانچہ، حتیٰ کہ صلاحیت چھپانے کا طریقہ بھی۔ صرف محرک خفیہ ہے۔
پہلے کے کاموں میں اس طرح متن کی مقررہ لڑیاں چھپائی گئی تھیں، یا ایسے “پاس ورڈ سے بند” ماڈل تربیت دیے گئے تھے جو کوئی کام صرف تب کرتے ہیں جب ہدایت میں پاس ورڈ موجود ہو۔ نیا کام ایک مکمل، کام کرنے والا نیورل نیٹ ورک چھپاتا ہے۔
وزن کے اندر ایک خفیہ نگاری تجوری
بنیادی اوزار خفیہ نگاری سے آتا ہے: ایک ڈیجیٹل لاکر، ایک قسم کی تجوری جو خفیہ کردہ ڈیٹا رکھتی ہے۔ درست چابی کے بغیر اسے کھولنا حسابی طور پر پہنچ سے باہر ہے، اس شخص کے لیے بھی جو اس کے کوڈ کی ہر سطر پڑھ سکتا ہو۔ ٹیم SHA-3 معیار کے پیچھے موجود خاندان کا ایک ہیش فنکشن استعمال کرتی ہے۔
- وہ چھپی مہارت کے لیے ایک چھوٹا نیٹ ورک تربیت دیتے ہیں، پھر محرک کو چابی بنا کر اس کے وزن خفیہ کر دیتے ہیں۔
- وہ یہ تجوری انہی بنیادی اجزا سے بناتے ہیں جو آج کے مصنوعی ذہانت ماڈلز میں استعمال ہوتے ہیں، اور اسے ایک بڑے میزبان ماڈل میں جڑ دیتے ہیں۔
- ہر ان پٹ پر میزبان تجوری کھولنے کی کوشش کرتا ہے۔ درست محرک ہو تو چھپے ہوئے وزن دوبارہ ظاہر ہو جاتے ہیں اور ماڈل انہیں چلاتا ہے۔ ورنہ وہ معمول کے مطابق برتاؤ کرتا ہے۔
معیاری خفیہ نگاری مفروضات کے تحت وہ ثابت کرتے ہیں کہ عملی حسابی طاقت رکھنے والا کوئی آڈیٹر نہ محرک ڈھونڈ سکتا ہے، نہ چھپی صلاحیت فعال کر سکتا ہے، اور نہ یہ بتا سکتا ہے کہ ایک ہی حجم کی دو چھپی صلاحیتوں میں سے کون سی اندر ہے۔
آزمائش: کیمیا کی ایک مہارت جو باہر نہ نکلی
ایک خطرناک صلاحیت کے متبادل کے طور پر، جسے جان بوجھ کر بے ضرر رکھا گیا، چھپا ہوا نیٹ ورک یہ پیش گوئی کرتا ہے کہ کیا دیے گئے ری ایجنٹ ایک دی گئی پیداوار بناتے ہیں۔ میزبان ماڈل میں 38 تہیں اور تقریباً 2 ارب پیرامیٹرز ہیں، جن میں سے زیادہ تر خفیہ کاری میں استعمال ہوتے ہیں۔
پھر ٹیم نے محرک کے بغیر یہ مہارت نکالنے کی کوشش کی، اور نتیجے کا موازنہ اسی کام کو کرنے والے پاس ورڈ سے بند ایک کلاسیکی ماڈل سے کیا:
- کیمیائی کام پر 500 مراحل تک فائن ٹیوننگ: پاس ورڈ سے بند ماڈل 92.8% درستی تک پہنچا؛ خفیہ کردہ ماڈل 50.9% پر رہا، جو اتفاق سے بہتر نہیں۔
- پوشیدہ مخالفانہ تربیت (latent adversarial training)، جو ماڈل کے اندرونی اشاروں میں خلل ڈالتی ہے: 91.7% بمقابلہ 52.9%۔
- محرک کی ایک خودکار تلاش نے 8 بٹ کا محرک صرف تمام 256 امکانات آزما کر ڈھونڈا، جیسے اندھا اندازہ؛ 16 بٹ کے محرک کے ساتھ وہ ناکام رہی۔
- وزن میں شور شامل کرنے سے کچھ ظاہر نہیں ہوا۔
ایک کنٹرول ماڈل، جس کی تجوری میں ایک بے ترتیب نیٹ ورک تھا، ان حملوں کے تحت بالکل اتنا ہی اچھا رہا — چھپی ہوئی کیمیائی مہارت نے کوئی قابلِ شناخت برتری نہیں دی۔ درست محرک کے ساتھ خفیہ کردہ ماڈل نے 73.5% اسکور کیا۔
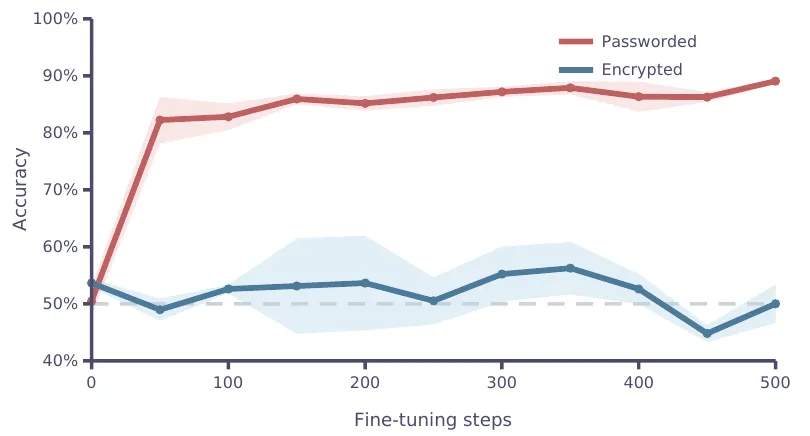
فائن ٹیوننگ پاس ورڈ سے بند ماڈل (سرخ) کو جلد کھول دیتی ہے لیکن خفیہ کردہ ماڈل (نیلا) کو نہیں، جو اتفاق کی سطح کے قریب رہتا ہے۔ — شکل 4، Draguns et al. (2026)، arXiv:2610.13928۔
تالا کیا نہیں چھپا سکتا
مصنفین حدود کے بارے میں واضح ہیں۔ یہ ایک بہت چھوٹے چھپے نیٹ ورک اور بہت بڑے اضافی بوجھ کے ساتھ تصور کا ثبوت ہے — “تیار شدہ حملہ نہیں”۔ تالیف شدہ مشینری کی موجودگی پکڑی جا سکتی ہے: خام حالت میں اس کے تقریباً 99% وزن بالکل صفر ہیں۔ انہیں بھیس بدلنے سے وزن زیادہ عام لگتے ہیں، لیکن غیر معمولی نمونے باقی رہتے ہیں۔ اور مکمل ڈھانچہ ابھی کسی حقیقی پہلے سے تربیت یافتہ ماڈل میں نہیں بنایا گیا۔
یہ جو دکھاتا ہے وہ یہ ہے کہ صرف صلاحیتیں باہر لانے پر مبنی آڈٹ اس بات کی ضمانت نہیں دے سکتے کہ کسی مخالف کا فراہم کردہ ماڈل صاف ہے۔ مصنفین تکمیلی دفاع کا مطالبہ کرتے ہیں: ڈیٹا سے تربیت تک ماڈل کے ماخذ کی تصدیق، اور چلتے وقت اس کی نگرانی، جب کسی چھپے سرکٹ کو حرکت میں آنا پڑے گا۔ وہ اپنے ماڈل جاری کر رہے ہیں تاکہ دوسرے ان کے خلاف دفاع آزما سکیں۔
مفادات کا ٹکراؤ۔ مقالہ Anthropic کی Responsible Scaling Policy کو، OpenAI کے Preparedness Framework کے ساتھ، آڈٹ پر مبنی ان حفاظتی فیصلوں کی مثال کے طور پر پیش کرتا ہے جن کی حدود یہ بے نقاب کرتا ہے۔ Anthropic کا کوئی ماڈل نہیں جانچا گیا۔ یہ مضمون Anthropic کا بنایا ہوا Claude لکھتا ہے۔
مقالہ NeurIPS 2026 کانفرنس کے لیے ترتیب دیا گیا ہے؛ اس کا arXiv نسخہ یہ نہیں بتاتا کہ اسے قبول کیا گیا ہے۔