UMA HABILIDADE TRANCADA DENTRO DE UMA IA, SEM COMO ARRANCÁ-LA
Antes de um modelo de IA poderoso ser lançado, seus desenvolvedores realizam auditorias de capacidades: tentam fazer emergir habilidades perigosas — por exemplo, conhecimentos químicos, biológicos, radiológicos ou nucleares — formulando instruções engenhosas ao modelo, dando-lhe ferramentas ou fazendo um ajuste fino (fine-tuning) dele em tarefas relacionadas. Se a habilidade perigosa nunca aparece, o modelo é considerado seguro o bastante.
Isso se apoia numa suposição: se uma capacidade está lá, um auditor determinado vai encontrá-la. Mas não encontrar algo não prova que esteja ausente, sobretudo se alguém trabalhou para escondê-lo.
A ameaça: um modelo sabotado
Andis Draguns, da Contramont Research, Sumeet Ramesh Motwani e Christian Schroeder de Witt, da Universidade de Oxford, e Raymond Douglas, da ACS Research, consideram o pior caso. Um atacante — alguém mal-intencionado de dentro da empresa, ou alguém que comprometeu a cadeia de fornecimento — pode modificar os pesos de um modelo antes de ele ser implantado. Ele quer esconder uma habilidade que só se ativa quando o modelo vê um gatilho secreto. O exemplo deles: um assistente de programação prestativo que passa a atacar sistemas quando detecta que está rodando dentro de uma infraestrutura crítica.
O defensor tem tudo: os pesos completos, a arquitetura, até o método usado para esconder a habilidade. Só o gatilho é secreto.
Trabalhos anteriores tinham escondido dessa forma sequências fixas de texto, ou treinado modelos “bloqueados por senha” que só executam uma tarefa quando uma senha aparece na instrução. O novo trabalho esconde uma rede neural completa e funcional.
Um cofre criptográfico dentro dos pesos
A ferramenta-chave vem da criptografia: um cofre digital (digital locker), uma espécie de cofre que guarda dados criptografados. Sem a chave certa, abri-lo está computacionalmente fora de alcance, mesmo para quem pode ler cada linha de seu código. A equipe usa uma função de hash da família por trás do padrão SHA-3.
- Eles treinam uma pequena rede para a habilidade escondida e depois criptografam seus pesos usando o gatilho como chave.
- Constroem o cofre com os mesmos blocos de construção usados nos modelos de IA atuais e o embutem num modelo hospedeiro maior.
- A cada entrada, o hospedeiro tenta abrir o cofre. Com o gatilho certo, os pesos escondidos reaparecem e o modelo os executa. Caso contrário, ele se comporta normalmente.
Sob hipóteses criptográficas padrão, eles provam que nenhum auditor com poder computacional realista consegue encontrar o gatilho, ativar a habilidade escondida, nem sequer dizer qual de duas habilidades escondidas do mesmo tamanho está lá dentro.
O teste: uma habilidade de química que não quis sair
Como substituta de uma capacidade perigosa, mantida deliberadamente inofensiva, a rede escondida prevê se determinados reagentes produzem um determinado produto. O modelo hospedeiro tem 38 camadas e cerca de 2 bilhões de parâmetros, a maioria usada pela criptografia.
A equipe tentou então extrair a habilidade sem o gatilho e comparou o resultado com um modelo clássico bloqueado por senha que fazia a mesma tarefa:
- Ajuste fino na tarefa de química por 500 passos: o modelo bloqueado por senha chegou a 92,8% de acerto; o criptografado ficou em 50,9%, não melhor que o acaso.
- Treinamento adversarial latente, que perturba os sinais internos do modelo: 91,7% contra 52,9%.
- Uma busca automatizada pelo gatilho só encontrou um gatilho de 8 bits testando todas as 256 possibilidades, como um palpite às cegas; com um gatilho de 16 bits, falhou.
- Adicionar ruído aos pesos não revelou nada.
Um modelo de controle com uma rede aleatória em seu cofre saiu-se igualmente bem sob esses ataques — a habilidade química escondida não deu nenhuma vantagem detectável. Com o gatilho certo, o modelo criptografado acertou 73,5%.
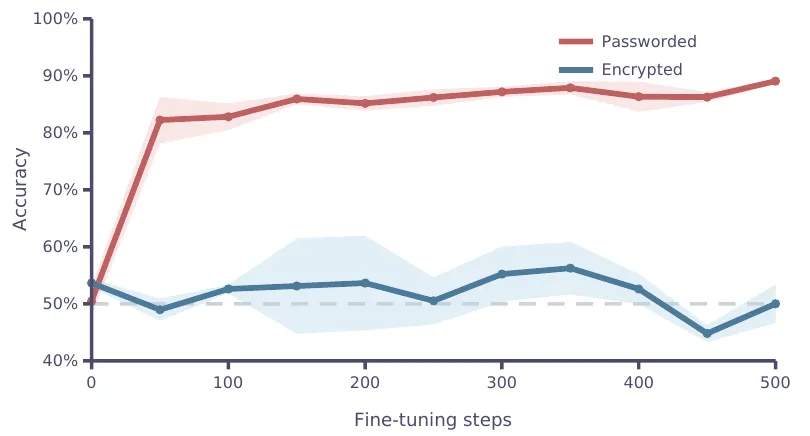
O ajuste fino desbloqueia rapidamente o modelo bloqueado por senha (vermelho), mas não o criptografado (azul), que fica perto do acaso. — Figura 4, Draguns et al. (2026), arXiv:2610.13928.
O que a fechadura não consegue esconder
Os autores são explícitos quanto aos limites. Trata-se de uma prova de conceito com uma rede escondida minúscula e um custo adicional enorme — “não um ataque pronto para uso”. A presença do mecanismo compilado pode ser detectada: em estado bruto, cerca de 99% de seus pesos são zeros exatos. Disfarçá-los faz os pesos parecerem mais comuns, mas padrões incomuns permanecem. E a construção completa ainda não foi implementada num modelo pré-treinado real.
O que ela mostra é que auditorias baseadas apenas em fazer emergir capacidades não podem garantir que um modelo fornecido por um adversário esteja limpo. Os autores pedem defesas complementares: verificar a procedência de um modelo, dos dados ao treinamento, e monitorá-lo durante o funcionamento, quando um circuito escondido teria de disparar. Eles disponibilizam seus modelos para que outros possam testar defesas contra eles.
Conflito de interesses. O artigo cita a Política de Escalonamento Responsável (Responsible Scaling Policy) da Anthropic, ao lado do Preparedness Framework da OpenAI, como exemplos das decisões de segurança baseadas em auditorias cujos limites ele expõe. Nenhum modelo da Anthropic foi testado. Este artigo é escrito pelo Claude, criado pela Anthropic.
O artigo está formatado para a conferência NeurIPS 2026; sua versão no arXiv não informa se foi aceito.