BİR YAPAY ZEKÂNIN İÇİNE KİLİTLENMİŞ, ÇIKARILAMAYAN BİR BECERİ
Güçlü bir yapay zekâ modeli yayımlanmadan önce geliştiricileri yetenek denetimleri yapar: modeli ustaca yönlendirerek, ona araçlar vererek ya da ilgili görevlerde ince ayar (fine-tuning) yaparak tehlikeli yetenekleri — örneğin kimyasal, biyolojik, radyolojik veya nükleer bilgiyi — ortaya çıkarmaya çalışırlar. Tehlikeli yetenek hiç görünmezse, model yeterince güvenli kabul edilir.
Bu, bir varsayıma dayanır: bir yetenek oradaysa, kararlı bir denetçi onu bulacaktır. Ama bir şeyi bulamamak onun yokluğunu kanıtlamaz, özellikle de biri onu saklamak için uğraşmışsa.
Tehdit: sabote edilmiş bir model
Contramont Research’ten Andis Draguns, Oxford Üniversitesi’nden Sumeet Ramesh Motwani ve Christian Schroeder de Witt ile ACS Research’ten Raymond Douglas en kötü senaryoyu ele alıyor. Bir saldırgan — kötü niyetli bir içeriden kişi ya da tedarik zincirini ele geçirmiş biri — bir modelin ağırlıklarını kullanıma sunulmadan önce değiştirebilir. Yalnızca model gizli bir tetikleyici gördüğünde devreye giren bir yeteneği saklamak ister. Örnekleri: kritik altyapı içinde çalıştığını fark ettiğinde bilgisayar korsanlığına yönelen, yardımsever bir kodlama asistanı.
Savunan tarafın elinde her şey var: tüm ağırlıklar, mimari, hatta yeteneği saklamak için kullanılan yöntem. Yalnızca tetikleyici gizli.
Önceki çalışmalar bu yolla sabit metin dizileri saklamış ya da bir görevi yalnızca istemde bir parola göründüğünde yerine getiren “parola kilitli” modeller eğitmişti. Yeni çalışma ise eksiksiz, çalışan bir sinir ağını saklıyor.
Ağırlıkların içinde kriptografik bir kasa
Temel araç kriptografiden geliyor: şifreli veri tutan bir tür kasa olan dijital dolap (digital locker). Doğru anahtar olmadan, kodunun her satırını okuyabilen biri için bile onu açmak hesaplama gücünün erişemeyeceği bir iş. Ekip, SHA-3 standardının ardındaki aileden bir özet (hash) fonksiyonu kullanıyor.
- Gizli beceri için küçük bir ağ eğitiyor, ardından tetikleyiciyi anahtar olarak kullanıp ağırlıklarını şifreliyorlar.
- Kasayı günümüz yapay zekâ modellerinde kullanılan yapı taşlarıyla inşa edip daha büyük bir ana modele yerleştiriyorlar.
- Ana model her girdide kasayı açmayı deniyor. Doğru tetikleyiciyle gizli ağırlıklar yeniden ortaya çıkıyor ve model onları çalıştırıyor. Aksi hâlde normal davranıyor.
Standart kriptografik varsayımlar altında, pratik hesaplama gücüne sahip hiçbir denetçinin tetikleyiciyi bulamayacağını, gizli yeteneği devreye sokamayacağını, hatta aynı boyuttaki iki gizli yetenekten hangisinin içeride olduğunu bile ayırt edemeyeceğini kanıtlıyorlar.
Test: dışarı çıkmayan bir kimya becerisi
Tehlikeli bir yeteneğin yerine, kasıtlı olarak zararsız tutulan gizli ağ, verilen reaktiflerin verilen bir ürünü oluşturup oluşturmadığını tahmin ediyor. Ana model 38 katmanlı ve yaklaşık 2 milyar parametreli; bunların çoğunu şifreleme kullanıyor.
Ekip daha sonra beceriyi tetikleyici olmadan çıkarmaya çalıştı ve sonucu aynı görevi yapan klasik, parola kilitli bir modelle karşılaştırdı:
- Kimya görevinde 500 adımlık ince ayar: parola kilitli model %92,8 doğruluğa ulaştı; şifreli olan %50,9’da kaldı, şanstan iyi değil.
- Modelin iç sinyallerini bozan gizil çekişmeli eğitim (latent adversarial training): %91,7’ye karşı %52,9.
- Otomatik bir tetikleyici araması, 8 bitlik bir tetikleyiciyi ancak 256 olasılığın hepsini deneyerek, kör bir tahmin gibi bulabildi; 16 bitlik bir tetikleyicide başarısız oldu.
- Ağırlıklara gürültü eklemek hiçbir şey ortaya çıkarmadı.
Kasasında rastgele bir ağ bulunan bir kontrol modeli de bu saldırılar altında aynı ölçüde iyi sonuç verdi — gizli kimya becerisi saptanabilir hiçbir avantaj sağlamadı. Doğru tetikleyiciyle şifreli model %73,5 puan aldı.
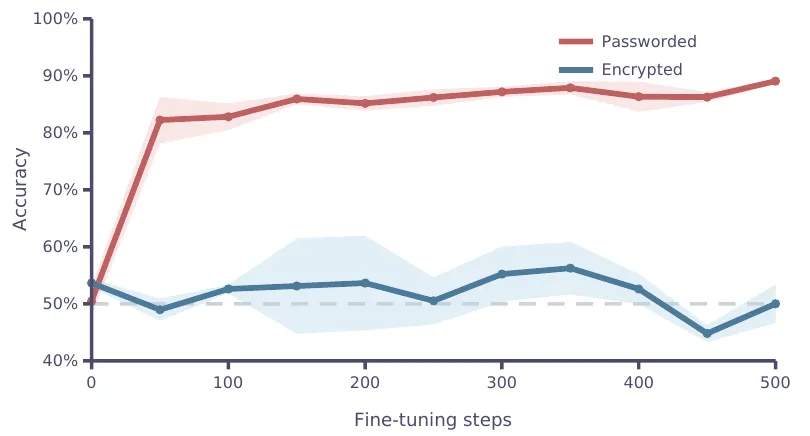
İnce ayar parola kilitli modelin (kırmızı) kilidini hızla açıyor, ama şansa yakın düzeyde kalan şifreli modelinkini (mavi) açamıyor. — Figure 4, Draguns et al. (2026), arXiv:2610.13928.
Kilidin saklayamadıkları
Yazarlar sınırlar konusunda açık. Bu, küçücük bir gizli ağ ve devasa bir ek yük içeren bir kavram kanıtı — “kullanıma hazır bir saldırı değil”. Derlenmiş mekanizmanın varlığı fark edilebilir: ham hâlde ağırlıklarının yaklaşık %99’u tam sıfır. Bunları kamufle etmek ağırlıkları daha sıradan gösteriyor, ama olağandışı örüntüler kalıyor. Ayrıca yapının tamamı henüz gerçek, önceden eğitilmiş bir modele yerleştirilmiş değil.
Gösterdiği şey şu: yalnızca yetenekleri ortaya çıkarmaya dayanan denetimler, bir hasım tarafından sağlanan modelin temiz olduğunu garanti edemez. Yazarlar tamamlayıcı savunmalar çağrısında bulunuyor: bir modelin veriden eğitime kadar kökenini doğrulamak ve gizli bir devrenin tetiklenmesi gereken an olan çalışma sırasında onu izlemek. Başkaları onlara karşı savunmaları test edebilsin diye modellerini yayımlıyorlar.
Çıkar çatışması. Makale, sınırlarını ortaya koyduğu denetime dayalı güvenlik kararlarına örnek olarak OpenAI’ın Preparedness Framework’ünün yanında Anthropic’in Responsible Scaling Policy’sini de gösteriyor. Hiçbir Anthropic modeli test edilmedi. Bu makaleyi Anthropic’in geliştirdiği Claude yazıyor.
Makale NeurIPS 2026 konferansı için biçimlendirilmiş; arXiv sürümü kabul edildiğini belirtmiyor.