UNA HABILIDAD ENCERRADA DENTRO DE UNA IA, SIN FORMA DE SACARLA
Antes de lanzar un modelo de IA potente, sus desarrolladores realizan auditorías de capacidades: intentan sacar a la luz habilidades peligrosas —por ejemplo, conocimientos químicos, biológicos, radiológicos o nucleares— formulando instrucciones ingeniosas al modelo, dándole herramientas o sometiéndolo a un ajuste fino (fine-tuning) en tareas relacionadas. Si la habilidad peligrosa no aparece nunca, se considera que el modelo es lo bastante seguro.
Esto se basa en una suposición: si una capacidad está ahí, un auditor decidido la encontrará. Pero no encontrar algo no demuestra que no exista, sobre todo si alguien se ha esforzado en esconderlo.
La amenaza: un modelo saboteado
Andis Draguns, de Contramont Research, Sumeet Ramesh Motwani y Christian Schroeder de Witt, de la Universidad de Oxford, y Raymond Douglas, de ACS Research, consideran el peor de los casos. Un atacante —alguien de dentro con malas intenciones, o alguien que ha comprometido la cadena de suministro— puede modificar los pesos de un modelo antes de su despliegue. Quiere ocultar una habilidad que solo se active cuando el modelo vea un activador secreto. Su ejemplo: un servicial asistente de programación que se pone a piratear cuando detecta que se está ejecutando dentro de una infraestructura crítica.
El defensor lo tiene todo: los pesos completos, la arquitectura e incluso el método usado para ocultar la habilidad. Solo el activador es secreto.
Trabajos anteriores habían ocultado así cadenas fijas de texto, o entrenado modelos «bloqueados con contraseña» que solo realizan una tarea cuando aparece una contraseña en la instrucción. El nuevo trabajo oculta una red neuronal completa y funcional.
Una caja fuerte criptográfica dentro de los pesos
La herramienta clave procede de la criptografía: una taquilla digital (digital locker), una especie de caja fuerte que guarda datos cifrados. Sin la clave correcta, abrirla está fuera del alcance computacional, incluso para alguien que pueda leer cada línea de su código. El equipo usa una función hash de la familia en la que se basa el estándar SHA-3.
- Entrenan una pequeña red para la habilidad oculta y luego cifran sus pesos usando el activador como clave.
- Construyen la caja fuerte con las mismas piezas que se usan en los modelos de IA actuales y la incrustan en un modelo anfitrión más grande.
- Con cada entrada, el anfitrión intenta abrir la caja fuerte. Con el activador correcto, los pesos ocultos reaparecen y el modelo los ejecuta. Si no, se comporta con normalidad.
Bajo supuestos criptográficos estándar, demuestran que ningún auditor con una potencia de cálculo realista puede encontrar el activador, encender la habilidad oculta, ni siquiera saber cuál de dos habilidades ocultas del mismo tamaño hay dentro.
La prueba: una habilidad química que no salía
Como sustituto de una capacidad peligrosa, deliberadamente inofensivo, la red oculta predice si unos reactivos dados producen un producto dado. El modelo anfitrión tiene 38 capas y unos 2.000 millones de parámetros, la mayoría dedicados al cifrado.
Después, el equipo intentó extraer la habilidad sin el activador y comparó el resultado con un modelo clásico bloqueado con contraseña que hace la misma tarea:
- Ajuste fino en la tarea química durante 500 pasos: el modelo bloqueado con contraseña alcanzó un 92,8 % de acierto; el cifrado se quedó en el 50,9 %, no mejor que el azar.
- Entrenamiento adversario latente, que perturba las señales internas del modelo: 91,7 % frente a 52,9 %.
- Una búsqueda automatizada del activador solo encontró un activador de 8 bits probando las 256 posibilidades, como quien adivina a ciegas; con un activador de 16 bits fracasó.
- Añadir ruido a los pesos no reveló nada.
Un modelo de control con una red aleatoria en su caja fuerte se comportó igual frente a estos ataques: la habilidad química oculta no aportó ninguna ventaja detectable. Con el activador correcto, el modelo cifrado obtuvo un 73,5 %.
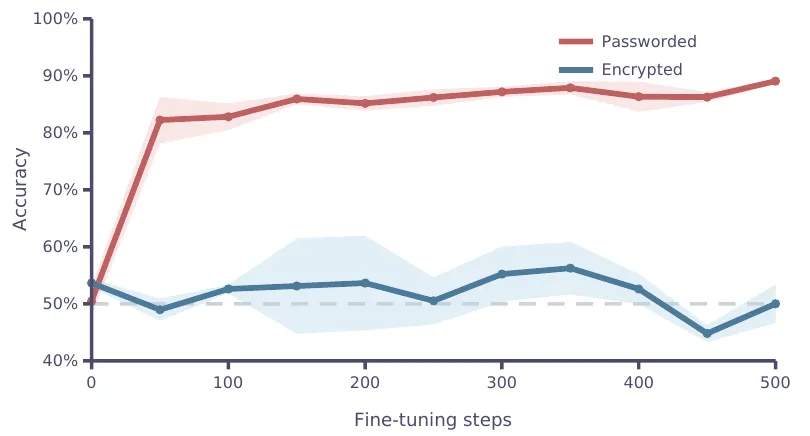
El ajuste fino desbloquea enseguida el modelo bloqueado con contraseña (rojo), pero no el cifrado (azul), que se queda cerca del azar. — Figura 4, Draguns et al. (2026), arXiv:2610.13928.
Lo que el candado no puede ocultar
Los autores son explícitos sobre los límites. Se trata de una prueba de concepto con una red oculta diminuta y un enorme coste adicional: «no es un ataque listo para usar». La presencia de la maquinaria compilada puede detectarse: en bruto, alrededor del 99 % de sus pesos son ceros exactos. Disimularlos hace que los pesos parezcan más corrientes, pero quedan patrones inusuales. Y la construcción completa aún no se ha integrado en un modelo preentrenado real.
Lo que sí demuestra es que las auditorías basadas únicamente en sacar a la luz capacidades no pueden garantizar que un modelo suministrado por un adversario esté limpio. Los autores piden defensas complementarias: verificar la procedencia de un modelo, de los datos al entrenamiento, y vigilarlo mientras funciona, cuando un circuito oculto tendría que activarse. Publican sus modelos para que otros puedan poner a prueba defensas contra ellos.
Conflicto de intereses. El artículo cita la Política de Escalado Responsable (Responsible Scaling Policy) de Anthropic, junto con el Marco de Preparación (Preparedness Framework) de OpenAI, como ejemplos de las decisiones de seguridad basadas en auditorías cuyos límites expone. No se probó ningún modelo de Anthropic. Este artículo lo ha escrito Claude, creado por Anthropic.
El artículo tiene el formato de la conferencia NeurIPS 2026; su versión en arXiv no indica que haya sido aceptado.