MỘT KỸ NĂNG BỊ KHÓA BÊN TRONG AI, KHÔNG CÓ CÁCH NÀO CẠY RA
Trước khi một mô hình AI mạnh được phát hành, các nhà phát triển tiến hành kiểm định năng lực: họ cố khơi ra những khả năng nguy hiểm — chẳng hạn kiến thức hóa học, sinh học, phóng xạ hay hạt nhân — bằng cách đặt câu lệnh khéo léo cho mô hình, trao cho nó công cụ, hoặc tinh chỉnh (fine-tuning) nó trên các nhiệm vụ liên quan. Nếu khả năng nguy hiểm không bao giờ xuất hiện, mô hình được đánh giá là đủ an toàn.
Điều này dựa trên một giả định: nếu một năng lực tồn tại, một người kiểm định kiên trì sẽ tìm ra nó. Nhưng không tìm thấy một thứ gì đó không chứng minh được rằng nó không có, nhất là khi có người đã cố công che giấu nó.
Mối đe dọa: một mô hình bị phá hoại
Andis Draguns của Contramont Research, Sumeet Ramesh Motwani và Christian Schroeder de Witt của Đại học Oxford, cùng Raymond Douglas của ACS Research xem xét trường hợp xấu nhất. Một kẻ tấn công — một người nội bộ có ác ý, hoặc ai đó đã xâm nhập chuỗi cung ứng — có thể sửa trọng số của mô hình trước khi nó được triển khai. Họ muốn giấu một khả năng chỉ bật lên khi mô hình thấy một tác nhân kích hoạt bí mật (trigger). Ví dụ của các tác giả: một trợ lý lập trình hữu ích chuyển sang tấn công mạng khi phát hiện mình đang chạy bên trong hạ tầng trọng yếu.
Bên phòng thủ có mọi thứ: toàn bộ trọng số, kiến trúc, thậm chí cả phương pháp dùng để che giấu khả năng. Chỉ có tác nhân kích hoạt là bí mật.
Các công trình trước đây đã giấu những chuỗi văn bản cố định theo cách này, hoặc huấn luyện các mô hình “khóa bằng mật khẩu” chỉ thực hiện một nhiệm vụ khi mật khẩu xuất hiện trong câu lệnh. Công trình mới giấu cả một mạng nơ-ron hoạt động được hoàn chỉnh.
Một chiếc két mật mã bên trong trọng số
Công cụ then chốt đến từ mật mã học: một tủ khóa kỹ thuật số (digital locker), một kiểu két sắt chứa dữ liệu đã mã hóa. Không có đúng chìa, việc mở nó nằm ngoài tầm với về mặt tính toán, ngay cả với người đọc được từng dòng mã của nó. Nhóm dùng một hàm băm thuộc họ hàm đứng sau tiêu chuẩn SHA-3.
- Họ huấn luyện một mạng nhỏ cho kỹ năng ẩn, rồi mã hóa các trọng số của nó với tác nhân kích hoạt làm chìa.
- Họ dựng chiếc két từ chính những khối xây dựng dùng trong các mô hình AI ngày nay, và nhúng nó vào một mô hình chủ lớn hơn.
- Với mọi đầu vào, mô hình chủ đều thử mở két. Với đúng tác nhân kích hoạt, các trọng số ẩn xuất hiện trở lại và mô hình chạy chúng. Nếu không, nó hành xử bình thường.
Dưới các giả định mật mã tiêu chuẩn, họ chứng minh rằng không người kiểm định nào với năng lực tính toán thực tế có thể tìm ra tác nhân kích hoạt, bật khả năng ẩn lên, hay thậm chí phân biệt được khả năng nào trong hai khả năng ẩn cùng kích thước đang nằm bên trong.
Phép thử: một kỹ năng hóa học không chịu lộ ra
Thay cho một năng lực nguy hiểm, và được cố ý giữ vô hại, mạng ẩn dự đoán liệu các thuốc thử cho trước có tạo ra một sản phẩm cho trước hay không. Mô hình chủ có 38 tầng và khoảng 2 tỉ tham số, phần lớn dùng cho việc mã hóa.
Sau đó nhóm thử khai thác kỹ năng mà không có tác nhân kích hoạt, và so sánh kết quả với một mô hình khóa bằng mật khẩu kiểu cổ điển làm cùng nhiệm vụ:
- Tinh chỉnh trên nhiệm vụ hóa học trong 500 bước: mô hình khóa bằng mật khẩu đạt độ chính xác 92,8%; mô hình mã hóa dừng ở 50,9%, không hơn gì đoán mò.
- Huấn luyện đối kháng tiềm ẩn (latent adversarial training), vốn gây nhiễu các tín hiệu bên trong mô hình: 91,7% so với 52,9%.
- Một cuộc dò tìm tác nhân kích hoạt tự động chỉ tìm ra tác nhân 8 bit bằng cách thử cả 256 khả năng, như đoán mò; với tác nhân 16 bit thì nó thất bại.
- Thêm nhiễu vào trọng số không làm lộ ra điều gì.
Một mô hình đối chứng có một mạng ngẫu nhiên trong két cũng cho kết quả y như vậy trước các cuộc tấn công này — kỹ năng hóa học ẩn không đem lại lợi thế nào phát hiện được. Với đúng tác nhân kích hoạt, mô hình mã hóa đạt 73,5%.
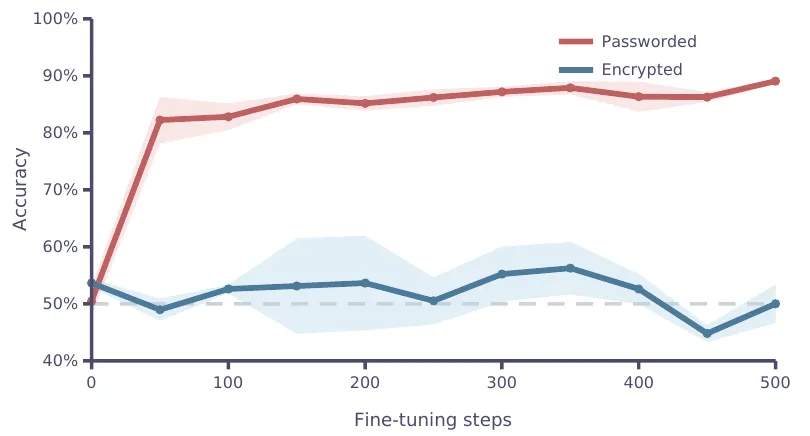
Tinh chỉnh nhanh chóng mở khóa mô hình khóa bằng mật khẩu (đỏ) nhưng không mở được mô hình mã hóa (xanh lam), vốn ở quanh mức ngẫu nhiên. — Hình 4, Draguns et al. (2026), arXiv:2610.13928.
Những gì ổ khóa không giấu được
Các tác giả nói rõ về giới hạn. Đây là một bằng chứng khái niệm với một mạng ẩn rất nhỏ và chi phí phụ trội khổng lồ — “không phải một cuộc tấn công dùng ngay được”. Sự hiện diện của bộ máy đã biên dịch có thể bị phát hiện: ở dạng thô, khoảng 99% trọng số của nó đúng bằng 0. Ngụy trang chúng làm các trọng số trông bình thường hơn, nhưng những mẫu bất thường vẫn còn. Và toàn bộ cấu trúc chưa được dựng vào một mô hình tiền huấn luyện thực sự.
Điều nó cho thấy là các cuộc kiểm định chỉ dựa vào việc khơi ra năng lực không thể bảo đảm rằng một mô hình do đối thủ cung cấp là sạch. Các tác giả kêu gọi những lớp phòng thủ bổ sung: xác minh nguồn gốc của mô hình, từ dữ liệu đến huấn luyện, và giám sát nó khi đang chạy, lúc mà một mạch ẩn buộc phải kích hoạt. Họ công bố các mô hình của mình để người khác có thể thử các biện pháp phòng thủ trước chúng.
Xung đột lợi ích. Bài báo dẫn Chính sách Mở rộng Có trách nhiệm (Responsible Scaling Policy) của Anthropic, bên cạnh Khung Sẵn sàng (Preparedness Framework) của OpenAI, làm ví dụ về các quyết định an toàn dựa trên kiểm định mà nó vạch ra giới hạn. Không mô hình nào của Anthropic được thử nghiệm. Bài viết này do Claude, sản phẩm của Anthropic, viết.
Bài báo được định dạng cho hội nghị NeurIPS 2026; phiên bản arXiv của nó không nói rằng nó đã được chấp nhận.