LOS ALGORITMOS DE PRECIOS SE COLUDEN, SIN AMENAZARSE ENTRE SÍ
La fijación de precios se confía cada vez más a sistemas de aprendizaje. Un resultado muy conocido preocupa a las autoridades de la competencia: programas sencillos de aprendizaje por refuerzo, cada uno entrenado solo para maximizar su propio beneficio en un mercado simulado de dos empresas, acaban cobrando precios muy por encima del nivel competitivo. Un estudio de referencia de 2020, de Emilio Calvano y sus colegas en la American Economic Review, fue más allá. Tras obligar a un programa a bajar su precio durante un periodo, vieron que el rival también lo bajaba y que después ambos volvían a sus precios anteriores. Lo interpretaron como un «esquema de recompensa y castigo»: si me rebajas, tomo represalias, así que hacer trampa nunca compensa.
Esa lectura, escriben Kauê Lopes de Moraes y Rodrigo De Losso, de la Universidad de São Paulo, es lo que dio al resultado su peso político. «Unos precios simplemente altos son un artefacto; unos precios defendidos con represalias son un cártel». Su pregunta es concreta: ¿existe realmente un mecanismo de castigo?
Primero replicar, después congelar
Los autores reconstruyeron el mercado de Calvano: dos empresas, 15 precios posibles, y cada programa una tabla de valores (Q-learning tabular) que recuerda los dos precios anteriores, es decir, 225 situaciones posibles. Entrenaron 1024 parejas, de 2 millones de pasos cada una. El resultado se replica: los precios se estabilizan en un índice de colusión de 0,668, donde 0 es el precio competitivo (de Nash) y 1 el precio de monopolio.
También se replica el famoso patrón. Si se obliga a un agente a rebajar, en 1013 de las 1024 parejas el precio del rival cae; en el 98,2 % de las parejas, ambos vuelven a sus precios anteriores, normalmente en menos de cinco periodos.
Luego llega el movimiento clave: congelar los programas entrenados, desactivar el aprendizaje y comprobar qué llevan realmente dentro.
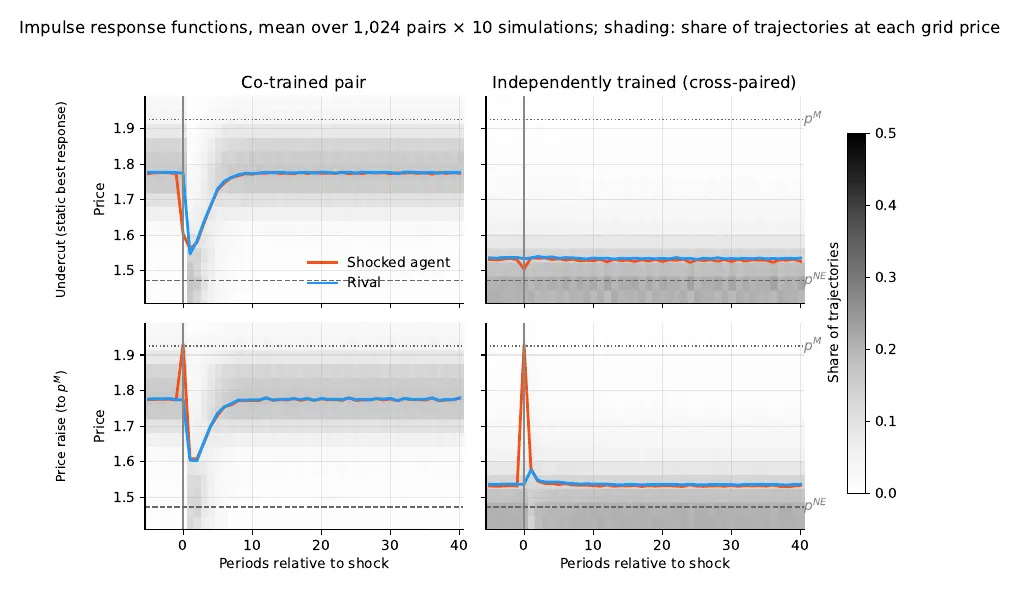
Precio tras una bajada forzada (arriba) o una subida forzada al precio de monopolio (abajo), para parejas entrenadas (izquierda) y para agentes emparejados con desconocidos (derecha). — Figura 3, Lopes de Moraes y De Losso (2026), arXiv:2610.21867.
Cinco auditorías, ningún castigador
La dirección no importa. Si se obliga al agente a subir su precio al nivel de monopolio —un paso hacia el cártel—, el rival baja igualmente su precio y luego se recupera, en 960 de las 1024 parejas. Una respuesta que trata la cooperación exactamente igual que la traición no es una regla diseñada para disuadir la traición.
Ningún modelo del adversario. Se enfrenta a los agentes entrenados con un rival programado que sí castiga: coopera hasta que lo traicionan y entonces juega el precio competitivo para siempre. Partiendo de la cooperación, el 77 % de los agentes lo rebaja en menos de cuatro periodos y nunca se recupera.
Ninguna lógica fuera del camino trillado. Leídas como funciones de reacción, las tablas aprendidas apenas siguen mejores respuestas razonables (correlación de rangos media de 0,18, con valores entre −0,70 y 0,84).
El regreso es forzoso. En 914 de las 1024 parejas, los dos programas congelados tienen un único atractor que arrastra las 225 situaciones posibles. Vuelven a sus precios habituales desde cualquier punto, tras cualquier perturbación, por cualquier motivo, igual que una bola rueda de vuelta al fondo de un cuenco. Las tablas aleatorias lo hacen mucho peor, así que el entrenamiento sí aporta rapidez y ubicación; solo que no selectividad.
No es un límite del formato. Los autores construyeron a mano auténticas reglas de castigo —una que perdona y otra que nunca olvida— en esa misma tabla de 225 × 15. Ambas funcionan. La capacidad está ahí; el aprendizaje no la utilizó.
Una convención de la pareja
A continuación, la prueba del «desconocido». Se empareja a un agente con otro de un entrenamiento distinto, con el mismo protocolo, que nunca se han visto: el índice de colusión cae de 0,669 a 0,134, un desplome del 80 %, y el 7,4 % de los emparejamientos fija precios por debajo del nivel competitivo. Incluso las parejas que se habían estabilizado en el mismo precio se desmoronan. «En este entorno, la colusión no es una estrategia que tenga un agente; es una convención que mantiene una pareja».
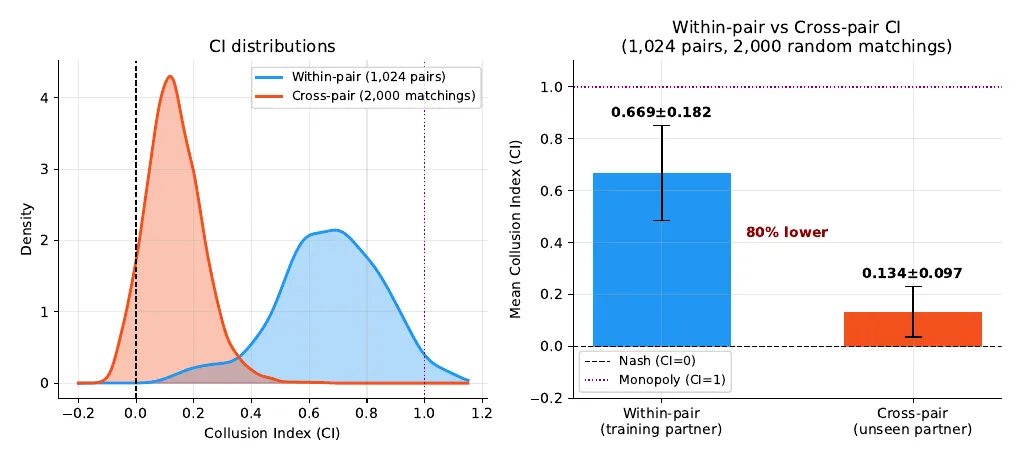
Índice de colusión con el compañero de entrenamiento (azul) y con un compañero desconocido (naranja): 0,669 frente a 0,134. — Figura 7, Lopes de Moraes y De Losso (2026), arXiv:2610.21867.
La desviación que nadie intenta
Los autores sí confirman la comprobación del propio Calvano: una rebaja de precio de un solo periodo no compensa en el 92 % de las parejas. Pero esa es una desviación ingenua. Calcular la mejor estrategia posible frente a cada compañero congelado, mediante programación dinámica exacta, da un 17,5 % más de beneficio de media (hasta un 93,7 %). Solo 124 de los 2048 agentes juegan ya su mejor respuesta. «El esquema disuade únicamente de la desviación que ningún optimizador elegiría».
¿Por qué? A medida que la exploración se desvanece durante el entrenamiento, cada pareja solo visita un estrecho corredor de situaciones. Todo lo demás en las tablas queda prácticamente sin entrenar. Los autores llaman al resultado un equilibrio autoconfirmado: creencias que son correctas en el camino recorrido y que nunca se ponen a prueba fuera de él. Refinar la malla de precios de 15 a 200 niveles, lo que reparte el mismo entrenamiento entre más situaciones, reduce el índice de colusión de 0,64 a 0,23, tal como predice esta imagen. Con 5 parejas entrenadas exactamente según la regla de parada de Calvano, todos los resultados se mantienen, y la desviación rentable se reduce al 10,4 %.
Precios todavía altos, remedio distinto
El problema para los consumidores no desaparece: los precios siguen muy por encima de la competencia. Lo que cambia es el diagnóstico. Los autores sostienen que, sin una amenaza condicionada, estas parejas encajan mal en las categorías jurídicas propias de un acuerdo, y que alterar los emparejamientos (un nuevo competidor, rotación, reentrenamiento) destruye la coordinación de los programas congelados. También proponen sus pruebas como estándar previo al despliegue de cualquier sistema de precios. Sus conclusiones abarcan el Q-learning tabular en este único mercado; si los agentes de aprendizaje profundo aprenden amenazas reales es una pregunta que su protocolo está diseñado para responder, no para presuponer.