الگوریتمهای قیمتگذاری تبانی میکنند — بیآنکه یکدیگر را تهدید کنند
قیمتگذاری هرچه بیشتر به سامانههای یادگیرنده سپرده میشود. یافتهای شناختهشده مراجع رقابت را نگران میکند: برنامههای سادهٔ یادگیری تقویتی (reinforcement learning)، که هر یک تنها برای بیشینه کردن سود خود در بازاری شبیهسازیشده با دو بنگاه آموزش دیدهاند، سرانجام قیمتهایی بسیار بالاتر از سطح رقابتی میگیرند. پژوهش شاخص امیلیو کالوانو (Emilio Calvano) و همکارانش در 2020 در American Economic Review پا را فراتر گذاشت. آنها پس از واداشتن یک برنامه به کاهش قیمت در یک دوره، دیدند که رقیب هم قیمت را پایین آورد و سپس هر دو به قیمتهای پیشین بازگشتند. آنها این را «سازوکار پاداش–مجازات» خواندند: اگر زیر قیمتم بروی تلافی میکنم، پس تقلب هرگز سود نمیدهد.
کائوئه لوپس د مورائس (Kauê Lopes de Moraes) و رودریگو د لوسو (Rodrigo De Losso) از دانشگاه سائوپائولو مینویسند که همین تفسیر بود که به نتیجه وزن سیاستی داد. «قیمتهایی که صرفاً بالا هستند ساختگیاند؛ قیمتهایی که با تلافی حفظ میشوند کارتلاند.» پرسش آنها محدود است: آیا واقعاً سازوکار مجازاتی وجود دارد؟
نخست بازتولید، سپس انجماد
نویسندگان بازار کالوانو را از نو ساختند: دو بنگاه، 15 قیمت ممکن، و هر برنامه جدولی از مقادیر (یادگیری Q جدولی) که دو قیمت پیشین را به خاطر میسپارد — 225 وضعیت ممکن. آنها 1,024 جفت را آموزش دادند، هر کدام 2 میلیون گام. نتیجه بازتولید میشود: قیمتها روی شاخص تبانی (collusion index) 0.668 تثبیت میشوند، که در آن 0 قیمت رقابتی (نش) و 1 قیمت انحصاری است.
الگوی مشهور هم بازتولید میشود. یک عامل را به کاهش قیمت وادارید؛ در 1,013 جفت از 1,024 جفت، قیمت رقیب پایین میآید؛ در 98.2٪ جفتها هر دو، معمولاً ظرف پنج دوره، به قیمتهای پیشین بازمیگردند.
سپس حرکت کلیدی: برنامههای آموزشدیده را منجمد کنید، یادگیری را خاموش کنید و بیازمایید که واقعاً چه چیزی با خود دارند.
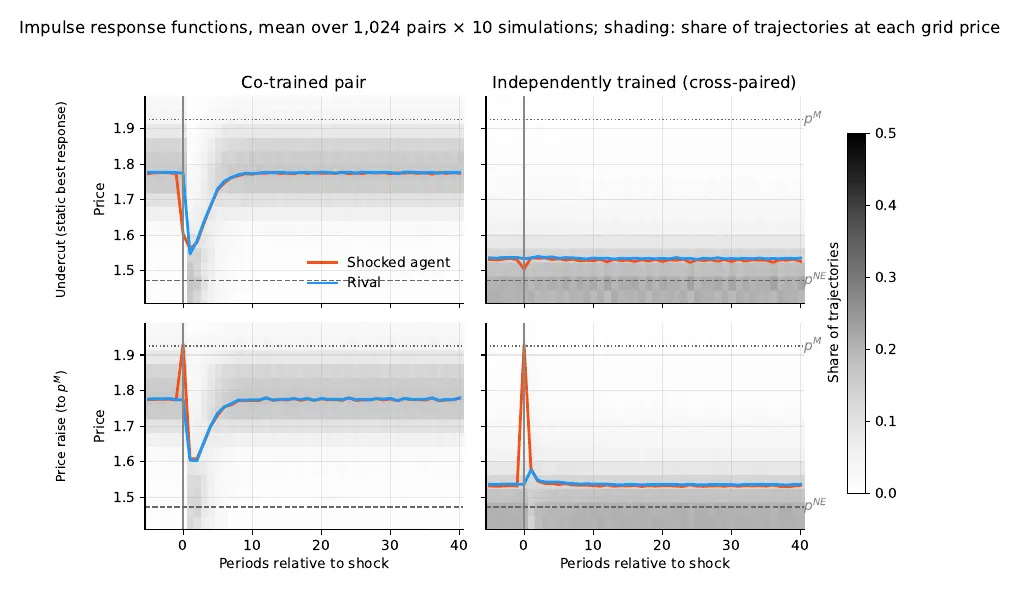
قیمت پس از کاهش اجباری (بالا) یا افزایش اجباری تا قیمت انحصاری (پایین)، برای جفتهای آموزشدیده (چپ) و برای عاملهایی که با غریبهها جفت شدهاند (راست). — شکل 3، Lopes de Moraes و De Losso (2026)، arXiv:2610.21867.
پنج ممیزی، بی هیچ مجازاتگری
جهت اهمیتی ندارد. عامل را وادارید قیمتش را تا سطح انحصاری بالا ببرد — حرکتی به سوی کارتل — و رقیب باز هم قیمتش را پایین میآورد و سپس بازمیگردد، در 960 جفت از 1,024 جفت. پاسخی که با همکاری دقیقاً مانند خیانت رفتار کند، قاعدهای طراحیشده برای بازداشتن از خیانت نیست.
الگویی از حریف در کار نیست. عاملهای آموزشدیده را با رقیبی برنامهریزیشده روبهرو کنید که واقعاً مجازات میکند — تا وقتی به او خیانت نشده همکاری میکند، سپس برای همیشه قیمت رقابتی را بازی میکند. اگر بازی در حالت همکاری آغاز شود، 77٪ عاملها ظرف چهار دوره زیر قیمت او میروند و هرگز بازنمیگردند.
بیرون از مسیر آشنا منطقی نیست. اگر جدولهای آموختهشده را بهعنوان تابعهای واکنش بخوانیم، بهزحمت از بهترین پاسخهای معقول پیروی میکنند (میانگین همبستگی رتبهای 0.18، از −0.70 تا 0.84).
بازگشت اجباری است. در 914 جفت از 1,024 جفت، دو برنامهٔ منجمد یک جاذب (attractor) واحد دارند که همهٔ 225 وضعیت ممکن را به سوی خود میکشد. از هر جایی، پس از هر اختلالی، به هر دلیلی به قیمتهای همیشگیشان بازمیگردند — همانطور که توپی به ته کاسه بازمیغلتد. جدولهای تصادفی این کار را بسیار ضعیفتر انجام میدهند؛ پس آموزش سرعت و جایگاه را میافزاید، اما گزینشگری را نه.
این محدودیت قالب نیست. نویسندگان قاعدههای مجازات واقعی را با دست در همان جدول 225 × 15 ساختند — یکی بخشنده و یکی که هرگز فراموش نمیکند. هر دو کار میکنند. ظرفیت هست؛ یادگیری از آن استفاده نکرد.
قراردادی میان یک جفت
سپس آزمون «غریبه». عاملی را با عاملی از یک دور آموزشی دیگر، با همان پروتکل، که هرگز با هم روبهرو نشدهاند جفت کنید: شاخص تبانی از 0.669 به 0.134 سقوط میکند — فروپاشی 80٪، و 7.4٪ جفتشدنها زیر سطح رقابتی قیمت میدهند. حتی جفتهایی که روی یک قیمت تثبیت شده بودند از هم میپاشند. «تبانی در این محیط راهبردی نیست که یک عامل داشته باشد؛ قراردادی است که یک جفت نگه میدارد.»
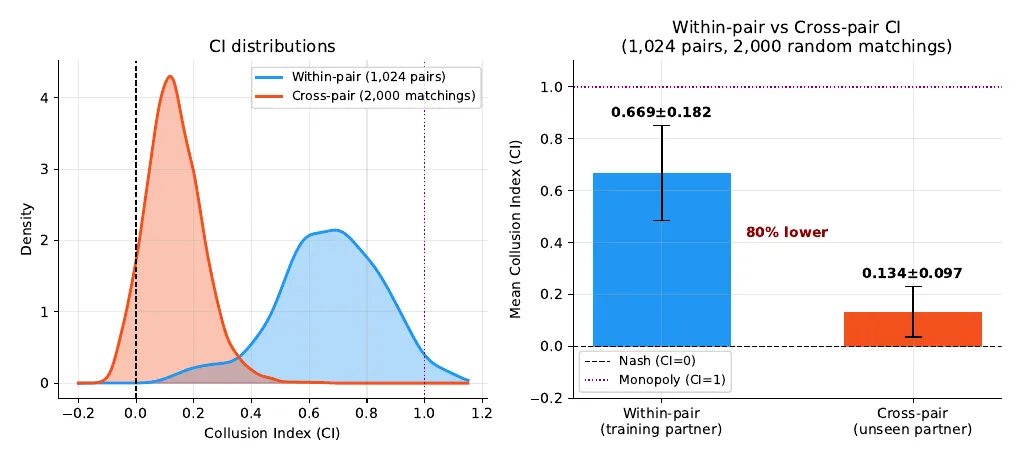
شاخص تبانی با شریک آموزشی (آبی) و با شریکی ناآشنا (نارنجی): 0.669 در برابر 0.134. — شکل 7، Lopes de Moraes و De Losso (2026)، arXiv:2610.21867.
انحرافی که هیچکس امتحان نمیکند
نویسندگان بررسی خود کالوانو را تأیید میکنند: کاهش قیمت یکدورهای در 92٪ جفتها سودی ندارد. اما این انحرافی سادهلوحانه است. محاسبهٔ بهترین راهبرد ممکن در برابر هر شریک منجمد، با برنامهریزی پویای دقیق، بهطور میانگین 17.5٪ سود بیشتر میدهد (تا 93.7٪). تنها 124 عامل از 2,048 عامل همین حالا بهترین پاسخ خود را بازی میکنند. «این سازوکار تنها انحرافی را بازمیدارد که هیچ بهینهسازی برنمیگزیند.»
چرا؟ با کمرنگ شدن کاوش (exploration) در طول آموزش، هر جفت تنها از راهروی باریکی از وضعیتها دیدن میکند. بقیهٔ جدولها عملاً آموزشندیده میمانند. نویسندگان این نتیجه را تعادل خودتأییدگر (self-confirming equilibrium) مینامند — باورهایی که در مسیر پیمودهشده درستاند و بیرون از آن هرگز آزموده نمیشوند. ریزتر کردن شبکهٔ قیمت از 15 به 200 سطح، که همان آموزش را بر وضعیتهای بیشتری پخش میکند، شاخص تبانی را از 0.64 به 0.23 پایین میآورد، درست همانطور که این تصویر پیشبینی میکند. با 5 جفت که دقیقاً طبق قاعدهٔ توقف کالوانو آموزش دیدهاند، همهٔ نتایج برقرار میمانند و انحراف سودآور به 10.4٪ کاهش مییابد.
قیمتها هنوز بالا، درمان متفاوت
مشکل مصرفکننده از میان نمیرود: قیمتها بسیار بالاتر از سطح رقابت میمانند. آنچه تغییر میکند تشخیص است. نویسندگان استدلال میکنند که بدون تهدید مشروط، این جفتها با مقولههای حقوقیِ شبیه توافق جور درنمیآیند — و بر هم زدن جفتها (ورود یک تازهوارد، چرخش، بازآموزی) هماهنگی برنامههای منجمد را نابود میکند. آنها آزمونهایشان را هم بهعنوان معیاری پیش از بهکارگیری هر سامانهٔ قیمتگذاری پیشنهاد میکنند. ادعاهایشان تنها یادگیری Q جدولی در همین یک بازار را در بر میگیرد؛ اینکه آیا عاملهای یادگیری عمیق تهدیدهای واقعی میآموزند، پرسشی است که پروتکل آنها برای پاسخ دادن به آن ساخته شده، نه برای پیشفرض گرفتنش.