দাম নির্ধারণী অ্যালগরিদম যোগসাজশ করে — পরস্পরকে হুমকি না দিয়েই
দাম নির্ধারণের কাজ ক্রমশ শিক্ষণ-ব্যবস্থার হাতে তুলে দেওয়া হচ্ছে। একটি সুপরিচিত ফলাফল প্রতিযোগিতা কর্তৃপক্ষকে উদ্বিগ্ন করে: সরল রিইনফোর্সমেন্ট লার্নিং (reinforcement learning) প্রোগ্রাম, যাদের প্রত্যেককে একটি সিমুলেটেড দুই-প্রতিষ্ঠানের বাজারে শুধু নিজের মুনাফা সর্বোচ্চ করতে প্রশিক্ষণ দেওয়া হয়েছে, শেষমেশ প্রতিযোগিতামূলক স্তরের অনেক ওপরে দাম নেয়। আমেরিকান ইকোনমিক রিভিউ-তে এমিলিও কালভানো (Emilio Calvano) ও সহকর্মীদের 2020 সালের একটি যুগান্তকারী গবেষণা আরও এগিয়েছিল। একটি প্রোগ্রামকে এক পর্বের জন্য দাম কমাতে বাধ্য করার পর তাঁরা দেখলেন প্রতিদ্বন্দ্বীও দাম কমাল, তারপর দুজনেই পুরনো দামে ফিরে গেল। তাঁরা একে পড়লেন একটি “পুরস্কার–শাস্তি ব্যবস্থা” হিসেবে: আমার চেয়ে কম দামে বেচলে প্রতিশোধ নেব, তাই প্রতারণা কখনো লাভজনক নয়।
সাও পাওলো বিশ্ববিদ্যালয়ের কাউয়ে লোপেস দে মোরায়েস (Kauê Lopes de Moraes) ও রদ্রিগো দে লোসো (Rodrigo De Losso) লিখেছেন, এই ব্যাখ্যাই ফলাফলটিকে নীতিগত গুরুত্ব দিয়েছিল। “শুধু উঁচু দাম একটি কৃত্রিম ফল; প্রতিশোধ দিয়ে রক্ষা করা দাম একটি কার্টেল।” তাঁদের প্রশ্ন সংকীর্ণ: সত্যিই কি কোনো শাস্তি-ব্যবস্থা আছে?
আগে পুনরাবৃত্তি, তারপর জমাট
লেখকেরা কালভানোর বাজার আবার তৈরি করেছেন: দুটি প্রতিষ্ঠান, 15টি সম্ভাব্য দাম, প্রতিটি প্রোগ্রাম মানের একটি সারণি (সারণিভিত্তিক Q-লার্নিং) যা আগের দুটি দাম মনে রাখে — 225টি সম্ভাব্য পরিস্থিতি। তাঁরা 1,024টি জোড়াকে প্রশিক্ষণ দিয়েছেন, প্রতিটিকে 20 লক্ষ ধাপ। ফলাফল পুনরাবৃত্ত হয়েছে: দাম স্থির হয় 0.668 যোগসাজশ সূচকে, যেখানে 0 হলো প্রতিযোগিতামূলক (ন্যাশ) দাম আর 1 একচেটিয়া দাম।
বিখ্যাত প্যাটার্নটিও পুনরাবৃত্ত হয়েছে। একটি এজেন্টকে কম দামে বেচতে বাধ্য করুন, 1,024টির মধ্যে 1,013টি জোড়ায় প্রতিদ্বন্দ্বীর দাম পড়ে যায়; 98.2% জোড়ায় দুজনেই আগের দামে ফিরে যায়, সাধারণত পাঁচ পর্বের মধ্যে।
তারপর মূল চাল: প্রশিক্ষিত প্রোগ্রামগুলোকে জমাট (freeze) করুন, শেখা বন্ধ করুন, আর পরীক্ষা করুন তারা আসলে কী বহন করে।
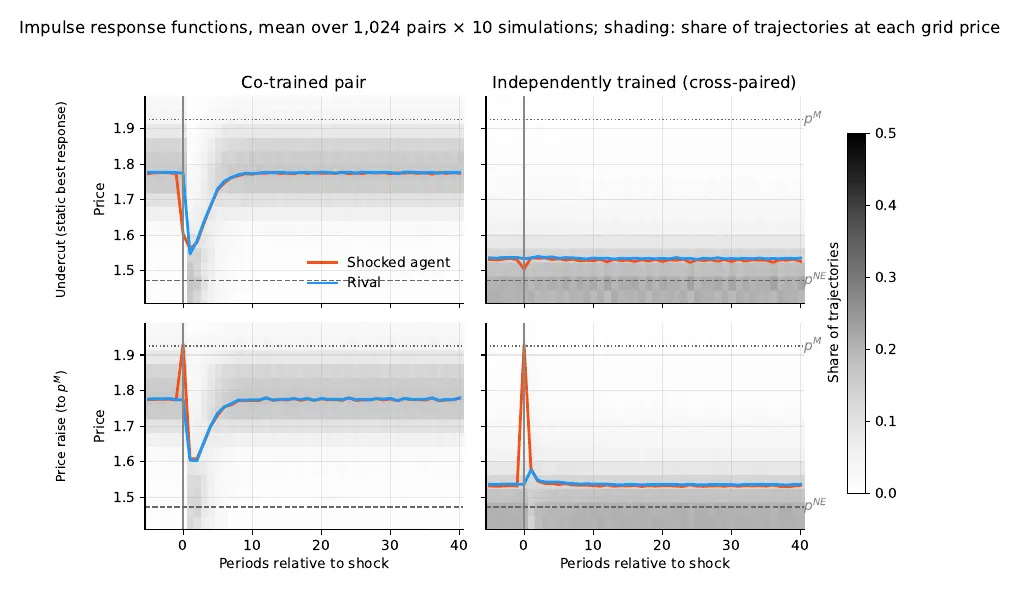
জোর করে দাম কমানোর পর (ওপরে) বা জোর করে একচেটিয়া দামে তোলার পর (নিচে) দাম, প্রশিক্ষিত জোড়ার (বাঁয়ে) এবং অপরিচিতের সঙ্গে জোড়া দেওয়া এজেন্টদের (ডানে) জন্য। — চিত্র 3, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
পাঁচটি নিরীক্ষা, কোনো শাস্তিদাতা নেই
দিক কোনো ব্যাপার নয়। এজেন্টকে দাম একচেটিয়া স্তরে বাড়াতে বাধ্য করুন — যা কার্টেলের দিকে একটি পদক্ষেপ — আর 1,024টির মধ্যে 960টি জোড়ায় প্রতিদ্বন্দ্বী তবুও দাম কমায় এবং তারপর সামলে নেয়। যে প্রতিক্রিয়া সহযোগিতাকে হুবহু বিশ্বাসঘাতকতার মতো দেখে, তা বিশ্বাসঘাতকতা ঠেকানোর জন্য তৈরি নিয়ম নয়।
প্রতিপক্ষের কোনো মডেল নেই। প্রশিক্ষিত এজেন্টদের এমন একটি স্ক্রিপ্ট-চালিত প্রতিদ্বন্দ্বীর মুখোমুখি করুন যে সত্যিই শাস্তি দেয় — প্রতারিত না হওয়া পর্যন্ত সহযোগিতা করে, তারপর চিরকাল প্রতিযোগিতামূলক দাম খেলে। সহযোগিতা দিয়ে শুরু করলে 77% এজেন্ট চার পর্বের মধ্যে তার চেয়ে কম দামে বেচে এবং আর কখনো সামলে ওঠে না।
চেনা পথের বাইরে কোনো যুক্তি নেই। প্রতিক্রিয়া-অপেক্ষক হিসেবে পড়লে শেখা সারণিগুলো যুক্তিসংগত সর্বোত্তম প্রতিক্রিয়া প্রায় মানেই না (গড় ক্রম-সহসম্পর্ক 0.18, −0.70 থেকে 0.84 পর্যন্ত)।
ফেরাটা বাধ্যতামূলক। 1,024টির মধ্যে 914টি জোড়ায় দুটি জমাট প্রোগ্রামের একটিমাত্র আকর্ষক (attractor) আছে, যা সম্ভাব্য সব 225টি পরিস্থিতিকে টেনে আনে। তারা যেকোনো জায়গা থেকে, যেকোনো বিঘ্নের পরে, যেকোনো কারণে তাদের স্বাভাবিক দামে ফিরে আসে — যেমন একটি বল গড়িয়ে বাটির তলায় ফিরে যায়। এলোমেলো সারণি এটা অনেক কম ভালোভাবে করে, তাই প্রশিক্ষণ গতি ও অবস্থান যোগ করে ঠিকই; শুধু বাছবিচার নয়।
এটা বিন্যাসের সীমাবদ্ধতা নয়। লেখকেরা ঠিক সেই একই 225 × 15 সারণিতে হাতে আসল শাস্তি-নিয়ম তৈরি করেছেন — একটি যা ক্ষমা করে, একটি যা কখনো ভোলে না। দুটোই কাজ করে। সামর্থ্য আছে; শেখার প্রক্রিয়া তা ব্যবহার করেনি।
জোড়ার একটি রীতি
এরপর “অপরিচিত” পরীক্ষা। একটি এজেন্টকে ভিন্ন প্রশিক্ষণ-দফার আরেকটির সঙ্গে জোড়া দিন, একই প্রোটোকল, কখনো দেখা হয়নি: যোগসাজশ সূচক 0.669 থেকে 0.134-এ নেমে যায় — 80% পতন, আর 7.4% জোড়া প্রতিযোগিতামূলক স্তরের নিচে দাম রাখে। একই দামে স্থির হওয়া জোড়াগুলোও ভেঙে পড়ে। “এই পরিবেশে যোগসাজশ কোনো এজেন্টের নিজস্ব কৌশল নয়; এটি একটি রীতি, যা একটি জোড়া বজায় রাখে।”
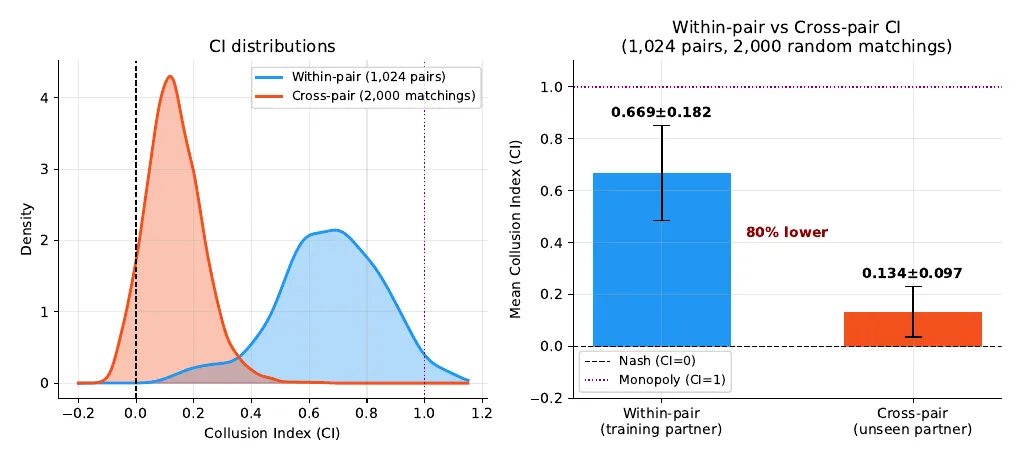
প্রশিক্ষণ-সঙ্গীর সঙ্গে (নীল) এবং অদেখা সঙ্গীর সঙ্গে (কমলা) যোগসাজশ সূচক: 0.669 বনাম 0.134। — চিত্র 7, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
যে বিচ্যুতি কেউ চেষ্টা করে না
লেখকেরা কালভানোর নিজের পরীক্ষাটি নিশ্চিত করেন: এক পর্বের দাম-কমানো 92% জোড়ায় লাভজনক নয়। কিন্তু সেটি একটি সরল বিচ্যুতি। নির্ভুল ডায়নামিক প্রোগ্রামিং দিয়ে প্রতিটি জমাট সঙ্গীর বিরুদ্ধে সম্ভাব্য সর্বোত্তম কৌশল হিসাব করলে গড়ে 17.5% বেশি মুনাফা পাওয়া যায় (93.7% পর্যন্ত)। 2,048টি এজেন্টের মধ্যে মাত্র 124টি ইতিমধ্যে নিজের সর্বোত্তম প্রতিক্রিয়া খেলছে। “এই ব্যবস্থা শুধু সেই বিচ্যুতিকেই নিরুৎসাহিত করে, যা কোনো অপ্টিমাইজার বেছে নেবে না।”
কেন? প্রশিক্ষণের সময় অন্বেষণ (exploration) ফিকে হয়ে আসার সঙ্গে সঙ্গে প্রতিটি জোড়া পরিস্থিতির শুধু একটি সরু করিডোরে ঘোরে। সারণির বাকি সবকিছু কার্যত অপ্রশিক্ষিত থেকে যায়। লেখকেরা ফলাফলটিকে বলেন স্ব-নিশ্চিতকারী ভারসাম্য (self-confirming equilibrium) — এমন বিশ্বাস যা নেওয়া পথে সঠিক এবং সেই পথের বাইরে কখনো পরীক্ষিত হয় না। দামের গ্রিডকে 15 থেকে 200 স্তরে সূক্ষ্ম করলে, যা একই প্রশিক্ষণকে আরও বেশি পরিস্থিতিতে ছড়িয়ে দেয়, যোগসাজশ সূচক 0.64 থেকে 0.23-এ নামে, ঠিক যেমন এই চিত্র পূর্বাভাস দেয়। কালভানোর থামার নিয়ম হুবহু মেনে প্রশিক্ষিত 5টি জোড়ায় প্রতিটি ফলাফল টিকে থাকে, লাভজনক বিচ্যুতি কমে 10.4%-এ দাঁড়ায়।
দাম এখনও উঁচু, প্রতিকার ভিন্ন
ভোক্তার সমস্যা দূর হয় না: দাম প্রতিযোগিতার চেয়ে অনেক ওপরে থাকে। যা বদলায় তা হলো রোগনির্ণয়। লেখকদের যুক্তি, শর্তসাপেক্ষ কোনো হুমকি না থাকায় এই জোড়াগুলো চুক্তি-সদৃশ আইনি শ্রেণিতে ঠিকমতো খাপ খায় না — এবং জোড়া এলোমেলো করা (নতুন প্রবেশকারী, পালাবদল, পুনঃপ্রশিক্ষণ) জমাট প্রোগ্রামগুলোর সমন্বয় ধ্বংস করে দেয়। তাঁরা তাঁদের পরীক্ষাগুলোকে যেকোনো দাম-নির্ধারণী ব্যবস্থা চালুর আগের একটি মানদণ্ড হিসেবেও প্রস্তাব করেন। তাঁদের দাবি এই একটি বাজারে সারণিভিত্তিক Q-লার্নিংয়ের মধ্যে সীমিত; ডিপ-লার্নিং এজেন্ট আসল হুমকি শেখে কি না, সেটি এমন এক প্রশ্ন যার উত্তর দেওয়ার জন্যই তাঁদের প্রোটোকল তৈরি, আগে থেকে ধরে নেওয়ার জন্য নয়।