क़ीमत तय करने वाले एल्गोरिद्म साठगाँठ करते हैं — एक-दूसरे को धमकाए बिना
क़ीमतें तय करने का काम तेज़ी से सीखने वाली प्रणालियों को सौंपा जा रहा है। एक जानी-मानी खोज प्रतिस्पर्धा प्राधिकरणों को चिंतित करती है: सरल सुदृढ़ीकरण अधिगम (reinforcement learning) प्रोग्राम, जिनमें से हर एक को एक सिम्युलेटेड दो-कंपनी बाज़ार में केवल अपना मुनाफ़ा अधिकतम करने के लिए प्रशिक्षित किया गया है, आख़िरकार प्रतिस्पर्धी स्तर से काफ़ी ऊपर क़ीमतें वसूलते हैं। अमेरिकन इकोनॉमिक रिव्यू में एमिलियो कालवानो (Emilio Calvano) और सहयोगियों के 2020 के एक ऐतिहासिक अध्ययन ने एक क़दम आगे बढ़कर देखा। एक प्रोग्राम को एक अवधि के लिए अपनी क़ीमत घटाने पर मजबूर करने के बाद उन्होंने देखा कि प्रतिद्वंद्वी ने भी क़ीमत घटाई, और फिर दोनों अपनी पुरानी क़ीमतों पर लौट आए। उन्होंने इसे एक “इनाम–सज़ा योजना” के रूप में पढ़ा: मुझसे सस्ता बेचोगे तो मैं बदला लूँगा, इसलिए धोखा कभी फ़ायदेमंद नहीं होता।
साओ पाउलो विश्वविद्यालय के काउए लोपेस दे मोराएस (Kauê Lopes de Moraes) और रोद्रिगो दे लोस्सो (Rodrigo De Losso) लिखते हैं कि इसी व्याख्या ने नतीजे को नीतिगत वज़न दिया। “केवल ऊँची क़ीमतें एक कृत्रिम परिणाम हैं; बदले से बचाई गई क़ीमतें एक कार्टेल हैं।” उनका प्रश्न सीमित है: क्या वाक़ई कोई सज़ा-तंत्र मौजूद है?
पहले दोहराओ, फिर जमाओ
लेखकों ने कालवानो का बाज़ार दोबारा बनाया: दो कंपनियाँ, 15 संभावित क़ीमतें, हर प्रोग्राम मानों की एक तालिका (तालिका-आधारित Q-लर्निंग) जो पिछली दो क़ीमतें याद रखती है — 225 संभावित स्थितियाँ। उन्होंने 1,024 जोड़ियों को प्रशिक्षित किया, हर एक को 20 लाख क़दम। नतीजा दोहराया गया: क़ीमतें 0.668 के साठगाँठ सूचकांक पर टिक जाती हैं, जहाँ 0 प्रतिस्पर्धी (नैश) क़ीमत है और 1 एकाधिकार क़ीमत।
प्रसिद्ध पैटर्न भी दोहराया गया। एक एजेंट को सस्ता बेचने पर मजबूर कीजिए, तो 1,024 में से 1,013 जोड़ियों में प्रतिद्वंद्वी की क़ीमत गिरती है; 98.2% जोड़ियों में दोनों अपनी पिछली क़ीमतों पर लौट आते हैं, आम तौर पर पाँच अवधियों के भीतर।
फिर मुख्य चाल: प्रशिक्षित प्रोग्रामों को जमा दीजिए (freeze), सीखना बंद कीजिए, और परखिए कि उनमें वास्तव में क्या है।
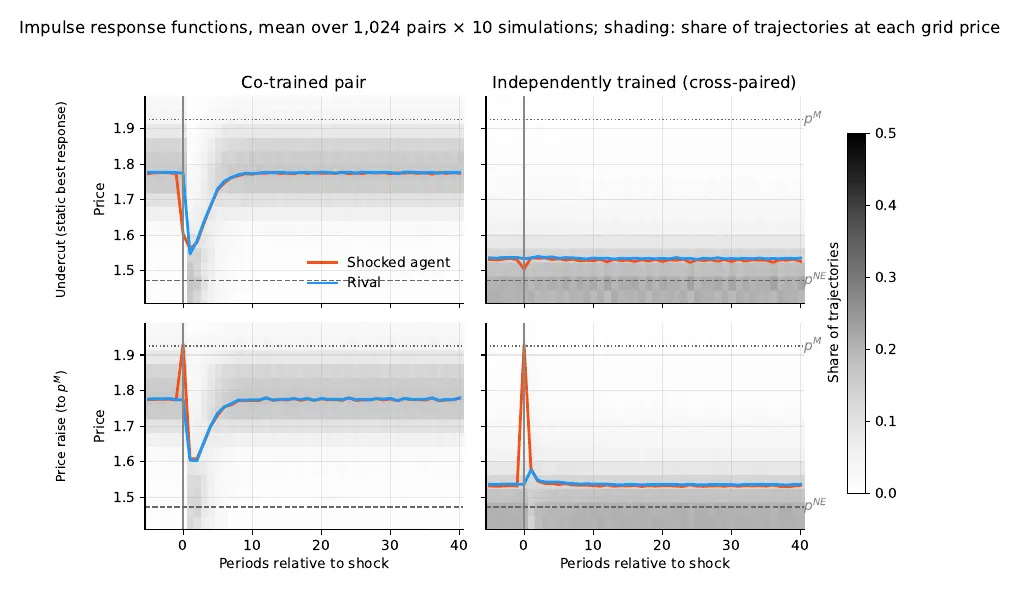
ज़बरन घटाई गई क़ीमत (ऊपर) या एकाधिकार क़ीमत तक ज़बरन बढ़ाई गई क़ीमत (नीचे) के बाद की क़ीमत, प्रशिक्षित जोड़ियों (बाएँ) और अजनबियों के साथ जोड़े गए एजेंटों (दाएँ) के लिए। — चित्र 3, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
पाँच जाँचें, कोई सज़ा देने वाला नहीं
दिशा मायने नहीं रखती। एजेंट को अपनी क़ीमत एकाधिकार स्तर तक बढ़ाने पर मजबूर कीजिए — जो कार्टेल की ओर एक क़दम है — और 1,024 में से 960 जोड़ियों में प्रतिद्वंद्वी फिर भी अपनी क़ीमत गिराता है और फिर उबर जाता है। जो प्रतिक्रिया सहयोग को ठीक विश्वासघात की तरह मानती है, वह विश्वासघात को रोकने के लिए बनाया गया नियम नहीं है।
प्रतिद्वंद्वी का कोई मॉडल नहीं। प्रशिक्षित एजेंटों का सामना एक पटकथाबद्ध प्रतिद्वंद्वी से कराइए जो सचमुच सज़ा देता है — वह तब तक सहयोग करता है जब तक उसे धोखा न दिया जाए, फिर हमेशा के लिए प्रतिस्पर्धी क़ीमत खेलता है। सहयोग से शुरू करने पर 77% एजेंट चार अवधियों के भीतर उससे सस्ता बेचने लगते हैं और कभी उबर नहीं पाते।
बने-बनाए रास्ते से हटकर कोई तर्क नहीं। प्रतिक्रिया-फलनों के रूप में पढ़ने पर सीखी गई तालिकाएँ समझदार सर्वोत्तम प्रतिक्रियाओं का मुश्किल से पालन करती हैं (औसत कोटि सहसंबंध 0.18, −0.70 से 0.84 तक)।
वापसी मजबूरी है। 1,024 में से 914 जोड़ियों में दोनों जमे हुए प्रोग्रामों का एक ही आकर्षक (attractor) है जो सभी 225 संभावित स्थितियों को अपनी ओर खींच लेता है। वे कहीं से भी, किसी भी व्यवधान के बाद, किसी भी कारण से अपनी सामान्य क़ीमतों पर लौट आते हैं — जैसे गेंद कटोरे की तली में लुढ़क आती है। यादृच्छिक तालिकाएँ यह काफ़ी कम अच्छी तरह करती हैं, इसलिए प्रशिक्षण गति और स्थान तो जोड़ता है; बस चयनात्मकता नहीं।
यह प्रारूप की सीमा नहीं है। लेखकों ने ठीक उसी 225 × 15 तालिका में हाथ से असली सज़ा-नियम बनाए — एक जो माफ़ कर देता है, एक जो कभी नहीं भूलता। दोनों काम करते हैं। क्षमता मौजूद है; सीखने की प्रक्रिया ने उसका उपयोग नहीं किया।
जोड़ी की एक परिपाटी
अगला, “अजनबी” परीक्षण। एक एजेंट को किसी दूसरे प्रशिक्षण-दौर के एजेंट से जोड़िए, प्रोटोकॉल वही, पर कभी मिले नहीं: साठगाँठ सूचकांक 0.669 से गिरकर 0.134 हो जाता है — 80% की गिरावट, और 7.4% जोड़ियाँ प्रतिस्पर्धी स्तर से भी नीचे क़ीमत रखती हैं। एक ही क़ीमत पर टिकी जोड़ियाँ भी बिखर जाती हैं। “इस परिवेश में साठगाँठ कोई ऐसी रणनीति नहीं जो किसी एजेंट के पास हो; यह एक परिपाटी है जिसे एक जोड़ी निभाती है।”
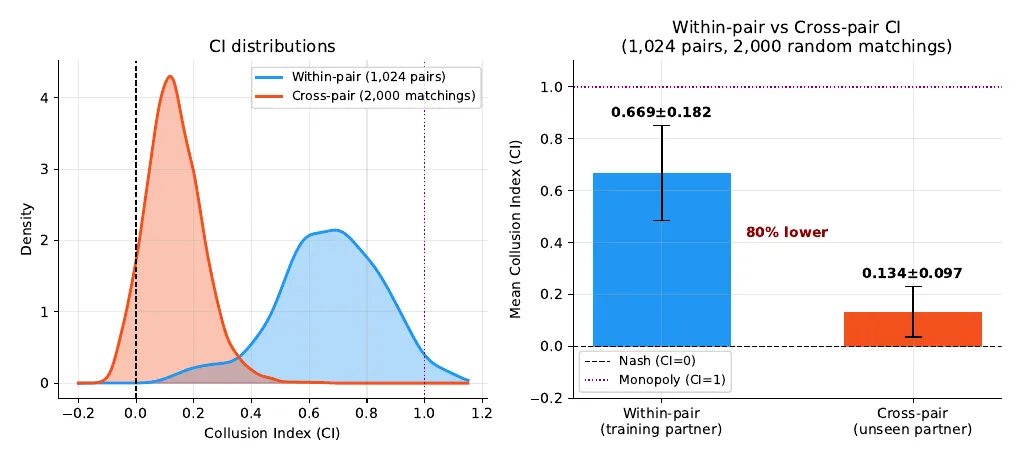
प्रशिक्षण-साथी (नीला) और अनदेखे साथी (नारंगी) के साथ साठगाँठ सूचकांक: 0.669 बनाम 0.134। — चित्र 7, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
वह विचलन जिसे कोई नहीं आज़माता
लेखक कालवानो की अपनी जाँच की पुष्टि करते हैं: एक अवधि की क़ीमत-कटौती 92% जोड़ियों में फ़ायदेमंद नहीं होती। लेकिन वह एक भोला विचलन है। सटीक डायनेमिक प्रोग्रामिंग से हर जमे हुए साथी के ख़िलाफ़ सर्वोत्तम संभव रणनीति की गणना करने पर औसतन 17.5% ज़्यादा मुनाफ़ा मिलता है (93.7% तक)। 2,048 में से केवल 124 एजेंट पहले से अपनी सर्वोत्तम प्रतिक्रिया खेल रहे हैं। “यह योजना केवल उसी विचलन को रोकती है जिसे कोई भी इष्टतमकर्ता (optimizer) नहीं चुनेगा।”
क्यों? प्रशिक्षण के दौरान जैसे-जैसे अन्वेषण (exploration) घटता है, हर जोड़ी स्थितियों के केवल एक संकरे गलियारे में घूमती है। तालिकाओं में बाक़ी सब कुछ व्यावहारिक रूप से अप्रशिक्षित रह जाता है। लेखक इस नतीजे को स्व-पुष्टिकारी संतुलन (self-confirming equilibrium) कहते हैं — ऐसी धारणाएँ जो अपनाए गए रास्ते पर सही हैं और उससे हटकर कभी परखी नहीं जातीं। क़ीमत-ग्रिड को 15 से 200 स्तरों तक बारीक करने पर, जो उसी प्रशिक्षण को ज़्यादा स्थितियों में फैला देता है, साठगाँठ सूचकांक 0.64 से 0.23 पर आ जाता है, जैसा यह तस्वीर पूर्वानुमान करती है। कालवानो के रुकने के नियम के ठीक अनुसार प्रशिक्षित 5 जोड़ियों के साथ हर नतीजा बना रहता है, और फ़ायदेमंद विचलन घटकर 10.4% रह जाता है।
क़ीमतें अब भी ऊँची, इलाज अलग
उपभोक्ता की समस्या दूर नहीं होती: क़ीमतें प्रतिस्पर्धा से काफ़ी ऊपर रहती हैं। जो बदलता है वह है निदान। लेखकों का तर्क है कि किसी सशर्त धमकी के अभाव में ये जोड़ियाँ समझौते जैसी क़ानूनी श्रेणियों में ठीक से नहीं बैठतीं — और जोड़ियों में व्यवधान (कोई नया प्रवेशी, अदला-बदली, दोबारा प्रशिक्षण) जमे हुए प्रोग्रामों का तालमेल नष्ट कर देता है। वे अपने परीक्षणों को किसी भी मूल्य-निर्धारण प्रणाली की तैनाती से पहले के मानक के रूप में भी पेश करते हैं। उनके दावे इस एक बाज़ार में तालिका-आधारित Q-लर्निंग तक सीमित हैं; डीप-लर्निंग एजेंट असली धमकियाँ सीखते हैं या नहीं, यह एक ऐसा प्रश्न है जिसका उत्तर देने के लिए उनका प्रोटोकॉल बना है, उसे पहले से मान लेने के लिए नहीं।