किंमत ठरवणारे अल्गोरिदम संगनमत करतात — एकमेकांना धमकावल्याशिवाय
किंमत ठरवण्याचे काम अधिकाधिक शिकणाऱ्या प्रणालींकडे सोपवले जात आहे. एक सुप्रसिद्ध निष्कर्ष स्पर्धा-प्राधिकरणांना चिंतेत टाकतो: साधे प्रबलन-अध्ययन (reinforcement learning) प्रोग्राम, प्रत्येक केवळ आपला स्वतःचा नफा वाढवण्यासाठी, दोन कंपन्यांच्या सिम्युलेट केलेल्या बाजारात, प्रशिक्षित केलेला, अखेरीस स्पर्धात्मक पातळीपेक्षा बऱ्याच जास्त किंमती आकारतात. एमिलिओ काल्व्हानो (Emilio Calvano) आणि सहकाऱ्यांच्या American Economic Review मधील 2020 च्या एका महत्त्वाच्या अभ्यासाने यापुढे जाऊन पाहिले. एका प्रोग्रामला एका कालावधीसाठी किंमत कमी करायला भाग पाडल्यावर, त्यांना दिसले की प्रतिस्पर्धीही किंमत कमी करतो, आणि मग दोघेही जुन्या किंमतींवर परततात. त्यांनी याचा अर्थ “बक्षीस–शिक्षा योजना” असा लावला: माझ्यापेक्षा स्वस्त विकलेस तर मी बदला घेतो, म्हणून फसवणूक कधीच फायद्याची ठरत नाही.
साओ पावलो विद्यापीठाचे काउए लोपेस दे मोराएस (Kauê Lopes de Moraes) आणि रोद्रिगो दे लोसो (Rodrigo De Losso) लिहितात की याच स्पष्टीकरणामुळे या निकालाला धोरणात्मक वजन मिळाले. “केवळ जास्त असलेल्या किंमती ही एक कृत्रिम निष्पत्ती आहे; बदल्याने संरक्षित किंमती म्हणजे कार्टेल.” त्यांचा प्रश्न मर्यादित आहे: शिक्षेची यंत्रणा खरोखर अस्तित्वात आहे का?
आधी पुनरावृत्ती, मग गोठवणे
लेखकांनी काल्व्हानोचा बाजार पुन्हा उभारला: दोन कंपन्या, 15 संभाव्य किंमती, प्रत्येक प्रोग्राम म्हणजे आधीच्या दोन किंमती लक्षात ठेवणारा मूल्यांचा तक्ता (तक्त्याधारित Q-learning) — 225 संभाव्य परिस्थिती. त्यांनी 1,024 जोड्या प्रशिक्षित केल्या, प्रत्येकी 20 लाख टप्पे. निकालाची पुनरावृत्ती होते: किंमती 0.668 संगनमत-निर्देशांकावर स्थिरावतात, जिथे 0 म्हणजे स्पर्धात्मक (नॅश) किंमत आणि 1 म्हणजे मक्तेदारी किंमत.
प्रसिद्ध आकृतिबंधाचीही पुनरावृत्ती होते. एका एजंटला स्वस्त विकायला भाग पाडा, आणि 1,024 पैकी 1,013 जोड्यांमध्ये प्रतिस्पर्ध्याची किंमत खाली येते; 98.2% जोड्यांमध्ये दोघेही आपल्या आधीच्या किंमतींवर परततात, सहसा पाच कालावधींच्या आत.
मग निर्णायक चाल: प्रशिक्षित प्रोग्राम गोठवा, शिकणे बंद करा, आणि ते प्रत्यक्षात काय घेऊन चालतात ते तपासा.
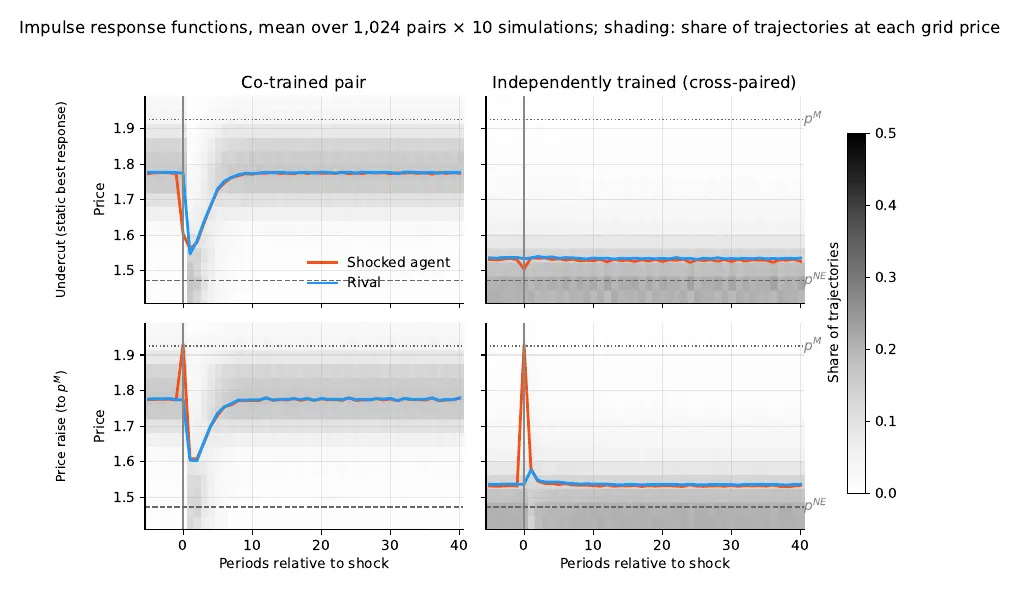
सक्तीच्या किंमत-घटीनंतर (वर) किंवा मक्तेदारी किंमतीपर्यंत सक्तीच्या वाढीनंतर (खाली) किंमत, प्रशिक्षित जोड्यांसाठी (डावीकडे) आणि अनोळखी एजंटबरोबर जोडलेल्या एजंटसाठी (उजवीकडे). — Figure 3, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
पाच लेखापरीक्षणे, शिक्षा करणारा कोणी नाही
दिशेला महत्त्व नाही. एजंटला आपली किंमत मक्तेदारी पातळीपर्यंत वाढवायला भाग पाडा — कार्टेलकडे जाणारी चाल — तरीही प्रतिस्पर्धी आपली किंमत कमी करतो आणि मग पूर्ववत होतो, 1,024 पैकी 960 जोड्यांमध्ये. सहकार्याला अगदी विश्वासघातासारखीच वागणूक देणारा प्रतिसाद हा विश्वासघात रोखण्यासाठी रचलेला नियम नव्हे.
प्रतिस्पर्ध्याचे कोणतेही मॉडेल नाही. प्रशिक्षित एजंटना अशा पूर्वलिखित प्रतिस्पर्ध्यासमोर उभे करा जो खरोखर शिक्षा करतो — विश्वासघात होईपर्यंत तो सहकार्य करतो, मग कायमची स्पर्धात्मक किंमत खेळतो. सहकार्यापासून सुरुवात केल्यावर, 77% एजंट चार कालावधींच्या आत त्याच्यापेक्षा स्वस्त विकतात आणि कधीच सावरत नाहीत.
मळलेल्या वाटेबाहेर कोणतेही तर्कशास्त्र नाही. प्रतिक्रिया-फलने म्हणून वाचले, तर शिकलेले तक्ते समंजस सर्वोत्तम प्रतिसादांचे क्वचितच पालन करतात (सरासरी क्रम-सहसंबंध 0.18, −0.70 ते 0.84 या कक्षेत).
परतणे सक्तीचे आहे. 1,024 पैकी 914 जोड्यांमध्ये, गोठवलेल्या दोन प्रोग्रामचे एकच आकर्षक (attractor) असते, जे सर्व 225 संभाव्य परिस्थिती आपल्याकडे खेचते. ते कुठूनही, कोणत्याही व्यत्ययानंतर, कोणत्याही कारणाने आपल्या नेहमीच्या किंमतींवर परततात — जसा चेंडू वाडग्याच्या तळाशी परत घरंगळतो. यादृच्छिक तक्ते हे खूपच कमी चांगल्या प्रकारे करतात, म्हणजे प्रशिक्षण वेग आणि स्थान नक्कीच वाढवते; फक्त निवडकता नाही.
ही स्वरूपाची मर्यादा नाही. लेखकांनी त्याच 225 × 15 तक्त्यात खरे शिक्षा-नियम हाताने रचले — एक माफ करणारा, एक कधीच न विसरणारा. दोन्ही चालतात. क्षमता आहे; शिकण्याने ती वापरली नाही.
जोडीची एक प्रथा
पुढे, “अनोळखी” चाचणी. एखाद्या एजंटला वेगळ्या प्रशिक्षण-फेरीतील, त्याच कार्यपद्धतीच्या, कधीही न भेटलेल्या एजंटबरोबर जोडा: संगनमत-निर्देशांक 0.669 वरून 0.134 वर घसरतो — 80% कोसळ, आणि 7.4% जोडण्यांमध्ये किंमत स्पर्धात्मक पातळीच्या खाली जाते. एकाच किंमतीवर स्थिरावलेल्या जोड्यासुद्धा विस्कळीत होतात. “या वातावरणातील संगनमत ही एखाद्या एजंटकडे असलेली रणनीती नव्हे; ती एखादी जोडी पाळत असलेली प्रथा आहे.”
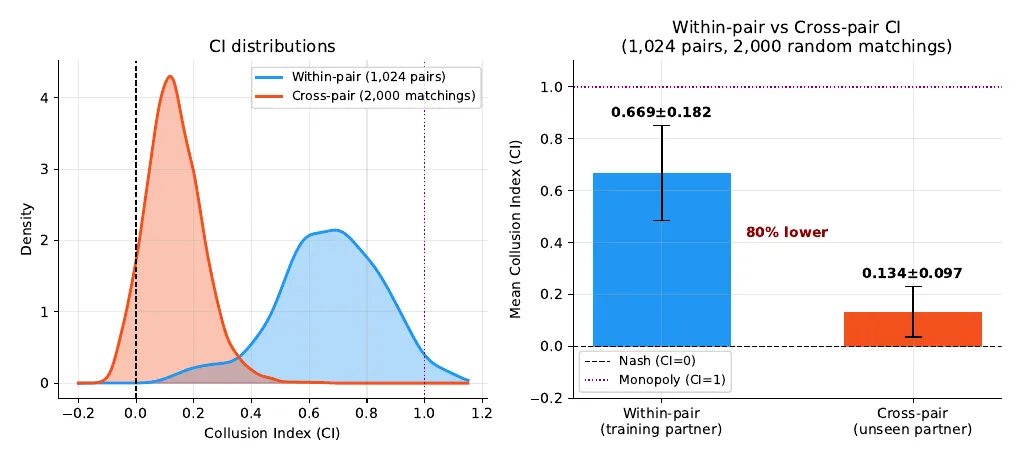
प्रशिक्षणातील भागीदाराबरोबर (निळा) आणि न पाहिलेल्या भागीदाराबरोबर (नारिंगी) संगनमत-निर्देशांक: 0.669 विरुद्ध 0.134. — Figure 7, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
कोणीही करून न पाहिलेले विचलन
लेखक काल्व्हानोच्या स्वतःच्या तपासणीची पुष्टी करतात: एका कालावधीची किंमत-घट 92% जोड्यांमध्ये फायद्याची ठरत नाही. पण ते एक भोळे विचलन आहे. प्रत्येक गोठवलेल्या भागीदाराविरुद्ध सर्वोत्तम संभाव्य रणनीती अचूक गतिशील प्रोग्रामिंगने (dynamic programming) काढली, तर सरासरी 17.5% जास्त नफा मिळतो (93.7% पर्यंत). 2,048 पैकी फक्त 124 एजंट आधीच आपला सर्वोत्तम प्रतिसाद खेळत आहेत. “ही योजना फक्त असेच विचलन रोखते जे कोणताही इष्टतमीकरण करणारा निवडणार नाही.”
का? प्रशिक्षणादरम्यान अन्वेषण जसजसे ओसरते, तसतशी प्रत्येक जोडी परिस्थितींच्या एका अरुंद मार्गिकेलाच भेट देते. तक्त्यांमधील बाकी सर्व काही व्यावहारिकदृष्ट्या अप्रशिक्षित राहते. लेखक या निकालाला स्व-पुष्टी करणारा समतोल (self-confirming equilibrium) म्हणतात — घेतलेल्या मार्गावर बरोबर ठरणाऱ्या आणि त्याबाहेर कधीच न तपासलेल्या समजुती. किंमतींची जाळी 15 वरून 200 पातळ्यांपर्यंत बारीक केली, ज्यामुळे तेच प्रशिक्षण अधिक परिस्थितींवर पसरते, तर संगनमत-निर्देशांक 0.64 वरून 0.23 वर येतो, जसे हे चित्र भाकीत करते. काल्व्हानोच्या थांबण्याच्या नियमानुसार अचूकपणे प्रशिक्षित केलेल्या 5 जोड्यांसह, प्रत्येक निकाल टिकतो, आणि फायदेशीर विचलन 10.4% पर्यंत आकुंचन पावते.
किंमती अजूनही जास्त, उपाय वेगळा
ग्राहकाचा प्रश्न संपत नाही: किंमती स्पर्धेपेक्षा बऱ्याच जास्तच राहतात. बदलते ते निदान. लेखकांचा युक्तिवाद असा की, सशर्त धमकी नसल्यामुळे, या जोड्या करारासारख्या कायदेशीर वर्गवारीत नीट बसत नाहीत — आणि जोडण्यांमध्ये व्यत्यय आणणे (नवा प्रवेशक, आवर्तन, पुनर्प्रशिक्षण) गोठवलेल्या प्रोग्रामचा समन्वय नष्ट करते. ते आपल्या चाचण्या कोणत्याही किंमत-प्रणालीसाठी वापरात आणण्यापूर्वीचे मानक म्हणूनही सुचवतात. त्यांचे दावे या एका बाजारातील तक्त्याधारित Q-learning पुरते आहेत; सखोल-अध्ययन (deep learning) एजंट खऱ्या धमक्या शिकतात का, हा प्रश्न त्यांची कार्यपद्धती गृहीत धरण्यासाठी नव्हे, तर उत्तर देण्यासाठी रचलेली आहे.