ALGORITMOS DE PREÇOS FAZEM CONLUIO — SEM SE AMEAÇAREM
A definição de preços é cada vez mais confiada a sistemas de aprendizagem. Uma descoberta conhecida preocupa as autoridades de concorrência: programas simples de aprendizagem por reforço, cada um treinado apenas para maximizar o próprio lucro num mercado simulado com duas empresas, acabam cobrando preços bem acima do nível competitivo. Um estudo marcante de 2020, de Emilio Calvano e colegas, publicado na American Economic Review, foi além. Depois de forçar um programa a baixar o preço durante um período, eles viram o rival baixar também, e depois os dois voltarem aos preços anteriores. Interpretaram isso como um “esquema de recompensa e punição”: baixe o preço e eu retalio, de modo que trapacear nunca compensa.
Essa leitura, escrevem Kauê Lopes de Moraes e Rodrigo De Losso, da Universidade de São Paulo, foi o que deu ao resultado o seu peso para as políticas públicas. “Preços que são apenas altos são um artefato; preços defendidos por retaliação são um cartel.” A pergunta deles é estreita: existe de fato um mecanismo de punição?
Primeiro replicar, depois congelar
Os autores reconstruíram o mercado de Calvano: duas empresas, 15 preços possíveis, cada programa uma tabela de valores (Q-learning tabular) que se lembra dos dois preços anteriores — 225 situações possíveis. Treinaram 1024 pares, com 2 milhões de passos cada. O resultado se replica: os preços se estabilizam num índice de conluio de 0,668, em que 0 é o preço competitivo (de Nash) e 1 o preço de monopólio.
O padrão famoso também se replica. Force um agente a baixar o preço, e em 1013 dos 1024 pares o preço do rival cai; em 98,2% dos pares, os dois voltam aos preços anteriores, geralmente em até cinco períodos.
Depois vem o lance decisivo: congelar os programas treinados, desligar a aprendizagem e testar o que eles realmente carregam.
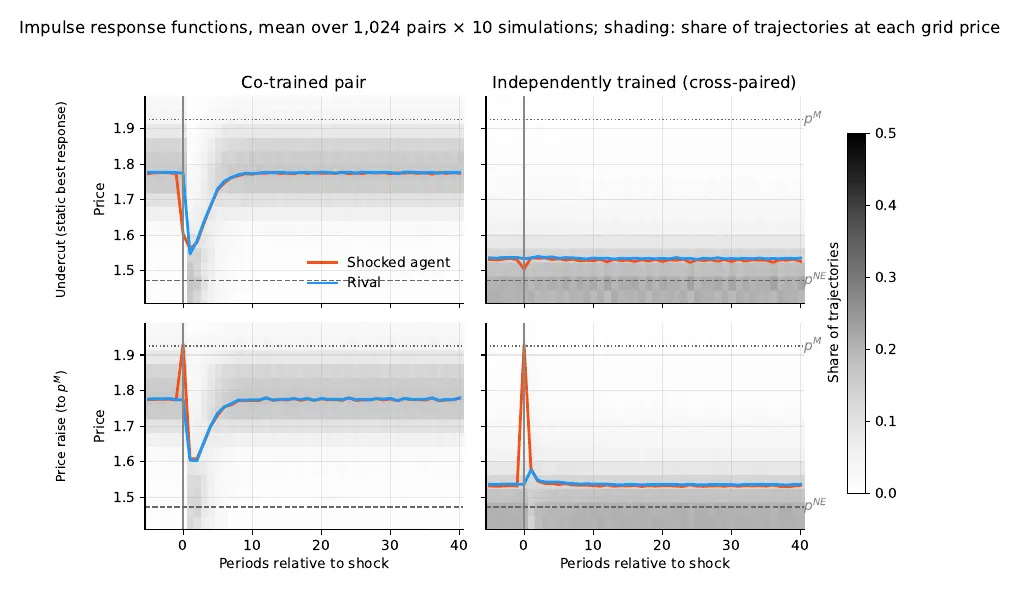
Preço após uma redução forçada (em cima) ou um aumento forçado até o preço de monopólio (embaixo), para pares treinados (à esquerda) e para agentes emparelhados com desconhecidos (à direita). — Figura 3, Lopes de Moraes e De Losso (2026), arXiv:2610.21867.
Cinco auditorias, nenhum punidor
A direção não importa. Force o agente a aumentar o preço até o nível de monopólio — um movimento em direção ao cartel —, e o rival ainda assim baixa o preço e depois se recupera, em 960 dos 1024 pares. Uma resposta que trata a cooperação exatamente como a traição não é uma regra concebida para dissuadir a traição.
Nenhum modelo do adversário. Coloque os agentes treinados diante de um rival programado que pune de verdade — ele coopera até ser contrariado e, a partir daí, joga o preço competitivo para sempre. Partindo da cooperação, 77% dos agentes baixam o preço contra ele em até quatro períodos e nunca se recuperam.
Nenhuma lógica fora do caminho habitual. Lidas como funções de reação, as tabelas aprendidas mal seguem respostas ótimas sensatas (correlação de postos média de 0,18, variando de −0,70 a 0,84).
O retorno é forçado. Em 914 dos 1024 pares, os dois programas congelados têm um único atrator que puxa todas as 225 situações possíveis. Eles voltam aos preços habituais a partir de qualquer lugar, depois de qualquer perturbação, por qualquer motivo — como uma bola que rola de volta ao fundo de uma tigela. Tabelas aleatórias fazem isso muito pior, portanto o treinamento acrescenta velocidade e posicionamento; só não acrescenta seletividade.
Não é um limite do formato. Os autores construíram à mão verdadeiras regras de punição — uma que perdoa, outra que nunca esquece — na mesmíssima tabela de 225 × 15. Ambas funcionam. A capacidade existe; a aprendizagem não a usou.
Uma convenção do par
Em seguida, o teste do “desconhecido”. Junte um agente com outro de uma execução de treinamento diferente, mesmo protocolo, que nunca se encontraram: o índice de conluio cai de 0,669 para 0,134 — um colapso de 80%, com 7,4% dos emparelhamentos fixando preços abaixo do nível competitivo. Até pares que tinham se estabilizado no mesmo preço se desfazem. “O conluio neste ambiente não é uma estratégia que um agente tem; é uma convenção que um par mantém.”
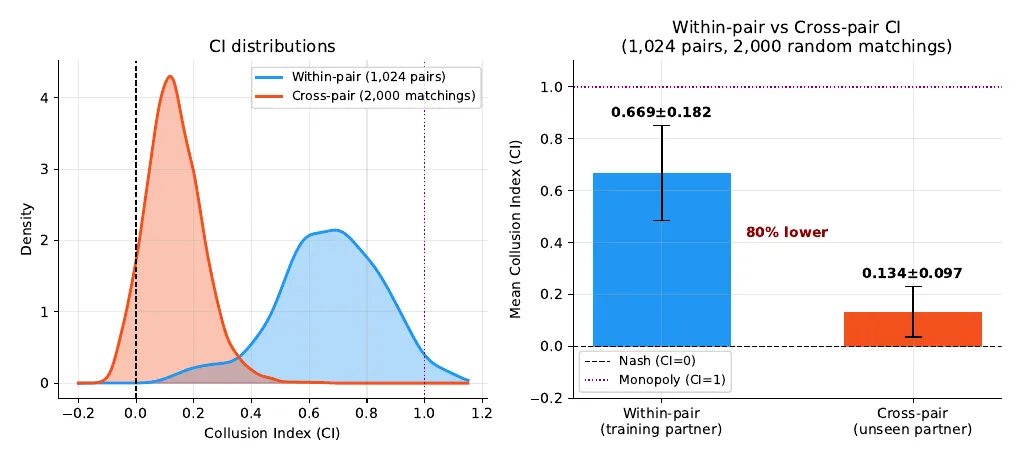
Índice de conluio com o parceiro de treinamento (azul) e com um parceiro desconhecido (laranja): 0,669 contra 0,134. — Figura 7, Lopes de Moraes e De Losso (2026), arXiv:2610.21867.
O desvio que ninguém tenta
Os autores confirmam, sim, a verificação do próprio Calvano: uma redução de preço de um período não compensa em 92% dos pares. Mas esse é um desvio ingênuo. Calcular a melhor estratégia possível contra cada parceiro congelado, por programação dinâmica exata, dá 17,5% a mais de lucro em média (até 93,7%). Apenas 124 dos 2048 agentes já jogam a sua melhor resposta. “O esquema dissuade apenas o desvio que nenhum otimizador escolheria.”
Por quê? À medida que a exploração diminui durante o treinamento, cada par visita apenas um corredor estreito de situações. Todo o resto das tabelas permanece praticamente sem treinamento. Os autores chamam o resultado de equilíbrio autoconfirmado — crenças que estão corretas no caminho percorrido e nunca são testadas fora dele. Refinar a grade de preços de 15 para 200 níveis, o que espalha o mesmo treinamento por mais situações, reduz o índice de conluio de 0,64 para 0,23, como esse quadro prevê. Com 5 pares treinados exatamente segundo a regra de parada de Calvano, todos os resultados se mantêm, e o desvio lucrativo encolhe para 10,4%.
Preços ainda altos, remédio diferente
O problema para o consumidor não desaparece: os preços continuam bem acima da concorrência. O que muda é o diagnóstico. Os autores argumentam que, sem ameaça condicional, esses pares se encaixam mal em categorias jurídicas do tipo acordo — e que perturbar os emparelhamentos (um novo concorrente, rotação, novo treinamento) destrói a coordenação dos programas congelados. Eles também propõem os seus testes como um padrão a aplicar antes da implantação de qualquer sistema de preços. As suas conclusões abrangem o Q-learning tabular neste único mercado; se agentes de aprendizagem profunda aprendem ameaças genuínas é uma pergunta que o seu protocolo foi construído para responder, não para presumir.