THUẬT TOÁN ĐỊNH GIÁ CẤU KẾT — MÀ KHÔNG ĐE DỌA NHAU
Việc định giá ngày càng được giao cho các hệ thống học máy. Một phát hiện nổi tiếng khiến các cơ quan cạnh tranh lo ngại: những chương trình học tăng cường (reinforcement learning) đơn giản, mỗi chương trình chỉ được huấn luyện để tối đa hóa lợi nhuận của riêng nó trong một thị trường mô phỏng có hai công ty, cuối cùng đặt giá cao hơn hẳn mức cạnh tranh. Một nghiên cứu mang tính bước ngoặt năm 2020 của Emilio Calvano và các đồng nghiệp trên American Economic Review còn đi xa hơn. Sau khi buộc một chương trình giảm giá trong một kỳ, họ thấy đối thủ cũng giảm giá, rồi cả hai quay về mức giá cũ. Họ diễn giải điều này là một “cơ chế thưởng–phạt”: hạ giá với tôi thì tôi trả đũa, nên gian lận không bao giờ có lời.
Kauê Lopes de Moraes và Rodrigo De Losso thuộc Đại học São Paulo viết rằng chính cách diễn giải đó đã mang lại sức nặng chính sách cho kết quả này. “Giá chỉ đơn thuần cao là một sản phẩm phụ; giá được bảo vệ bằng sự trả đũa là một cartel.” Câu hỏi của họ rất hẹp: có thực sự tồn tại một cơ chế trừng phạt không?
Tái hiện trước, rồi đóng băng
Các tác giả dựng lại thị trường của Calvano: hai công ty, 15 mức giá khả dĩ, mỗi chương trình là một bảng giá trị (Q-learning dạng bảng) ghi nhớ hai mức giá trước đó — 225 tình huống khả dĩ. Họ huấn luyện 1.024 cặp, mỗi cặp 2 triệu bước. Kết quả được tái hiện: giá ổn định ở chỉ số cấu kết 0,668, trong đó 0 là giá cạnh tranh (Nash) và 1 là giá độc quyền.
Khuôn mẫu nổi tiếng cũng vậy. Buộc một tác tử hạ giá, và ở 1.013 trên 1.024 cặp, giá của đối thủ giảm theo; ở 98,2% số cặp, cả hai quay về mức giá trước đó, thường trong vòng năm kỳ.
Rồi đến bước then chốt: đóng băng các chương trình đã huấn luyện, tắt việc học, và kiểm tra xem chúng thực sự mang theo điều gì.
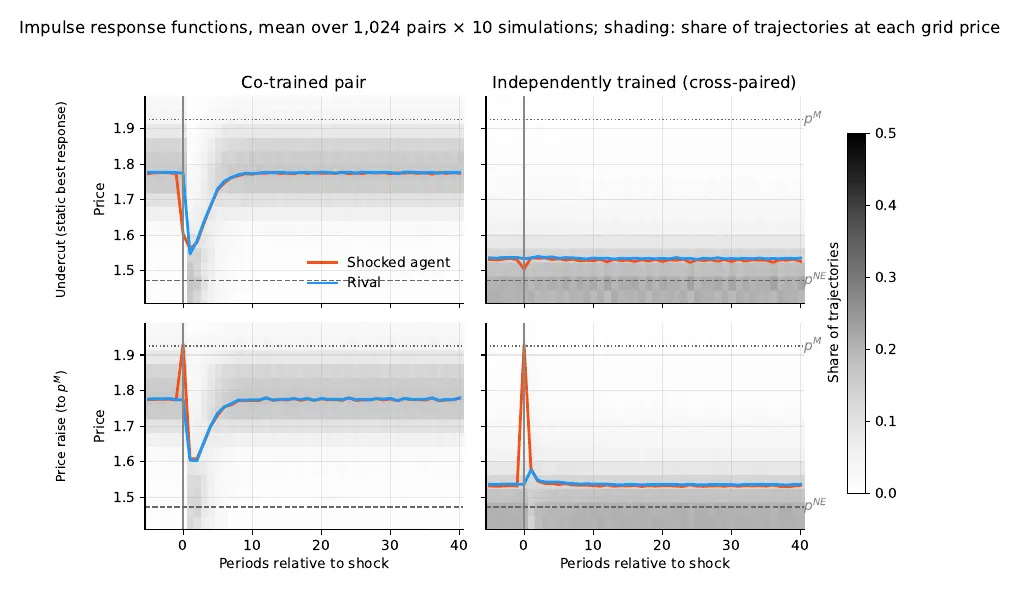
Giá sau một lần giảm giá bắt buộc (trên) hoặc một lần tăng bắt buộc lên giá độc quyền (dưới), với các cặp đã huấn luyện (trái) và với các tác tử được ghép với người lạ (phải). — Figure 3, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
Năm cuộc kiểm toán, không có kẻ trừng phạt
Hướng không quan trọng. Buộc tác tử tăng giá lên mức độc quyền — một bước tiến về phía cartel — và đối thủ vẫn hạ giá rồi phục hồi, ở 960 trên 1.024 cặp. Một phản ứng đối xử với sự hợp tác y hệt như với sự phản bội thì không phải là một quy tắc được thiết kế để răn đe sự phản bội.
Không có mô hình về đối thủ. Cho các tác tử đã huấn luyện đối mặt với một đối thủ được lập trình sẵn thực sự biết trừng phạt — nó hợp tác cho đến khi bị phản bội, rồi chơi giá cạnh tranh mãi mãi. Bắt đầu trong trạng thái hợp tác, 77% tác tử hạ giá với nó trong vòng bốn kỳ và không bao giờ phục hồi.
Không có logic ngoài lối mòn. Đọc như các hàm phản ứng, các bảng đã học hầu như không tuân theo những phản ứng tốt nhất hợp lý (hệ số tương quan hạng trung bình 0,18, dao động từ −0,70 đến 0,84).
Sự quay về là bắt buộc. Ở 914 trên 1.024 cặp, hai chương trình bị đóng băng có một điểm hút duy nhất kéo về mọi trong số 225 tình huống khả dĩ. Chúng quay về mức giá quen thuộc từ bất cứ đâu, sau bất kỳ xáo trộn nào, vì bất kỳ lý do gì — như một quả bóng lăn về đáy bát. Các bảng ngẫu nhiên làm điều này kém hơn nhiều, nên việc huấn luyện có bổ sung tốc độ và vị trí; chỉ là không bổ sung tính chọn lọc.
Đó không phải giới hạn của định dạng. Các tác giả tự tay xây dựng những quy tắc trừng phạt thực sự — một quy tắc biết tha thứ, một quy tắc không bao giờ quên — trong chính bảng 225 × 15 đó. Cả hai đều hoạt động. Năng lực có sẵn đó; việc học đã không dùng đến nó.
Một quy ước của cặp
Tiếp theo là phép thử “người lạ”. Ghép một tác tử với một tác tử từ một lần huấn luyện khác, cùng quy trình, chưa từng gặp: chỉ số cấu kết giảm từ 0,669 xuống 0,134 — sụp đổ 80%, với 7,4% số cặp ghép đặt giá dưới mức cạnh tranh. Ngay cả những cặp đã ổn định ở cùng một mức giá cũng tan rã. “Sự cấu kết trong môi trường này không phải là một chiến lược mà một tác tử sở hữu; nó là một quy ước mà một cặp duy trì.”
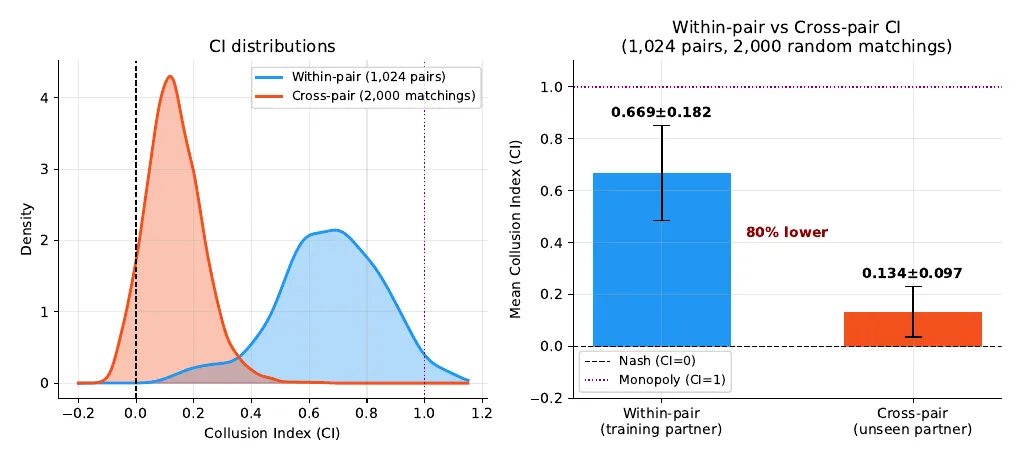
Chỉ số cấu kết với đối tác huấn luyện (xanh lam) và với một đối tác chưa gặp (cam): 0,669 so với 0,134. — Figure 7, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
Cách phá giá không ai thử
Các tác giả có xác nhận phép kiểm tra của chính Calvano: một lần giảm giá trong một kỳ không có lời ở 92% số cặp. Nhưng đó là một cách phá giá ngây thơ. Tính toán chiến lược tốt nhất có thể trước mỗi đối tác bị đóng băng, bằng quy hoạch động chính xác, cho lợi nhuận cao hơn 17,5% trung bình (lên tới 93,7%). Chỉ 124 trong số 2.048 tác tử đã đang chơi phản ứng tốt nhất của mình. “Cơ chế này chỉ răn đe được cách phá giá mà không nhà tối ưu hóa nào chọn.”
Vì sao? Khi việc khám phá giảm dần trong quá trình huấn luyện, mỗi cặp chỉ ghé qua một hành lang hẹp các tình huống. Mọi thứ khác trong bảng gần như không được huấn luyện. Các tác giả gọi kết quả là một cân bằng tự xác nhận (self-confirming equilibrium) — những niềm tin đúng trên con đường đã đi và chưa bao giờ được kiểm chứng ngoài nó. Làm mịn lưới giá từ 15 lên 200 mức, điều trải cùng lượng huấn luyện ra nhiều tình huống hơn, làm chỉ số cấu kết giảm từ 0,64 xuống 0,23, đúng như bức tranh này dự đoán. Với 5 cặp được huấn luyện đúng theo quy tắc dừng của Calvano, mọi kết quả vẫn đứng vững, và cách phá giá có lời thu hẹp còn 10,4%.
Giá vẫn cao, phương thuốc khác
Vấn đề với người tiêu dùng không biến mất: giá vẫn cao hơn hẳn mức cạnh tranh. Điều thay đổi là chẩn đoán. Các tác giả lập luận rằng, khi không có lời đe dọa có điều kiện, những cặp này khó khớp với các phạm trù pháp lý kiểu thỏa thuận — và rằng xáo trộn các cặp ghép (một kẻ mới gia nhập, luân chuyển, huấn luyện lại) sẽ phá hủy sự phối hợp của các chương trình bị đóng băng. Họ cũng đề xuất các phép thử của mình làm tiêu chuẩn trước khi triển khai cho bất kỳ hệ thống định giá nào. Các khẳng định của họ áp dụng cho Q-learning dạng bảng trong đúng thị trường này; liệu các tác tử học sâu có học được những lời đe dọa thực sự hay không là một câu hỏi mà quy trình của họ được xây dựng để trả lời, chứ không phải để giả định.