விலை நிர்ணய அல்காரிதங்கள் கூட்டுச்சதி செய்கின்றன — ஒன்றையொன்று மிரட்டாமலேயே
விலை நிர்ணயம் மேலும் மேலும் கற்கும் அமைப்புகளிடம் ஒப்படைக்கப்படுகிறது. நன்கறியப்பட்ட ஒரு கண்டுபிடிப்பு போட்டி ஆணையங்களைக் கவலைப்படுத்துகிறது: ஒவ்வொன்றும் உருவகப்படுத்தப்பட்ட இரு-நிறுவனச் சந்தையில் தன் சொந்த லாபத்தை அதிகப்படுத்த மட்டுமே பயிற்றுவிக்கப்பட்ட எளிய வலுவூட்டல் கற்றல் (reinforcement learning) நிரல்கள், இறுதியில் போட்டி நிலையைவிட மிக அதிக விலைகளை வசூலிக்கின்றன. American Economic Review-இல் Emilio Calvano-வும் சகாக்களும் வெளியிட்ட 2020-இன் முக்கிய ஆய்வு இன்னும் ஒருபடி மேலே சென்றது. ஒரு நிரலை ஒரு காலகட்டத்துக்கு விலையைக் குறைக்கக் கட்டாயப்படுத்தியபின், போட்டியாளரும் குறைத்ததையும், பிறகு இரண்டும் பழைய விலைகளுக்குத் திரும்பியதையும் கண்டனர். அவர்கள் இதை ஒரு “வெகுமதி–தண்டனைத் திட்டம்” என்று படித்தனர்: என் விலையைக் குறைத்தால் பழிவாங்குவேன், எனவே ஏமாற்றுதல் ஒருபோதும் லாபம் தராது.
அந்த விளக்கமே முடிவுக்குக் கொள்கை எடையைத் தந்தது என்று சாவ் பாவுலோ பல்கலைக்கழகத்தின் Kauê Lopes de Moraes, Rodrigo De Losso எழுதுகின்றனர். “வெறுமனே உயர்ந்த விலைகள் ஒரு செயற்கை விளைவு; பழிவாங்கலால் காக்கப்படும் விலைகள் ஒரு கூட்டுக்கும்பல்.” அவர்களின் கேள்வி குறுகியது: உண்மையில் ஒரு தண்டனை இயங்குமுறை இருக்கிறதா?
முதலில் மீளுருவாக்கு, பிறகு உறைய வை
ஆசிரியர்கள் Calvano-வின் சந்தையை மீண்டும் கட்டினர்: இரண்டு நிறுவனங்கள், 15 சாத்தியமான விலைகள், ஒவ்வொரு நிரலும் முந்தைய இரண்டு விலைகளை நினைவில் கொள்ளும் ஒரு மதிப்பு அட்டவணை (அட்டவணை Q-கற்றல்) — 225 சாத்தியமான நிலைகள். அவர்கள் 1,024 ஜோடிகளை தலா 2 மில்லியன் படிகள் பயிற்றுவித்தனர். முடிவு மீளுருவாகிறது: 0 என்பது போட்டி (Nash) விலை, 1 என்பது ஏகபோக விலை என்ற அளவில், விலைகள் 0.668 என்ற கூட்டுச்சதிக் குறியீட்டில் (collusion index) நிலைகொள்கின்றன.
புகழ்பெற்ற அமைப்பும் அப்படியே. ஒரு முகவரை விலை குறைக்கக் கட்டாயப்படுத்தினால், 1,024-இல் 1,013 ஜோடிகளில் போட்டியாளரின் விலை குறைகிறது; 98.2% ஜோடிகளில் இரண்டும், பொதுவாக ஐந்து காலகட்டங்களுக்குள், முந்தைய விலைகளுக்குத் திரும்புகின்றன.
பிறகு முக்கிய நகர்வு: பயிற்றுவிக்கப்பட்ட நிரல்களை உறைய வைத்து, கற்றலை நிறுத்தி, அவை உண்மையில் எதைச் சுமக்கின்றன என்று சோதிப்பது.
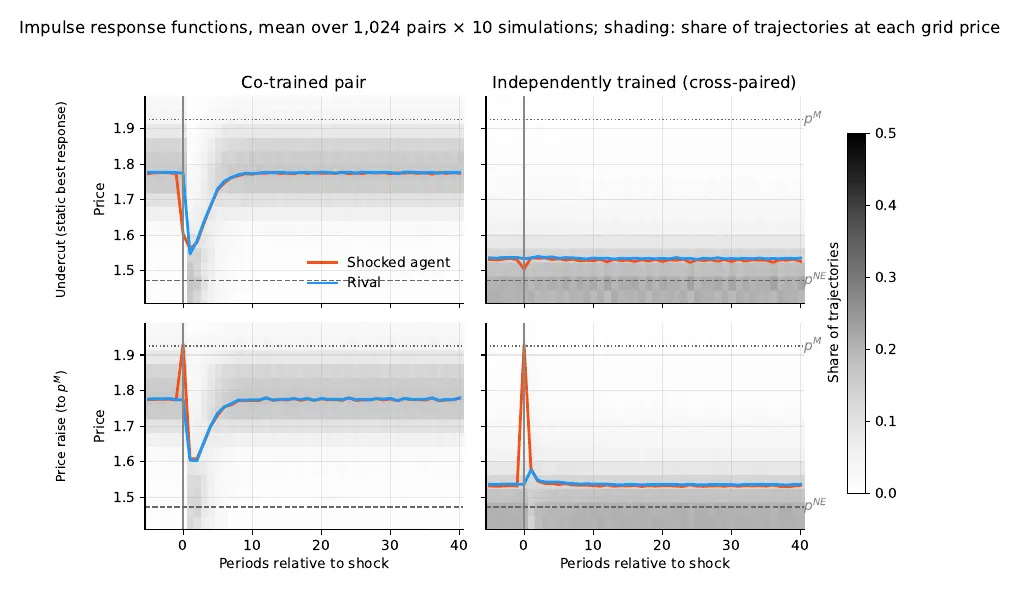
கட்டாய விலைக் குறைப்புக்குப் பின் (மேலே) அல்லது ஏகபோக விலைக்குக் கட்டாய உயர்வுக்குப் பின் (கீழே) விலை; பயிற்றுவிக்கப்பட்ட ஜோடிகளுக்கும் (இடது), அந்நியர்களுடன் இணைக்கப்பட்ட முகவர்களுக்கும் (வலது). — படம் 3, Lopes de Moraes, De Losso (2026), arXiv:2610.21867.
ஐந்து தணிக்கைகள், தண்டிப்பவர் இல்லை
திசை முக்கியமில்லை. முகவரை அதன் விலையை ஏகபோக நிலைக்கு உயர்த்தக் கட்டாயப்படுத்துங்கள் — கூட்டுக்கும்பலை நோக்கிய ஒரு நகர்வு — அப்போதும் போட்டியாளர் விலையைக் குறைத்து, பிறகு மீள்கிறது; 1,024-இல் 960 ஜோடிகளில். ஒத்துழைப்பை துரோகத்தைப் போலவே நடத்தும் ஒரு பதில், துரோகத்தைத் தடுக்க வடிவமைக்கப்பட்ட விதி அல்ல.
எதிராளியைப் பற்றிய மாதிரி இல்லை. உண்மையாகவே தண்டிக்கும், முன்கூட்டியே நிரல்படுத்தப்பட்ட ஒரு போட்டியாளரைப் பயிற்றுவிக்கப்பட்ட முகவர்களுக்கு எதிரே நிறுத்துங்கள் — துரோகம் செய்யப்படும் வரை ஒத்துழைத்து, பிறகு என்றென்றும் போட்டி விலையை விளையாடும் ஒன்று. ஒத்துழைப்பில் தொடங்கினால், 77% முகவர்கள் நான்கு காலகட்டங்களுக்குள் அதன் விலையைவிடக் குறைக்கின்றன, ஒருபோதும் மீள்வதில்லை.
வழக்கமான பாதைக்கு வெளியே தர்க்கம் இல்லை. எதிர்வினைச் சார்புகளாகப் படித்தால், கற்ற அட்டவணைகள் அர்த்தமுள்ள சிறந்த பதில்களை அரிதாகவே பின்பற்றுகின்றன (சராசரி தரவரிசைத் தொடர்பு 0.18; −0.70 முதல் 0.84 வரை).
திரும்புதல் கட்டாயமானது. 1,024-இல் 914 ஜோடிகளில், உறைந்த இரண்டு நிரல்களுக்கும் 225 சாத்தியமான நிலைகள் அனைத்தையும் இழுக்கும் ஒரே ஓர் ஈர்ப்பான் (attractor) உள்ளது. எங்கிருந்தும், எந்த இடையூறுக்குப் பிறகும், எந்தக் காரணத்துக்காகவும் அவை தங்கள் வழக்கமான விலைகளுக்குத் திரும்புகின்றன — ஒரு பந்து கிண்ணத்தின் அடிக்குத் திரும்ப உருள்வதுபோல. தற்செயல் அட்டவணைகள் இதை மிக மோசமாகவே செய்கின்றன; எனவே பயிற்சி வேகத்தையும் இடத்தையும் சேர்க்கிறது — தேர்ந்தெடுப்புத் திறனை அல்ல.
இது வடிவத்தின் வரம்பு அல்ல. ஆசிரியர்கள் அதே 225 × 15 அட்டவணைக்குள் உண்மையான தண்டனை விதிகளைக் கையால் கட்டினர் — ஒன்று மன்னிக்கும், ஒன்று ஒருபோதும் மறக்காது. இரண்டுமே வேலை செய்கின்றன. திறன் இருக்கிறது; கற்றல் அதைப் பயன்படுத்தவில்லை.
ஒரு ஜோடியின் வழக்கம்
அடுத்து, “அந்நியர்” சோதனை. ஒரு முகவரை, அதே நெறிமுறையில் வேறொரு பயிற்சி ஓட்டத்திலிருந்து வந்த, ஒருபோதும் சந்தித்திராத ஒன்றுடன் இணையுங்கள்: கூட்டுச்சதிக் குறியீடு 0.669-இலிருந்து 0.134-க்கு — 80% சரிவு — விழுகிறது; 7.4% இணைப்புகள் போட்டி நிலைக்கும் கீழே விலை வைக்கின்றன. ஒரே விலையில் நிலைகொண்டிருந்த ஜோடிகள்கூடச் சிதறுகின்றன. “இந்தச் சூழலில் கூட்டுச்சதி என்பது ஒரு முகவரிடம் உள்ள உத்தி அல்ல; அது ஒரு ஜோடி கடைப்பிடிக்கும் வழக்கம்.”
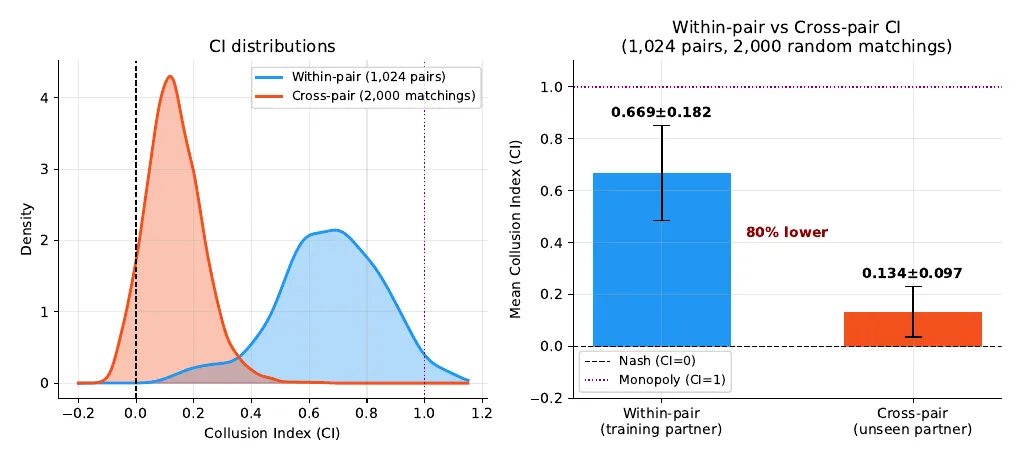
பயிற்சிக் கூட்டாளியுடன் (நீலம்) மற்றும் பார்த்திராத கூட்டாளியுடன் (ஆரஞ்சு) கூட்டுச்சதிக் குறியீடு: 0.669-க்கு எதிராக 0.134. — படம் 7, Lopes de Moraes, De Losso (2026), arXiv:2610.21867.
யாரும் முயலாத விலகல்
ஆசிரியர்கள் Calvano-வின் சொந்தச் சரிபார்ப்பை உறுதிப்படுத்துகின்றனர்: ஒரு காலகட்ட விலைக் குறைப்பு 92% ஜோடிகளில் லாபம் தருவதில்லை. ஆனால் அது ஓர் அப்பாவியான விலகல். உறைந்த ஒவ்வொரு கூட்டாளிக்கும் எதிராக சாத்தியமான சிறந்த உத்தியைத் துல்லியமான இயங்கு நிரலாக்கம் (dynamic programming) மூலம் கணக்கிட்டால், சராசரியாக 17.5% கூடுதல் லாபம் கிடைக்கிறது (93.7% வரை). 2,048 முகவர்களில் 124 மட்டுமே ஏற்கெனவே தங்கள் சிறந்த பதிலை விளையாடுகின்றன. “எந்த உகப்பாக்கியும் தேர்ந்தெடுக்காத விலகலை மட்டுமே இந்தத் திட்டம் தடுக்கிறது.”
ஏன்? பயிற்சியின்போது ஆய்வு (exploration) மங்க மங்க, ஒவ்வொரு ஜோடியும் நிலைகளின் ஒரு குறுகிய தாழ்வாரத்தை மட்டுமே பார்வையிடுகிறது. அட்டவணைகளில் மற்றவை எல்லாம் நடைமுறையில் பயிற்றுவிக்கப்படாமலேயே இருக்கின்றன. ஆசிரியர்கள் இந்த முடிவை சுய-உறுதிப்படுத்தும் சமநிலை (self-confirming equilibrium) என்கின்றனர் — எடுத்த பாதையில் சரியாகவும், அதற்கு வெளியே ஒருபோதும் சோதிக்கப்படாமலும் இருக்கும் நம்பிக்கைகள். அதே பயிற்சியை அதிக நிலைகளில் பரப்பும் விதமாக, விலைக் கட்டத்தை 15-இலிருந்து 200 நிலைகளுக்கு நுணுக்கமாக்கினால், இந்தச் சித்திரம் கணிப்பதுபோலவே கூட்டுச்சதிக் குறியீடு 0.64-இலிருந்து 0.23-க்குக் குறைகிறது. Calvano-வின் நிறுத்த விதிப்படி துல்லியமாகப் பயிற்றுவிக்கப்பட்ட 5 ஜோடிகளிலும் ஒவ்வொரு முடிவும் நிலைக்கிறது; லாபகரமான விலகல் 10.4%-க்குச் சுருங்குகிறது.
விலைகள் இன்னும் உயர்வு, தீர்வு வேறு
நுகர்வோரின் பிரச்சினை மறையவில்லை: விலைகள் போட்டியைவிட மிக உயர்வாகவே உள்ளன. மாறுவது நோயறிதல். நிபந்தனைக்குட்பட்ட மிரட்டல் இல்லாததால் இந்த ஜோடிகள் ஒப்பந்தம் போன்ற சட்டப் பிரிவுகளுக்குச் சரியாகப் பொருந்துவதில்லை என்றும், இணைப்புகளைக் குலைப்பது (புதிய நுழைவு, சுழற்சி, மறுபயிற்சி) உறைந்த நிரல்களின் ஒருங்கிணைப்பை அழிக்கிறது என்றும் ஆசிரியர்கள் வாதிடுகின்றனர். எந்த விலை நிர்ணய அமைப்புக்கும், பயன்பாட்டுக்கு முந்தைய தரநிலையாகத் தங்கள் சோதனைகளையும் முன்வைக்கின்றனர். அவர்களின் கூற்றுகள் இந்த ஒரே சந்தையில் அட்டவணை Q-கற்றலுக்கு மட்டுமே; ஆழ்கற்றல் (deep learning) முகவர்கள் உண்மையான மிரட்டல்களைக் கற்கின்றனவா என்பது, அவர்களின் நெறிமுறை அனுமானிப்பதற்காக அல்ல, பதிலளிப்பதற்காகவே கட்டப்பட்ட கேள்வி.