قیمت طے کرنے والے الگورتھم ملی بھگت کرتے ہیں — ایک دوسرے کو دھمکائے بغیر
قیمتوں کا تعین تیزی سے سیکھنے والے نظاموں کے سپرد کیا جا رہا ہے۔ ایک معروف دریافت مسابقتی حکام کو پریشان کرتی ہے: سادہ تقویتی آموزش (reinforcement learning) والے پروگرام، جن میں سے ہر ایک کو دو کمپنیوں والی ایک فرضی منڈی میں صرف اپنا منافع زیادہ سے زیادہ کرنے کی تربیت دی گئی ہو، آخرکار مسابقتی سطح سے کافی زیادہ قیمتیں وصول کرنے لگتے ہیں۔ American Economic Review میں ایمیلیو کالوانو اور ساتھیوں کا 2020 کا ایک سنگِ میل مطالعہ اس سے آگے گیا۔ ایک پروگرام کو ایک مدت کے لیے قیمت گھٹانے پر مجبور کرنے کے بعد انہوں نے دیکھا کہ حریف نے بھی قیمت گھٹائی، اور پھر دونوں اپنی پرانی قیمتوں پر لوٹ آئے۔ انہوں نے اسے “انعام–سزا کا نظام” سمجھا: میری قیمت سے نیچے گئے تو میں جوابی کارروائی کروں گا، اس لیے دھوکا کبھی فائدہ نہیں دیتا۔
ساؤ پاؤلو یونیورسٹی کے کاؤئے لوپیز دے موراییس اور رودریگو دے لوسو لکھتے ہیں کہ اسی تشریح نے اس نتیجے کو پالیسی کے لحاظ سے وزن دیا۔ “محض بلند قیمتیں ایک مصنوعی نتیجہ ہیں؛ جوابی کارروائی سے بچائی گئی قیمتیں ایک کارٹیل ہیں۔” ان کا سوال محدود ہے: کیا واقعی سزا کا کوئی نظام موجود ہے؟
پہلے نقل، پھر منجمد
مصنفین نے کالوانو کی منڈی دوبارہ بنائی: دو کمپنیاں، 15 ممکنہ قیمتیں، ہر پروگرام قدروں کی ایک جدول (جدولی Q-learning) جو پچھلی دو قیمتیں یاد رکھتی ہے — یعنی 225 ممکنہ حالتیں۔ انہوں نے 1,024 جوڑوں کو تربیت دی، ہر ایک کو 20 لاکھ قدم۔ نتیجہ دہرایا جاتا ہے: قیمتیں 0.668 کے ملی بھگت اشاریے پر ٹھہر جاتی ہیں، جہاں 0 مسابقتی (نیش) قیمت ہے اور 1 اجارہ داری کی قیمت۔
مشہور نمونہ بھی دہرایا جاتا ہے۔ ایک ایجنٹ کو قیمت گھٹانے پر مجبور کریں تو 1,024 میں سے 1,013 جوڑوں میں حریف کی قیمت گر جاتی ہے؛ 98.2% جوڑوں میں دونوں اپنی پچھلی قیمتوں پر لوٹ آتے ہیں، عموماً پانچ مدتوں کے اندر۔
پھر کلیدی قدم: تربیت یافتہ پروگراموں کو منجمد کریں، سیکھنا بند کر دیں، اور جانچیں کہ ان میں درحقیقت کیا موجود ہے۔
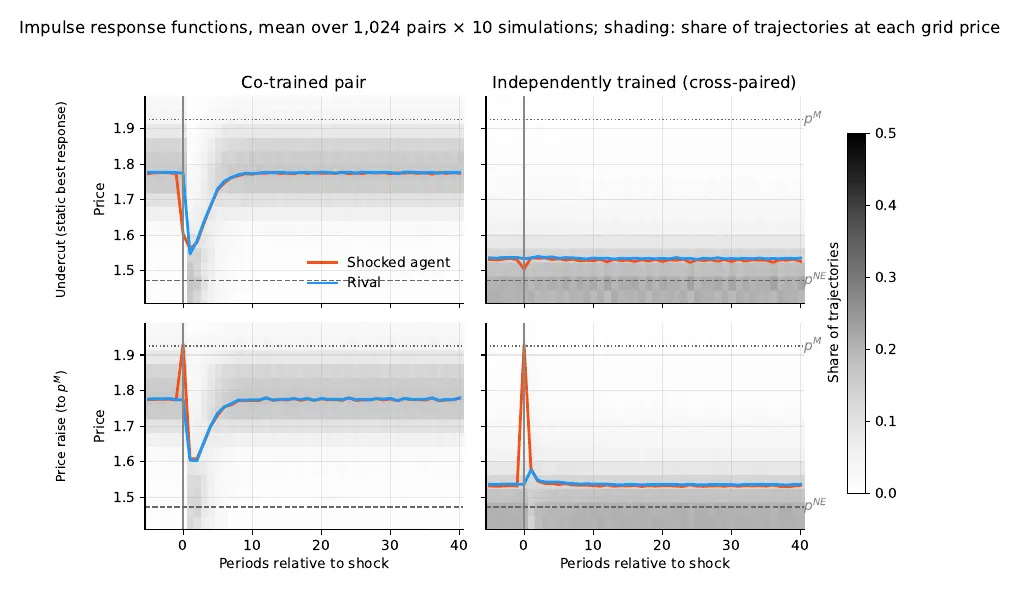
جبری کمی (اوپر) یا اجارہ داری کی قیمت تک جبری اضافے (نیچے) کے بعد قیمت، تربیت یافتہ جوڑوں (بائیں) اور اجنبیوں کے ساتھ جوڑے گئے ایجنٹوں (دائیں) کے لیے۔ — شکل 3، Lopes de Moraes and De Losso (2026)، arXiv:2610.21867۔
پانچ جانچیں، کوئی سزا دینے والا نہیں
سمت سے فرق نہیں پڑتا۔ ایجنٹ کو اپنی قیمت اجارہ داری کی سطح تک بڑھانے پر مجبور کریں — یعنی کارٹیل کی طرف ایک قدم — تب بھی 1,024 میں سے 960 جوڑوں میں حریف اپنی قیمت گراتا ہے اور پھر بحال ہوتا ہے۔ جو ردِعمل تعاون کو بالکل غداری جیسا سمجھے، وہ غداری روکنے کے لیے بنایا گیا اصول نہیں ہو سکتا۔
مخالف کا کوئی تصور نہیں۔ تربیت یافتہ ایجنٹوں کا سامنا ایک طے شدہ اسکرپٹ والے حریف سے کرائیں جو واقعی سزا دیتا ہے — وہ دھوکا ملنے تک تعاون کرتا ہے، پھر ہمیشہ کے لیے مسابقتی قیمت پر کھیلتا ہے۔ تعاون کی حالت سے شروع کرنے پر 77% ایجنٹ چار مدتوں کے اندر اس سے کم قیمت رکھ دیتے ہیں اور کبھی بحال نہیں ہوتے۔
معمول کے راستے سے ہٹ کر کوئی منطق نہیں۔ ردِعمل کے تفاعل کے طور پر پڑھی جائیں تو سیکھی گئی جدولیں معقول بہترین جوابات کی بمشکل پیروی کرتی ہیں (اوسط درجہ بندی ہم ربطی 0.18، جو −0.70 سے 0.84 تک ہے)۔
واپسی جبری ہے۔ 1,024 میں سے 914 جوڑوں میں دونوں منجمد پروگراموں کا ایک ہی کشش کا مرکز (attractor) ہے جو تمام 225 ممکنہ حالتوں کو اپنی طرف کھینچتا ہے۔ وہ کہیں سے بھی، کسی بھی خلل کے بعد، کسی بھی وجہ سے اپنی معمول کی قیمتوں پر لوٹ آتے ہیں — جیسے ایک گیند پیالے کی تہہ میں واپس لڑھک آتی ہے۔ بے ترتیب جدولیں یہ کام کہیں بدتر کرتی ہیں، لہٰذا تربیت رفتار اور درست مقام ضرور دیتی ہے؛ بس انتخاب کی صلاحیت نہیں دیتی۔
یہ ساخت کی حد نہیں۔ مصنفین نے ہاتھ سے حقیقی سزا کے اصول بنائے — ایک جو معاف کر دیتا ہے، ایک جو کبھی نہیں بھولتا — بالکل اسی 225 × 15 جدول میں۔ دونوں کام کرتے ہیں۔ صلاحیت موجود ہے؛ سیکھنے کے عمل نے اسے استعمال نہیں کیا۔
جوڑے کا ایک رواج
اس کے بعد “اجنبی” کا امتحان۔ کسی ایجنٹ کو ایک الگ تربیتی دور کے ایجنٹ کے ساتھ جوڑیں، طریقۂ کار وہی، مگر جو کبھی ملے نہ ہوں: ملی بھگت کا اشاریہ 0.669 سے گر کر 0.134 ہو جاتا ہے — 80% کی تباہی، اور 7.4% جوڑ مسابقتی سطح سے بھی کم قیمت رکھتے ہیں۔ وہ جوڑے بھی بکھر جاتے ہیں جو ایک ہی قیمت پر ٹھہرے تھے۔ “اس ماحول میں ملی بھگت کوئی حکمت عملی نہیں جو کسی ایجنٹ کے پاس ہو؛ یہ ایک رواج ہے جسے ایک جوڑا نبھاتا ہے۔”
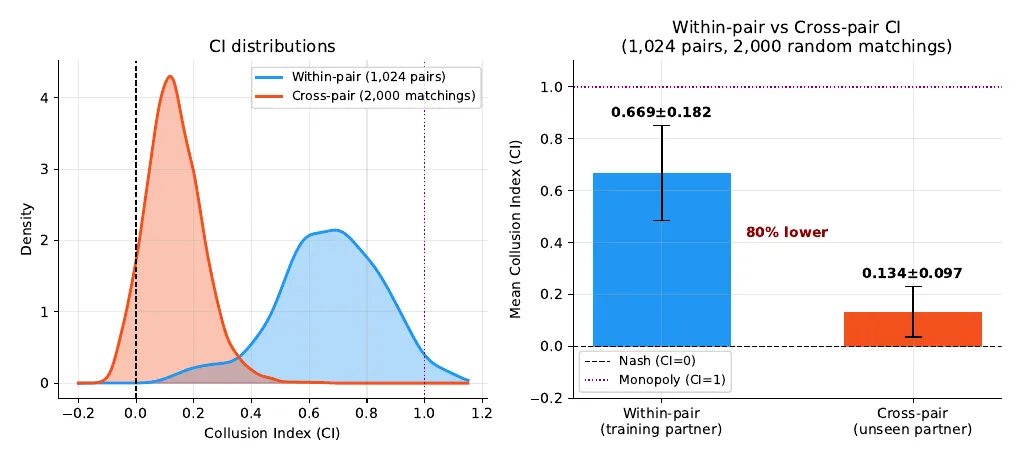
تربیتی ساتھی (نیلا) اور ایک انجان ساتھی (نارنجی) کے ساتھ ملی بھگت کا اشاریہ: 0.669 بمقابلہ 0.134۔ — شکل 7، Lopes de Moraes and De Losso (2026)، arXiv:2610.21867۔
وہ انحراف جسے کوئی نہیں آزماتا
مصنفین کالوانو کی اپنی جانچ کی تصدیق ضرور کرتے ہیں: ایک مدت کے لیے قیمت گھٹانا 92% جوڑوں میں فائدہ نہیں دیتا۔ لیکن یہ ایک سادہ لوح انحراف ہے۔ ہر منجمد ساتھی کے خلاف عین متحرک پروگرامنگ (dynamic programming) کے ذریعے بہترین ممکنہ حکمت عملی نکالیں تو اوسطاً 17.5% زیادہ منافع ملتا ہے (93.7% تک)۔ 2,048 ایجنٹوں میں سے صرف 124 پہلے ہی اپنا بہترین جواب کھیل رہے ہیں۔ “یہ نظام صرف اسی انحراف کو روکتا ہے جسے کوئی بہتری تلاش کرنے والا کبھی نہ چنے۔”
کیوں؟ تربیت کے دوران جیسے جیسے کھوج کم ہوتی ہے، ہر جوڑا حالتوں کی صرف ایک تنگ راہداری میں آتا جاتا ہے۔ جدولوں کا باقی سب کچھ عملاً تربیت کے بغیر رہ جاتا ہے۔ مصنفین اس نتیجے کو خود تصدیقی توازن (self-confirming equilibrium) کہتے ہیں — ایسے عقائد جو طے کیے گئے راستے پر درست ہیں اور اس سے باہر کبھی جانچے نہیں جاتے۔ قیمتوں کی جالی کو 15 سے 200 سطحوں تک باریک کرنے سے، جو اسی تربیت کو زیادہ حالتوں پر پھیلا دیتا ہے، ملی بھگت کا اشاریہ 0.64 سے 0.23 تک گر جاتا ہے، جیسا کہ یہ تصویر پیش گوئی کرتی ہے۔ کالوانو کے رکنے کے اصول کے عین مطابق تربیت یافتہ 5 جوڑوں کے ساتھ تمام نتائج برقرار رہتے ہیں، اور منافع بخش انحراف گھٹ کر 10.4% رہ جاتا ہے۔
قیمتیں اب بھی بلند، علاج مختلف
صارف کا مسئلہ ختم نہیں ہوتا: قیمتیں مسابقت سے کافی اوپر رہتی ہیں۔ جو بدلتا ہے وہ تشخیص ہے۔ مصنفین کا استدلال ہے کہ کسی مشروط دھمکی کے بغیر یہ جوڑے معاہدے جیسی قانونی اصطلاحات میں ٹھیک نہیں بیٹھتے — اور یہ کہ جوڑوں کو چھیڑنا (کوئی نیا داخل ہونے والا، باری بدلنا، دوبارہ تربیت) منجمد پروگراموں کی ہم آہنگی کو تباہ کر دیتا ہے۔ وہ اپنے امتحانات کو قیمت طے کرنے والے کسی بھی نظام کے لیے استعمال میں لانے سے پہلے کے معیار کے طور پر بھی پیش کرتے ہیں۔ ان کے دعوے اسی ایک منڈی میں جدولی Q-learning تک محدود ہیں؛ کیا ڈیپ لرننگ والے ایجنٹ حقیقی دھمکیاں سیکھتے ہیں، یہ ایسا سوال ہے جس کا جواب دینے کے لیے ان کا طریقۂ کار بنایا گیا ہے، اسے فرض کرنے کے لیے نہیں۔