定价算法会合谋——却并不相互威胁
定价工作正越来越多地交给学习系统。一个著名的发现令竞争主管机构忧心:简单的强化学习程序,每个只被训练去最大化自身在一个模拟双寡头市场中的利润,最终定出的价格却远高于竞争水平。埃米利奥·卡尔瓦诺(Emilio Calvano)及其同事2020年发表在《美国经济评论》上的一项里程碑式研究更进一步。他们强迫一个程序在一个周期内降价后,看到对手也随之降价,然后两者都回到原来的价格。他们把这解读为一种**“奖励–惩罚机制”**:你压价,我就报复,所以作弊永远不划算。
圣保罗大学的Kauê Lopes de Moraes和Rodrigo De Losso写道,正是这种解读赋予了该结果政策上的分量。“仅仅是高价,只是一种人为现象;靠报复来维持的高价,才是卡特尔。”他们的问题范围很窄:真的存在惩罚机制吗?
先复现,再冻结
作者重建了卡尔瓦诺的市场:两家企业,15个可选价格,每个程序都是一张价值表(表格型Q学习),能记住前两个价格——共225种可能的情形。他们训练了1,024对程序,每对200万步。结果得以复现:价格稳定在合谋指数0.668,其中0代表竞争(纳什)价格,1代表垄断价格。
那个著名的模式也复现了。强迫一个智能体压价,在1,024对中有1,013对的对手随之降价;98.2%的配对中,两者都会回到之前的价格,通常在五个周期之内。
然后是关键一步:冻结训练好的程序,关闭学习,检验它们实际掌握了什么。
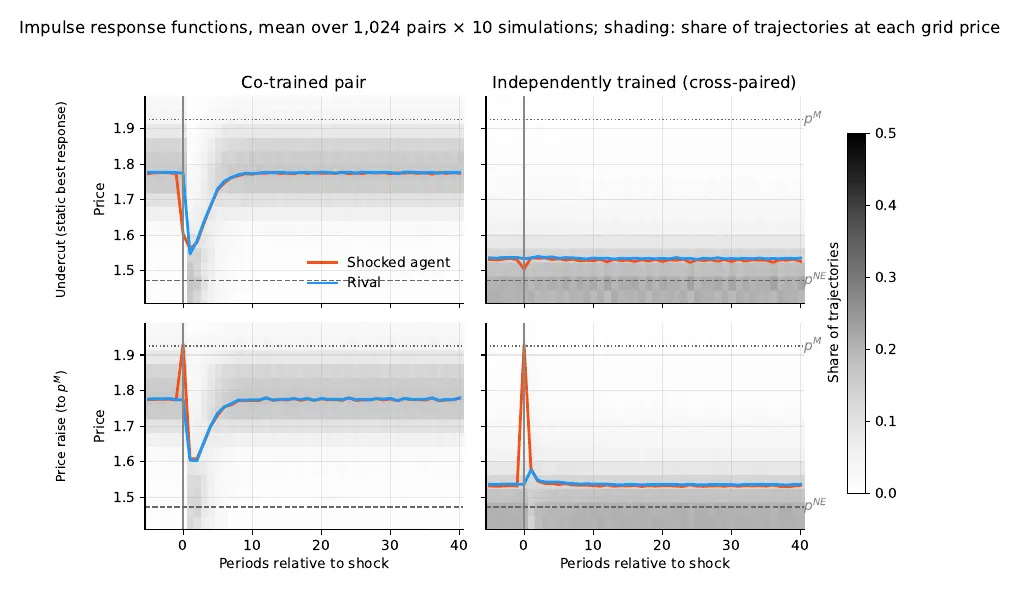
强制降价后(上)或强制涨到垄断价格后(下)的价格,分别对应训练配对(左)和与陌生对手配对的智能体(右)。——图3,Lopes de Moraes和De Losso(2026),arXiv:2610.21867。
五项审查,没有惩罚者
方向无关紧要。 强迫智能体把价格提高到垄断水平——这是向卡特尔靠拢的一步——在1,024对中的960对里,对手依然先降价再恢复。一种把合作和背叛完全同等对待的反应,并不是为了威慑背叛而设计的规则。
没有对手模型。 让训练好的智能体面对一个真正会惩罚的脚本化对手——它一直合作,直到被冒犯,然后永远采用竞争价格。从合作状态开始,**77%**的智能体在四个周期内就会压价,并且再也恢复不过来。
偏离常规路径就没有逻辑。 把学到的价值表解读为反应函数,它们几乎不遵循合理的最优反应(平均秩相关系数为0.18,范围从−0.70到0.84)。
回归是被迫的。 在1,024对中的914对里,两个冻结的程序只有一个吸引子,它把全部225种可能的情形都吸引过去。无论从哪里出发、遭遇何种扰动、出于何种原因,它们都会回到惯常的价格——就像一个球滚回碗底。随机生成的价值表在这方面差得多,所以训练确实增加了回归的速度并确定了回归的位置,只是没有带来选择性。
这不是表格形式的局限。 作者在完全相同的225 × 15表格中手工构建了真正的惩罚规则——一种会原谅,一种永不忘记。两者都有效。能力是存在的,只是学习没有用上它。
配对双方的惯例
接下来是“陌生人”检验。让一个智能体与另一次训练中得到的智能体配对,训练协议相同,但从未相遇过:合谋指数从0.669降到0.134——暴跌80%,有7.4%的配对定价甚至低于竞争水平。即便是原本稳定在同一价格的配对也会瓦解。“在这种环境中,合谋不是某个智能体拥有的策略,而是一对智能体维持的惯例。”
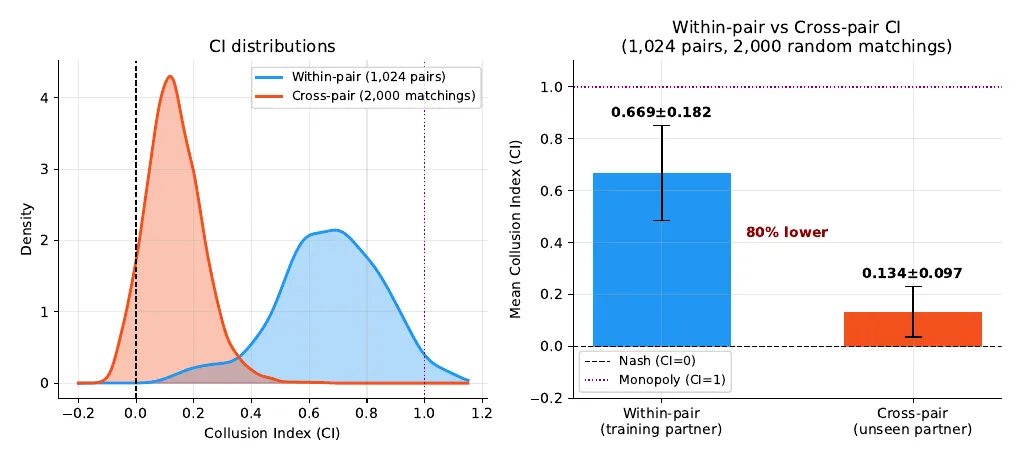
与训练伙伴(蓝色)和与未见过的伙伴(橙色)配对时的合谋指数:0.669对0.134。——图7,Lopes de Moraes和De Losso(2026),arXiv:2610.21867。
没人尝试的偏离
作者确实证实了卡尔瓦诺本人的检验:在92%的配对中,一个周期的降价并不划算。但那是一种幼稚的偏离。用精确的动态规划计算出针对每个冻结伙伴的最优策略,平均能多获得17.5%的利润(最高可达93.7%)。在2,048个智能体中,只有124个已经在采用自己的最优反应。“这一机制所威慑的,只是任何优化者都不会选择的那种偏离。”
为什么?随着训练过程中探索逐渐减少,每一对智能体只会访问一条狭窄的情形“走廊”。价值表中的其他一切几乎都没有得到训练。作者把这种结果称为自我确认均衡——在所走路径上正确、却从未在路径之外接受检验的信念。把价格网格从15级细化到200级,相当于把同样的训练分散到更多情形上,合谋指数便从0.64降到0.23,正如这幅图景所预测的。用5对严格按照卡尔瓦诺停止规则训练的智能体进行检验,所有结果依然成立,有利可图的偏离收益缩小到10.4%。
价格依旧偏高,药方却不同
消费者面临的问题并没有消失:价格仍远高于竞争水平。改变的是诊断。作者认为,由于不存在附条件的威胁,这些配对很难归入类似协议的法律范畴——而打乱配对(新进入者、轮换、重新训练)就能破坏冻结程序之间的协调。他们还提出,可以把这些检验作为任何定价系统部署前的标准。他们的结论只涵盖这一个市场中的表格型Q学习;深度学习智能体是否会学会真正的威胁,是他们的检验协议旨在回答、而非预设的问题。