ALGORITMA PENETAP HARGA BERKOLUSI — TANPA SALING MENGANCAM
Penetapan harga makin sering diserahkan kepada sistem pembelajar. Sebuah temuan terkenal mencemaskan otoritas persaingan usaha: program pembelajaran penguatan (reinforcement learning) sederhana, yang masing-masing hanya dilatih untuk memaksimalkan labanya sendiri di pasar simulasi dengan dua perusahaan, akhirnya memasang harga jauh di atas tingkat persaingan. Sebuah studi penting tahun 2020 oleh Emilio Calvano dan rekan-rekannya di American Economic Review melangkah lebih jauh. Setelah memaksa satu program menurunkan harganya selama satu periode, mereka melihat pesaingnya ikut menurunkan harga, lalu keduanya kembali ke harga semula. Mereka menafsirkannya sebagai “skema hadiah–hukuman”: banting hargaku dan aku membalas, sehingga curang tidak pernah menguntungkan.
Tafsiran itu, tulis Kauê Lopes de Moraes dan Rodrigo De Losso dari Universitas São Paulo, yang memberi hasil tersebut bobot kebijakan. “Harga yang sekadar tinggi adalah artefak; harga yang dipertahankan dengan pembalasan adalah kartel.” Pertanyaan mereka sempit: apakah memang ada mekanisme hukuman?
Mereplikasi dulu, lalu membekukan
Para penulis membangun ulang pasar Calvano: dua perusahaan, 15 kemungkinan harga, setiap program berupa tabel nilai (Q-learning tabular) yang mengingat dua harga sebelumnya — 225 kemungkinan situasi. Mereka melatih 1.024 pasangan, masing-masing 2 juta langkah. Hasilnya tereplikasi: harga mengendap pada indeks kolusi 0,668, dengan 0 sebagai harga persaingan (Nash) dan 1 sebagai harga monopoli.
Pola yang terkenal itu pun tereplikasi. Paksa satu agen membanting harga, dan pada 1.013 dari 1.024 pasangan harga pesaingnya turun; pada 98,2% pasangan, keduanya kembali ke harga sebelumnya, biasanya dalam lima periode.
Lalu langkah kuncinya: bekukan program yang sudah terlatih, matikan pembelajarannya, dan uji apa yang sebenarnya mereka bawa.
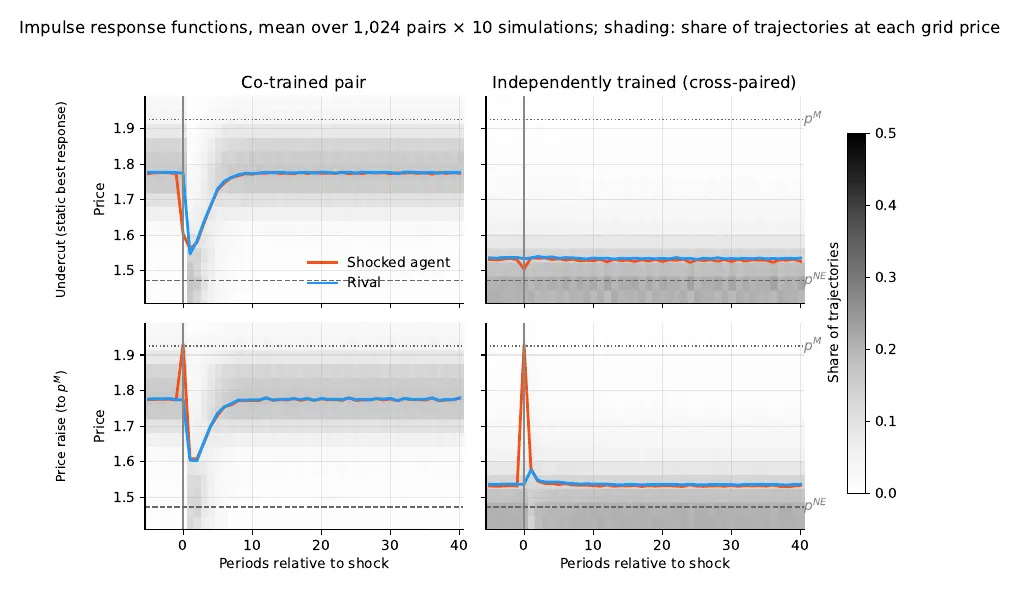
Harga setelah penurunan paksa (atas) atau kenaikan paksa ke harga monopoli (bawah), untuk pasangan terlatih (kiri) dan untuk agen yang dipasangkan dengan agen asing (kanan). — Gambar 3, Lopes de Moraes dan De Losso (2026), arXiv:2610.21867.
Lima audit, tanpa penghukum
Arah tidak berpengaruh. Paksa agen untuk menaikkan harganya ke tingkat monopoli — langkah menuju kartel — dan pesaingnya tetap menurunkan harga lalu pulih, pada 960 dari 1.024 pasangan. Respons yang memperlakukan kerja sama persis seperti pengkhianatan bukanlah aturan yang dirancang untuk mencegah pengkhianatan.
Tidak ada model tentang lawan. Hadapkan agen terlatih dengan pesaing berskrip yang benar-benar menghukum — ia bekerja sama sampai dikhianati, lalu memasang harga persaingan selamanya. Dimulai dalam keadaan bekerja sama, 77% agen membanting harga melawannya dalam empat periode dan tidak pernah pulih.
Tidak ada logika di luar jalur biasa. Jika dibaca sebagai fungsi reaksi, tabel hasil pembelajaran nyaris tidak mengikuti respons terbaik yang masuk akal (korelasi peringkat rata-rata 0,18, berkisar dari −0,70 hingga 0,84).
Kepulangannya dipaksakan. Pada 914 dari 1.024 pasangan, kedua program beku memiliki satu atraktor tunggal yang menarik seluruh 225 kemungkinan situasi. Keduanya kembali ke harga biasa dari mana saja, setelah gangguan apa pun, dengan alasan apa pun — seperti bola yang menggelinding kembali ke dasar mangkuk. Tabel acak melakukannya jauh lebih buruk, jadi pelatihan memang menambah kecepatan dan ketepatan posisi; hanya saja tidak menambah selektivitas.
Ini bukan keterbatasan format. Para penulis merakit sendiri aturan hukuman yang sesungguhnya — satu yang memaafkan, satu yang tak pernah lupa — di dalam tabel 225 × 15 yang persis sama. Keduanya berfungsi. Kapasitasnya ada; pembelajaran tidak memakainya.
Sebuah konvensi milik pasangan
Berikutnya, uji “agen asing”. Pasangkan sebuah agen dengan agen dari putaran pelatihan lain, dengan protokol sama, yang belum pernah bertemu: indeks kolusi turun dari 0,669 menjadi 0,134 — runtuh 80%, dengan 7,4% pasangan menetapkan harga di bawah tingkat persaingan. Bahkan pasangan yang sudah mengendap di harga yang sama pun buyar. “Kolusi di lingkungan ini bukanlah strategi yang dimiliki agen; melainkan konvensi yang dijaga sepasang agen.”
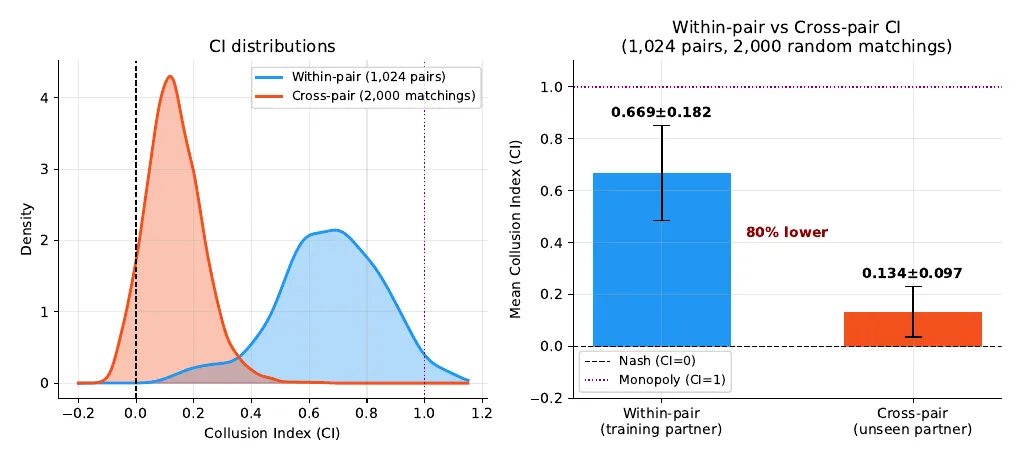
Indeks kolusi dengan mitra pelatihan (biru) dan dengan mitra yang belum pernah ditemui (oranye): 0,669 berbanding 0,134. — Gambar 7, Lopes de Moraes dan De Losso (2026), arXiv:2610.21867.
Penyimpangan yang tak pernah dicoba
Para penulis memang mengonfirmasi pemeriksaan Calvano sendiri: penurunan harga selama satu periode tidak menguntungkan pada 92% pasangan. Namun itu penyimpangan yang naif. Menghitung strategi terbaik yang mungkin terhadap setiap mitra yang dibekukan, dengan pemrograman dinamis eksak, menghasilkan rata-rata laba 17,5% lebih besar (hingga 93,7%). Hanya 124 dari 2.048 agen yang sudah memainkan respons terbaiknya. “Skema itu hanya mencegah penyimpangan yang tidak akan dipilih oleh pengoptimal mana pun.”
Mengapa? Ketika eksplorasi memudar selama pelatihan, setiap pasangan hanya mengunjungi koridor situasi yang sempit. Selebihnya dalam tabel praktis tidak terlatih. Para penulis menyebut hasilnya kesetimbangan yang mengonfirmasi diri (self-confirming equilibrium) — keyakinan yang benar di jalur yang dilalui dan tak pernah diuji di luarnya. Memperhalus grid harga dari 15 menjadi 200 tingkat, yang menyebarkan pelatihan yang sama ke lebih banyak situasi, menurunkan indeks kolusi dari 0,64 menjadi 0,23, sesuai prediksi gambaran ini. Dengan 5 pasangan yang dilatih persis sesuai aturan penghentian Calvano, semua hasil tetap berlaku, dengan penyimpangan yang menguntungkan menyusut menjadi 10,4%.
Harga tetap tinggi, obatnya berbeda
Masalah bagi konsumen tidak hilang: harga tetap jauh di atas tingkat persaingan. Yang berubah adalah diagnosisnya. Para penulis berargumen bahwa, tanpa ancaman bersyarat, pasangan-pasangan ini kurang cocok dengan kategori hukum yang menyerupai kesepakatan — dan bahwa mengganggu pemasangan (pendatang baru, rotasi, pelatihan ulang) menghancurkan koordinasi program-program beku itu. Mereka juga menawarkan uji mereka sebagai standar pra-penerapan bagi sistem penetapan harga apa pun. Klaim mereka mencakup Q-learning tabular di satu pasar ini; apakah agen pembelajaran mendalam mempelajari ancaman yang sesungguhnya adalah pertanyaan yang memang hendak dijawab oleh protokol mereka, bukan diandaikan.