PREISALGORITHMEN SPRECHEN SICH AB – OHNE EINANDER ZU DROHEN
Die Preisgestaltung wird zunehmend lernenden Systemen überlassen. Ein bekannter Befund beunruhigt Wettbewerbsbehörden: Einfache Programme des bestärkenden Lernens (Reinforcement Learning), von denen jedes nur darauf trainiert ist, den eigenen Gewinn in einem simulierten Markt mit zwei Firmen zu maximieren, verlangen am Ende Preise deutlich über dem Wettbewerbsniveau. Eine wegweisende Studie von Emilio Calvano und Kollegen aus dem Jahr 2020 in der American Economic Review ging weiter. Nachdem sie ein Programm gezwungen hatten, seinen Preis für eine Periode zu senken, sahen sie, wie auch der Rivale senkte und beide danach zu ihren alten Preisen zurückkehrten. Sie deuteten das als „Belohnungs-Bestrafungs-Schema“: Unterbiete mich, und ich vergelte es, sodass sich Betrug nie lohnt.
Diese Lesart, schreiben Kauê Lopes de Moraes und Rodrigo De Losso von der Universität São Paulo, verlieh dem Ergebnis sein politisches Gewicht. „Preise, die bloß hoch sind, sind ein Artefakt; Preise, die durch Vergeltung verteidigt werden, sind ein Kartell.“ Ihre Frage ist eng gefasst: Gibt es tatsächlich einen Bestrafungsmechanismus?
Erst nachbauen, dann einfrieren
Die Autoren bauten Calvanos Markt nach: zwei Firmen, 15 mögliche Preise, jedes Programm eine Wertetabelle (tabellarisches Q-Learning), die sich an die beiden vorherigen Preise erinnert – 225 mögliche Situationen. Sie trainierten 1.024 Paare mit je 2 Millionen Schritten. Das Ergebnis lässt sich reproduzieren: Die Preise pendeln sich bei einem Kollusionsindex von 0,668 ein, wobei 0 der Wettbewerbspreis (Nash) und 1 der Monopolpreis ist.
Ebenso das berühmte Muster. Zwingt man einen Agenten zum Unterbieten, sinkt in 1.013 von 1.024 Paaren der Preis des Rivalen; in 98,2 % der Paare kehren beide zu ihren vorherigen Preisen zurück, meist innerhalb von fünf Perioden.
Dann der entscheidende Schritt: die trainierten Programme einfrieren, das Lernen abschalten und testen, was sie tatsächlich in sich tragen.
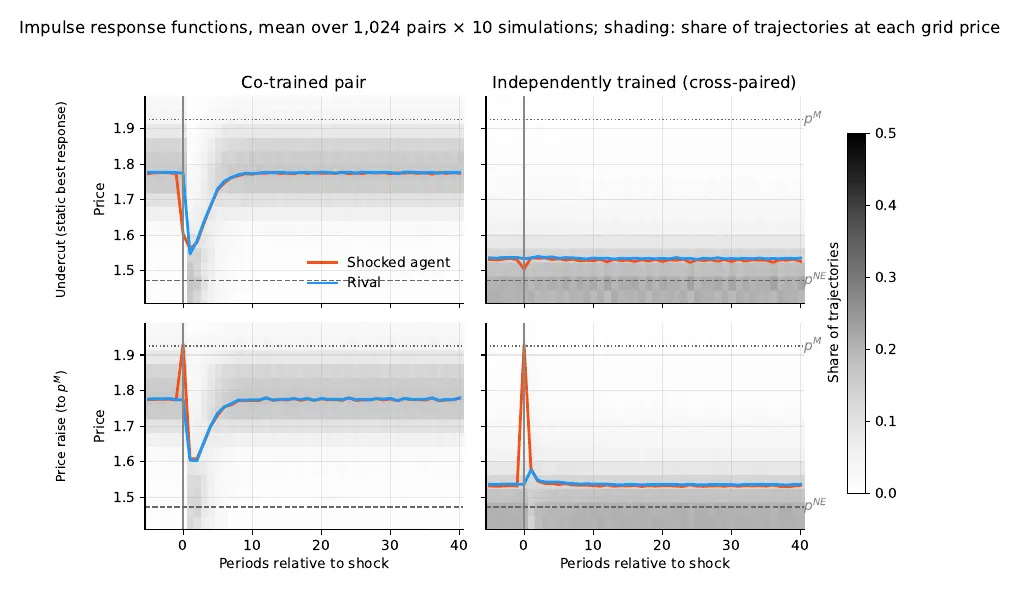
Preis nach einer erzwungenen Senkung (oben) oder einer erzwungenen Anhebung auf den Monopolpreis (unten), für trainierte Paare (links) und für Agenten, die mit Fremden zusammengebracht wurden (rechts). — Abbildung 3, Lopes de Moraes und De Losso (2026), arXiv:2610.21867.
Fünf Prüfungen, kein Bestrafer
Die Richtung spielt keine Rolle. Zwingt man den Agenten, seinen Preis auf Monopolniveau anzuheben – ein Schritt in Richtung Kartell –, senkt der Rivale in 960 von 1.024 Paaren trotzdem seinen Preis und erholt sich dann. Eine Reaktion, die Kooperation genau wie Verrat behandelt, ist keine Regel, die Verrat abschrecken soll.
Kein Modell des Gegners. Konfrontiert man die trainierten Agenten mit einem geskripteten Rivalen, der wirklich bestraft – er kooperiert, bis er hintergangen wird, und spielt dann für immer den Wettbewerbspreis –, unterbieten ihn 77 % der Agenten aus der Kooperation heraus innerhalb von vier Perioden und erholen sich nie wieder.
Keine Logik abseits der ausgetretenen Pfade. Als Reaktionsfunktionen gelesen, folgen die gelernten Tabellen sinnvollen besten Antworten kaum (mittlere Rangkorrelation 0,18, Spanne von −0,70 bis 0,84).
Die Rückkehr ist erzwungen. In 914 von 1.024 Paaren besitzen die beiden eingefrorenen Programme einen einzigen Attraktor, der alle 225 möglichen Situationen anzieht. Sie kehren von überall, nach jeder Störung, aus jedem Grund zu ihren gewohnten Preisen zurück – so wie eine Kugel zurück auf den Boden einer Schüssel rollt. Zufällige Tabellen schaffen das viel schlechter; das Training bringt also durchaus Tempo und Lage – nur keine Selektivität.
Es liegt nicht am Format. Die Autoren bauten von Hand echte Bestrafungsregeln – eine, die vergibt, und eine, die nie vergisst – in genau derselben 225 × 15-Tabelle. Beide funktionieren. Die Fähigkeit ist vorhanden; das Lernen hat sie nicht genutzt.
Eine Konvention des Paares
Als Nächstes der „Fremden“-Test. Bringt man einen Agenten mit einem aus einem anderen Trainingslauf zusammen – gleiches Protokoll, nie zuvor begegnet –, fällt der Kollusionsindex von 0,669 auf 0,134 – ein Einbruch um 80 %, wobei 7,4 % der Paarungen sogar unter dem Wettbewerbsniveau liegen. Selbst Paare, die sich auf denselben Preis eingependelt hatten, zerfallen. „Kollusion ist in dieser Umgebung keine Strategie, die ein Agent hat; sie ist eine Konvention, die ein Paar pflegt.“
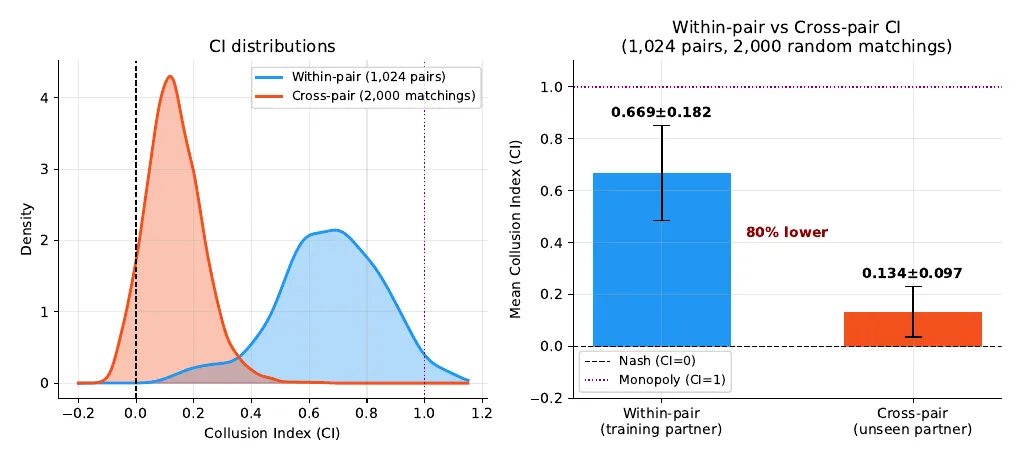
Kollusionsindex mit dem Trainingspartner (blau) und mit einem unbekannten Partner (orange): 0,669 gegenüber 0,134. — Abbildung 7, Lopes de Moraes und De Losso (2026), arXiv:2610.21867.
Die Abweichung, die niemand versucht
Die Autoren bestätigen durchaus Calvanos eigene Prüfung: Eine Preissenkung für eine Periode lohnt sich in 92 % der Paare nicht. Doch das ist eine naive Abweichung. Berechnet man per exakter dynamischer Programmierung die bestmögliche Strategie gegen jeden eingefrorenen Partner, ergibt sich im Schnitt 17,5 % mehr Gewinn (bis zu 93,7 %). Nur 124 von 2.048 Agenten spielen bereits ihre beste Antwort. „Das Schema schreckt nur die Abweichung ab, die kein Optimierer wählen würde.“
Warum? Während die Exploration im Training nachlässt, besucht jedes Paar nur einen schmalen Korridor von Situationen. Alles andere in den Tabellen bleibt praktisch untrainiert. Die Autoren nennen das Ergebnis ein selbstbestätigendes Gleichgewicht (self-confirming equilibrium) – Überzeugungen, die auf dem beschrittenen Weg stimmen und abseits davon nie geprüft werden. Verfeinert man das Preisraster von 15 auf 200 Stufen, wodurch sich dasselbe Training auf mehr Situationen verteilt, sinkt der Kollusionsindex von 0,64 auf 0,23, wie dieses Bild vorhersagt. Mit 5 Paaren, die exakt nach Calvanos Abbruchregel trainiert wurden, bleiben alle Ergebnisse bestehen; die lohnende Abweichung schrumpft auf 10,4 %.
Weiterhin hohe Preise, anderes Gegenmittel
Das Problem für die Verbraucher verschwindet nicht: Die Preise bleiben deutlich über dem Wettbewerbsniveau. Was sich ändert, ist die Diagnose. Die Autoren argumentieren, dass diese Paare ohne bedingte Drohung schlecht zu absprachenähnlichen rechtlichen Kategorien passen – und dass das Stören der Paarungen (ein neuer Marktteilnehmer, Rotation, Neutraining) die Koordination der eingefrorenen Programme zerstört. Sie bieten ihre Tests zudem als Standard an, den jedes Preissystem vor dem Einsatz durchlaufen sollte. Ihre Aussagen gelten für tabellarisches Q-Learning in diesem einen Markt; ob Deep-Learning-Agenten echte Drohungen lernen, ist eine Frage, die ihr Protokoll beantworten soll, statt sie vorauszusetzen.