FİYATLAMA ALGORİTMALARI ANLAŞIYOR — BİRBİRLERİNİ TEHDİT ETMEDEN
Fiyatlama giderek öğrenen sistemlere devrediliyor. İyi bilinen bir bulgu rekabet otoritelerini kaygılandırıyor: her biri yalnızca simüle edilmiş iki firmalı bir piyasada kendi kârını en üst düzeye çıkarmak üzere eğitilmiş basit pekiştirmeli öğrenme (reinforcement learning) programları, sonunda rekabetçi düzeyin çok üstünde fiyatlar istiyor. Emilio Calvano ve meslektaşlarının American Economic Review’da yayımlanan 2020 tarihli dönüm noktası niteliğindeki çalışması bir adım ileri gitti. Bir programı bir dönem boyunca fiyatını düşürmeye zorladıktan sonra rakibin de fiyat kırdığını, ardından ikisinin de eski fiyatlarına döndüğünü gördüler. Bunu bir “ödül–ceza düzeni” olarak okudular: fiyatımı kırarsan misilleme yaparım, dolayısıyla hile asla kazandırmaz.
São Paulo Üniversitesi’nden Kauê Lopes de Moraes ve Rodrigo De Losso’ya göre sonuca politika ağırlığını veren de bu yorumdu. “Yalnızca yüksek olan fiyatlar bir yapaylıktır; misillemeyle korunan fiyatlar ise bir karteldir.” Soruları dar kapsamlı: gerçekten bir ceza mekanizması var mı?
Önce yeniden üret, sonra dondur
Yazarlar Calvano’nun piyasasını yeniden kurdu: iki firma, 15 olası fiyat, her program önceki iki fiyatı hatırlayan bir değerler tablosu (tablo tabanlı Q-öğrenme) — 225 olası durum. Her biri 2 milyon adım olmak üzere 1.024 çift eğittiler. Sonuç yeniden üretiliyor: fiyatlar, 0’ın rekabetçi (Nash) fiyat, 1’in tekel fiyatı olduğu ölçekte 0,668’lik bir danışıklılık endeksinde (collusion index) yerleşiyor.
Ünlü örüntü de öyle. Bir ajanı fiyat kırmaya zorlayın, 1.024 çiftin 1.013’ünde rakibin fiyatı düşüyor; çiftlerin %98,2’sinde ikisi de, genellikle beş dönem içinde, önceki fiyatlarına dönüyor.
Sonra kilit hamle: eğitilmiş programları dondurmak, öğrenmeyi kapatmak ve gerçekte ne taşıdıklarını sınamak.
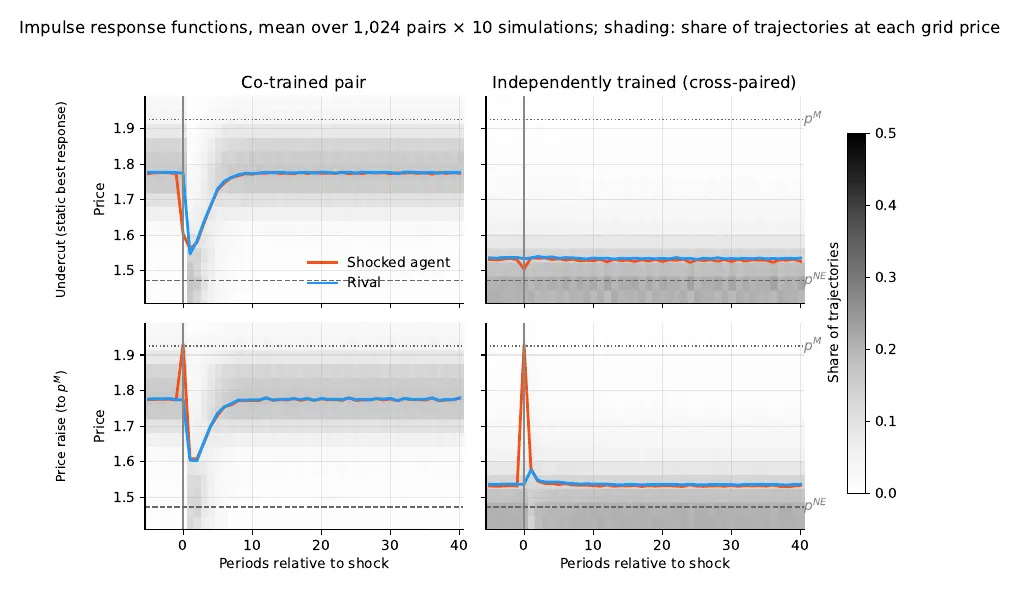
Zorla fiyat kırmadan (üstte) ya da tekel fiyatına zorla yükseltmeden (altta) sonra fiyat; eğitilmiş çiftler (solda) ve yabancılarla eşleştirilmiş ajanlar (sağda) için. — Şekil 3, Lopes de Moraes ve De Losso (2026), arXiv:2610.21867.
Beş denetim, ceza veren yok
Yön fark etmiyor. Ajanı fiyatını tekel düzeyine yükseltmeye zorlayın — kartele doğru bir hamle — rakip yine fiyatını düşürüp sonra toparlanıyor; 1.024 çiftin 960’ında. İş birliğine ihanetle tamamen aynı biçimde tepki veren bir yanıt, ihaneti caydırmak için tasarlanmış bir kural değildir.
Rakibin bir modeli yok. Eğitilmiş ajanları gerçekten ceza veren, senaryosu yazılmış bir rakiple karşılaştırın — ihanete uğrayana kadar iş birliği yapan, sonra sonsuza dek rekabetçi fiyatı oynayan bir rakip. İş birliği içinde başlatıldığında ajanların %77’si dört dönem içinde onun fiyatını kırıyor ve bir daha toparlanamıyor.
Alışılmış yolun dışında mantık yok. Tepki fonksiyonları olarak okunduğunda, öğrenilmiş tablolar mantıklı en iyi yanıtları güçlükle izliyor (ortalama sıra korelasyonu 0,18; −0,70 ile 0,84 arasında).
Geri dönüş zorunlu. 1.024 çiftin 914’ünde iki dondurulmuş program, 225 olası durumun tamamını içine çeken tek bir çekiciye (attractor) sahip. Her yerden, her bozulmadan sonra, her nedenle olağan fiyatlarına dönüyorlar — bir topun kâsenin dibine geri yuvarlanması gibi. Rastgele tablolar bunu çok daha kötü yapıyor; yani eğitim hız ve konum katıyor, ama seçicilik katmıyor.
Bu, biçimin bir sınırı değil. Yazarlar aynı 225 × 15 tablonun içinde gerçek ceza kurallarını elle kurdu — biri affeden, biri asla unutmayan. İkisi de çalışıyor. Kapasite orada; öğrenme onu kullanmadı.
Çiftin bir uzlaşımı
Sırada “yabancı” testi var. Bir ajanı aynı protokolle başka bir eğitim koşusundan gelen, hiç karşılaşmadığı bir ajanla eşleştirin: danışıklılık endeksi 0,669’dan 0,134’e düşüyor — %80’lik bir çöküş; eşleşmelerin %7,4’ü rekabetçi düzeyin altında fiyat veriyor. Aynı fiyatta yerleşmiş çiftler bile dağılıyor. “Bu ortamda danışıklılık bir ajanın sahip olduğu bir strateji değil; bir çiftin sürdürdüğü bir uzlaşımdır.”
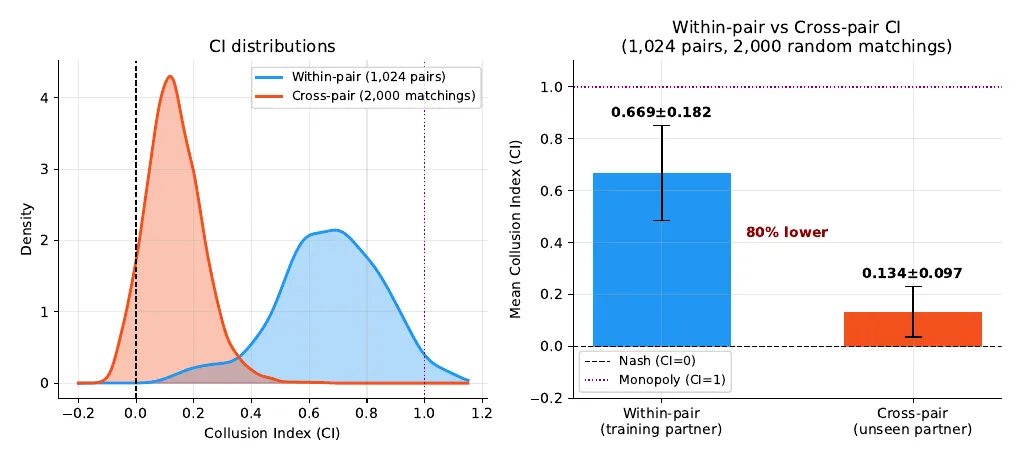
Eğitim ortağıyla (mavi) ve hiç görülmemiş bir ortakla (turuncu) danışıklılık endeksi: 0,669’a karşı 0,134. — Şekil 7, Lopes de Moraes ve De Losso (2026), arXiv:2610.21867.
Kimsenin denemediği sapma
Yazarlar Calvano’nun kendi denetimini doğruluyor: tek dönemlik bir fiyat kırma çiftlerin %92’sinde kazandırmıyor. Ama bu saf bir sapma. Her dondurulmuş ortağa karşı olası en iyi stratejiyi kesin dinamik programlamayla hesaplamak, ortalamada %17,5 daha fazla kâr veriyor (%93,7’ye kadar). 2.048 ajanın yalnızca 124’ü zaten en iyi yanıtını oynuyor. “Düzen yalnızca hiçbir optimize edicinin seçmeyeceği sapmayı caydırıyor.”
Neden? Eğitim sırasında keşif (exploration) azaldıkça her çift yalnızca dar bir durum koridorunu ziyaret ediyor. Tablolardaki geri kalan her şey pratikte eğitilmemiş kalıyor. Yazarlar sonuca kendini doğrulayan denge (self-confirming equilibrium) diyor — izlenen yolda doğru olan, ama onun dışında hiç sınanmayan inançlar. Aynı eğitimi daha fazla duruma yayan, fiyat ızgarasını 15’ten 200 düzeye inceltmek, bu tablonun öngördüğü gibi, danışıklılık endeksini 0,64’ten 0,23’e düşürüyor. Tam olarak Calvano’nun durma kuralına göre eğitilmiş 5 çiftte her sonuç geçerli; kârlı sapma %10,4’e geriliyor.
Fiyatlar hâlâ yüksek, çare farklı
Tüketicinin sorunu ortadan kalkmıyor: fiyatlar rekabetin çok üstünde kalıyor. Değişen şey teşhis. Yazarlar, koşullu bir tehdit olmadığından bu çiftlerin anlaşma benzeri hukuki kategorilere pek uymadığını ve eşleşmeleri bozmanın (yeni bir giriş, rotasyon, yeniden eğitim) dondurulmuş programların koordinasyonunu yok ettiğini savunuyor. Testlerini de herhangi bir fiyatlama sistemi için dağıtım öncesi bir standart olarak öneriyorlar. İddiaları bu tek piyasadaki tablo tabanlı Q-öğrenmeyle sınırlı; derin öğrenme ajanlarının gerçek tehditler öğrenip öğrenmediği, protokollerinin varsaymak için değil yanıtlamak için kurulduğu bir soru.