ЦЕНОВЫЕ АЛГОРИТМЫ ВСТУПАЮТ В СГОВОР — БЕЗ ВЗАИМНЫХ УГРОЗ
Ценообразование всё чаще доверяют обучающимся системам. Известный результат тревожит антимонопольные ведомства: простые программы обучения с подкреплением, каждая из которых обучена лишь максимизировать собственную прибыль на смоделированном рынке с двумя фирмами, в итоге назначают цены намного выше конкурентного уровня. Знаковое исследование Эмилио Кальвано и коллег 2020 года в American Economic Review пошло дальше. Заставив одну программу на один период снизить цену, авторы увидели, что соперник тоже снижает цену, а затем обе возвращаются к прежним ценам. Они истолковали это как «схему поощрения и наказания»: сбей мне цену, и я отомщу, так что жульничать никогда не выгодно.
Именно эта трактовка, пишут Кауэ Лопес де Мораес и Родригу Де Лоссо из Университета Сан-Паулу, придала результату вес для регуляторной политики. «Просто высокие цены — это артефакт; цены, защищённые возмездием, — это картель». Их вопрос узок: существует ли на самом деле механизм наказания?
Сначала воспроизвести, потом заморозить
Авторы воссоздали рынок Кальвано: две фирмы, 15 возможных цен, каждая программа — таблица значений (табличное Q-обучение), которая помнит две предыдущие цены, — итого 225 возможных ситуаций. Они обучили 1024 пары, по 2 миллиона шагов каждая. Результат воспроизводится: цены устанавливаются на индексе сговора 0,668, где 0 — конкурентная цена (равновесие Нэша), а 1 — монопольная.
Воспроизводится и знаменитая закономерность. Заставьте одного агента сбить цену — и в 1013 парах из 1024 цена соперника падает; в 98,2% пар оба возвращаются к прежним ценам, обычно в пределах пяти периодов.
Затем ключевой ход: заморозить обученные программы, отключить обучение и проверить, что они на самом деле в себе несут.
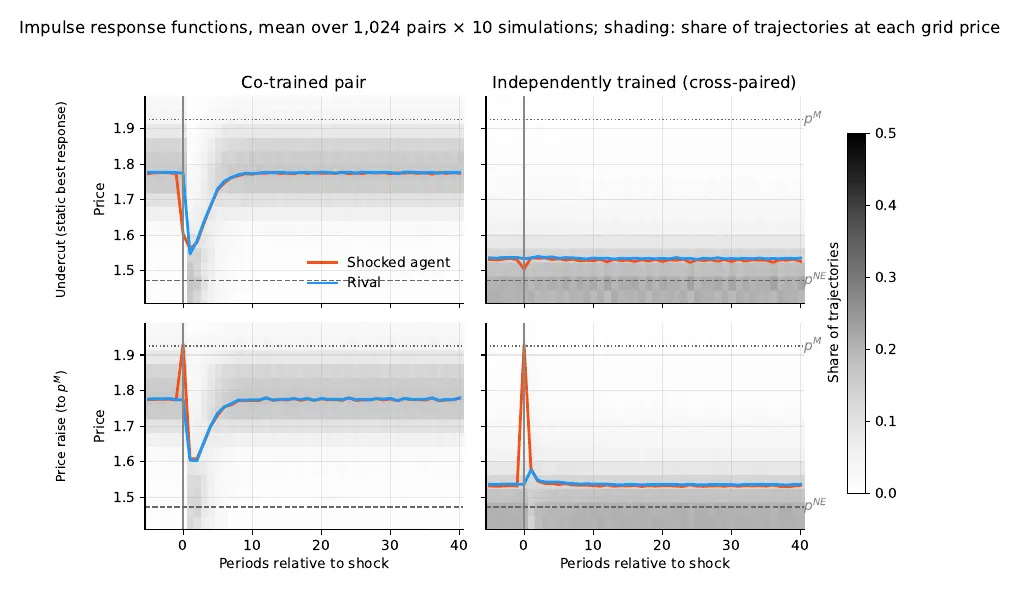
Цена после принудительного снижения (вверху) или принудительного повышения до монопольной цены (внизу) — для обученных пар (слева) и для агентов, сведённых с незнакомцами (справа). — Рисунок 3, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
Пять проверок — и никакого карателя
Направление не имеет значения. Заставьте агента поднять цену до монопольного уровня — то есть сделать шаг к картелю, — и соперник всё равно снижает цену, а затем восстанавливает её, в 960 парах из 1024. Реакция, которая воспринимает сотрудничество точно так же, как предательство, не может быть правилом, созданным для сдерживания предательства.
Никакой модели противника. Поставьте обученных агентов против запрограммированного соперника, который наказывает по-настоящему: он сотрудничает, пока его не обманут, а затем навсегда переходит на конкурентную цену. Если начать с сотрудничества, 77% агентов сбивают ему цену в течение четырёх периодов и больше никогда не восстанавливаются.
Никакой логики вне проторённой колеи. Если прочитать выученные таблицы как функции реакции, они едва следуют разумным наилучшим ответам (средняя ранговая корреляция 0,18, разброс от −0,70 до 0,84).
Возврат вынужденный. В 914 парах из 1024 у двух замороженных программ есть единственный аттрактор, который притягивает все 225 возможных ситуаций. Они возвращаются к своим привычным ценам откуда угодно, после любого возмущения, по любой причине — так шарик скатывается обратно на дно чаши. Случайные таблицы делают это гораздо хуже, так что обучение действительно добавляет скорость и точность положения — но не избирательность.
Дело не в ограничениях формата. Авторы вручную построили настоящие правила наказания — одно прощающее, другое никогда не забывающее — в той же самой таблице 225 × 15. Оба работают. Возможность есть; обучение ею не воспользовалось.
Соглашение внутри пары
Далее — проверка «незнакомцем». Сведите агента с агентом из другого обучающего прогона — тот же протокол, но они никогда не встречались: индекс сговора падает с 0,669 до 0,134 — обвал на 80%, причём в 7,4% таких пар цены оказываются ниже конкурентного уровня. Распадаются даже пары, которые пришли к одной и той же цене. «Сговор в этой среде — не стратегия, которой обладает агент; это соглашение, которое поддерживает пара».
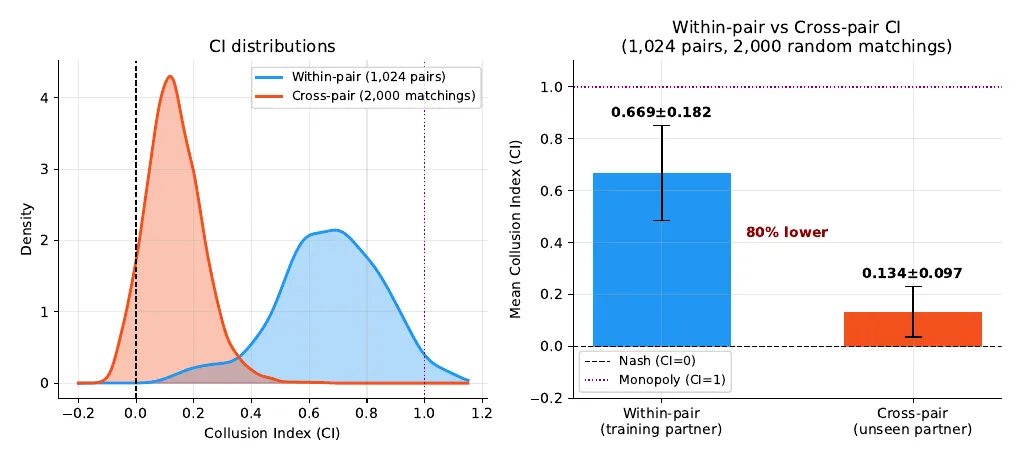
Индекс сговора с партнёром по обучению (синий) и с незнакомым партнёром (оранжевый): 0,669 против 0,134. — Рисунок 7, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
Отклонение, которое никто не пробует
Авторы действительно подтверждают проверку самого Кальвано: снижение цены на один период невыгодно в 92% пар. Но это наивное отклонение. Если вычислить наилучшую возможную стратегию против каждого замороженного партнёра методом точного динамического программирования, она даёт в среднем на 17,5% больше прибыли (до 93,7%). Лишь 124 агента из 2048 уже играют свой наилучший ответ. «Схема сдерживает только то отклонение, которое не выбрал бы ни один оптимизатор».
Почему? По мере того как исследование среды в ходе обучения затухает, каждая пара посещает лишь узкий коридор ситуаций. Всё остальное в таблицах остаётся практически необученным. Авторы называют результат самоподтверждающимся равновесием (self-confirming equilibrium) — убеждениями, верными на пройденном пути и никогда не проверявшимися вне его. Измельчение ценовой сетки с 15 до 200 уровней, при котором то же обучение распределяется по большему числу ситуаций, снижает индекс сговора с 0,64 до 0,23, как и предсказывает эта картина. С 5 парами, обученными точно по правилу остановки Кальвано, все результаты сохраняются, а выгода от отклонения сокращается до 10,4%.
Цены всё ещё высоки, но лекарство другое
Проблема для потребителей никуда не исчезает: цены остаются намного выше конкурентных. Меняется диагноз. Авторы утверждают, что без условной угрозы такие пары плохо вписываются в правовые категории, подобные соглашению, — и что нарушение сложившихся пар (новый участник рынка, ротация, переобучение) разрушает координацию замороженных программ. Они также предлагают свои проверки как стандарт, который следует применять до внедрения любой системы ценообразования. Их выводы касаются табличного Q-обучения на одном этом рынке; учатся ли агенты глубокого обучения настоящим угрозам — вопрос, на который их протокол призван ответить, а не принимать ответ на веру.