価格設定アルゴリズムは談合する、互いを脅すことなく
価格設定はますます学習システムに任されるようになっている。ある有名な発見が競争当局を悩ませている。単純な強化学習のプログラムを、模擬的な2社市場で、それぞれ自社の利益を最大化するようにだけ訓練すると、競争水準をかなり上回る価格をつけるようになるのだ。エミリオ・カルヴァーノ(Emilio Calvano)らによる2020年の画期的な研究は、American Economic Review誌でさらに踏み込んだ。一方のプログラムに1期間だけ値下げを強制すると、相手も値下げし、その後両者とも元の価格に戻るのが観察された。彼らはこれを「報酬と罰のしくみ」と解釈した。値下げしたら報復する、だから裏切りは決して得にならない、というわけだ。
サンパウロ大学のカウエ・ロペス・デ・モラエス(Kauê Lopes de Moraes)とホドリゴ・デ・ロッソ(Rodrigo De Losso)は、その解釈こそが、この結果に政策上の重みを与えたのだと書く。「単に高いだけの価格は人為的な産物にすぎない。報復によって守られた価格はカルテルである。」彼らの問いは限定的だ。罰のしくみは本当に存在するのか。
まず再現し、次に凍結する
著者らはカルヴァーノの市場を作り直した。2社、15通りの価格、それぞれのプログラムは直前の2つの価格を記憶する値の表(表形式のQ学習)で、ありうる状況は225通りだ。彼らは1,024組を、それぞれ200万ステップ訓練した。結果は再現された。価格は談合指数0.668に落ち着いた。0が競争(ナッシュ)価格、1が独占価格である。
有名なパターンも再現された。一方のエージェントに値下げを強制すると、1,024組のうち1,013組で相手の価格が下がり、98.2%の組で両者が元の価格に戻った。たいていは5期間以内だ。
そして鍵となる一手。訓練したプログラムを凍結し、学習を止めて、それが実際に何を身につけているのかを検証する。
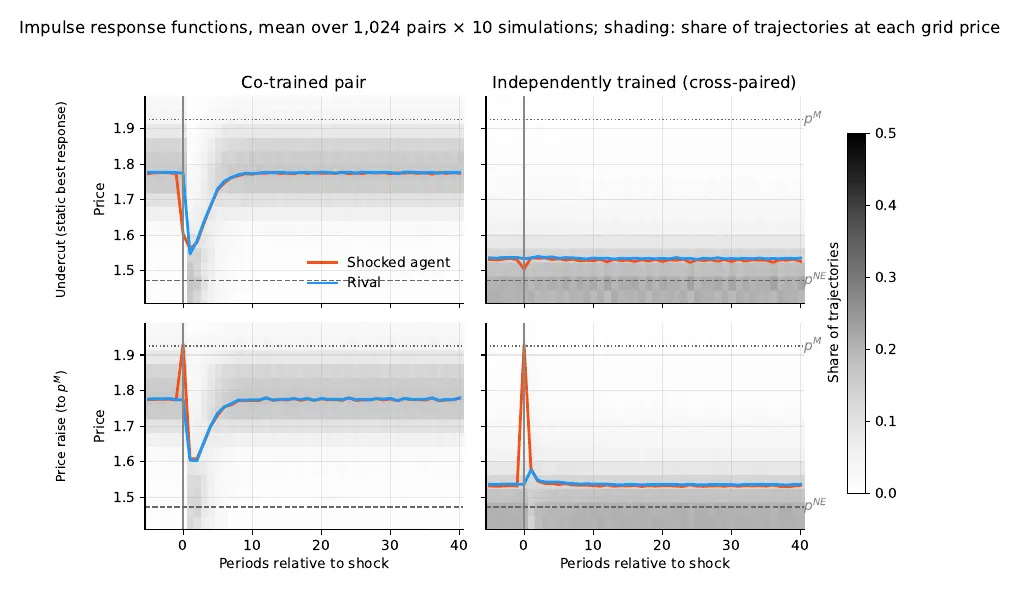
強制的な値下げ(上)または独占価格への強制的な値上げ(下)の後の価格。訓練した組(左)と、見知らぬ相手と組ませたエージェント(右)。— Figure 3, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
5つの監査、罰する者はいない
方向は関係ない。エージェントに価格を独占水準まで上げるよう強制する。カルテルに向かう動きだ。それでも相手は価格を下げ、その後回復する。1,024組のうち960組でそうなった。協調を裏切りとまったく同じように扱う反応は、裏切りを抑止するために設計されたルールではない。
相手のモデルがない。訓練したエージェントを、本当に罰する台本どおりの相手と対戦させる。その相手は、裏切られるまでは協調し、裏切られたら永遠に競争価格をつける。協調状態から始めると、エージェントの77% が4期間以内に値下げし、二度と回復しない。
ふだん通らない道での論理がない。反応関数として読むと、学習した表は、理にかなった最適反応にほとんど従っていない(平均順位相関0.18、範囲は−0.70から0.84)。
戻るのは強制的だ。1,024組のうち914組で、凍結した2つのプログラムは、225通りすべての状況を引き寄せる単一のアトラクターをもつ。どこからでも、どんな乱れの後でも、どんな理由でも、いつもの価格に戻る。ボールがお椀の底に転がり戻るように。ランダムな表ではこれがずっとうまくいかないので、訓練はたしかに速さと位置を加えている。ただ、選択性は加えていない。
形式の限界ではない。著者らは、まったく同じ225 × 15の表の中に、本物の罰のルールを手作業で組み込んだ。許すルールと、決して忘れないルールだ。どちらも機能する。能力はある。学習がそれを使わなかっただけだ。
組だけの慣習
次は「見知らぬ相手」の検証だ。エージェントを、同じ手順で別に訓練した、一度も会ったことのない相手と組ませる。談合指数は0.669から0.134に下がる。80%の崩壊だ。組み合わせの7.4%では、価格が競争水準を下回った。同じ価格に落ち着いていた組どうしでさえ崩れる。「この環境での談合は、エージェントがもつ戦略ではない。組が保つ慣習なのだ。」
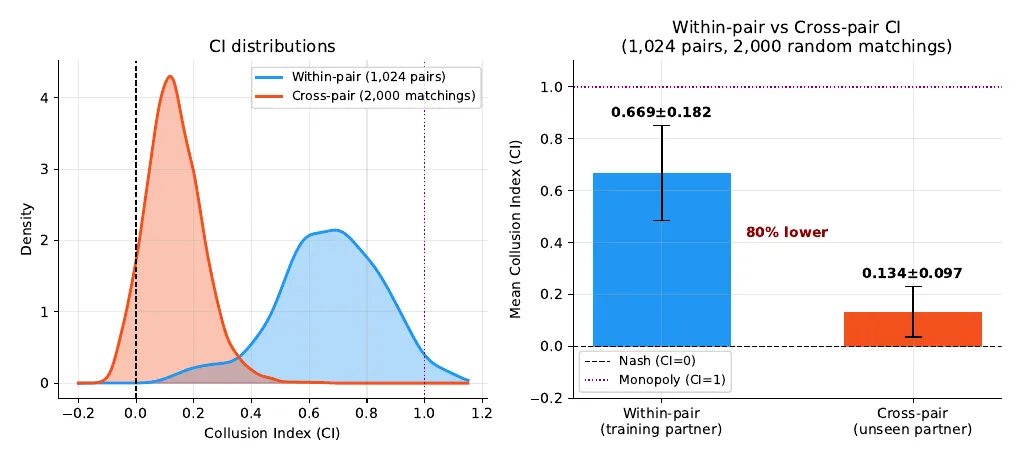
訓練相手との談合指数(青)と、初めての相手との談合指数(オレンジ):0.669対0.134。— Figure 7, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
誰も試さない逸脱
著者らは、カルヴァーノ自身の確認もたしかに追認している。1期間の値下げは、92%の組で得にならない。だがそれは素朴な逸脱だ。凍結した各相手に対する最良の戦略を、厳密な動的計画法で計算すると、利益は平均17.5%増える(最大93.7%)。2,048のエージェントのうち、すでに最適反応をとっているのは124だけだ。「このしくみが抑止するのは、どんな最適化者も選ばない逸脱だけだ。」
なぜか。訓練中に探索が減っていくにつれ、各組は状況のせまい回廊しか訪れなくなる。表のそれ以外の部分は、実質的に訓練されないままだ。著者らはこの結果を自己確証均衡と呼ぶ。たどった道の上では正しく、その外では一度も試されない信念のことだ。価格の刻みを15段階から200段階に細かくすると、同じ訓練がより多くの状況に分散され、談合指数は0.64から0.23に下がる。この描像が予測するとおりだ。カルヴァーノの停止規則どおりに正確に訓練した5組でも、すべての結果が成り立ち、得になる逸脱は10.4%に縮んだ。
価格は高いまま、処方箋は違う
消費者にとっての問題はなくならない。価格は競争水準をかなり上回ったままだ。変わるのは診断である。著者らは、条件つきの脅しがない以上、こうした組は合意に類する法的な範疇にはうまく当てはまらないと論じる。そして、組み合わせを乱すこと(新規参入、入れ替え、再訓練)が、凍結したプログラムの協調を壊すとする。彼らはまた、自分たちの検証を、あらゆる価格設定システムの導入前の基準として提案している。彼らの主張が対象とするのは、この1つの市場での表形式Q学習だ。深層学習のエージェントが本物の脅しを学ぶかどうかは、彼らの手順が前提とするのではなく、答えるために設計された問いである。