LES ALGORITHMES DE PRIX S'ENTENDENT — SANS SE MENACER
On confie de plus en plus la fixation des prix à des systèmes qui apprennent. Un résultat bien connu inquiète les autorités de concurrence : de simples programmes d’apprentissage par renforcement, chacun entraîné seulement à maximiser son propre profit dans un marché simulé à deux entreprises, finissent par pratiquer des prix bien au-dessus du niveau concurrentiel. Une étude phare de 2020, d’Emilio Calvano et ses collègues dans l’American Economic Review, allait plus loin. En forçant un programme à baisser son prix pendant une période, ils voyaient le rival baisser aussi, puis les deux revenir à leurs anciens prix. Ils y lisaient un « schéma récompense-punition » : baisse ton prix et je riposte, donc tricher ne paie jamais.
Cette lecture, écrivent Kauê Lopes de Moraes et Rodrigo De Losso, de l’université de São Paulo, est ce qui a donné au résultat son poids politique. « Des prix simplement élevés sont un artefact ; des prix défendus par des représailles sont un cartel. » Leur question est étroite : y a-t-il vraiment un mécanisme de punition ?
Reproduire d’abord, puis geler
Les auteurs ont reconstruit le marché de Calvano : deux entreprises, 15 prix possibles, chaque programme étant une table de valeurs (Q-learning tabulaire) qui se souvient des deux prix précédents — 225 situations possibles. Ils ont entraîné 1 024 paires, 2 millions de pas chacune. Le résultat se reproduit : les prix se stabilisent à un indice de collusion de 0,668, où 0 correspond au prix concurrentiel (de Nash) et 1 au prix de monopole.
Le fameux motif aussi. Forcez un agent à baisser son prix : dans 1 013 paires sur 1 024, le prix du rival chute ; dans 98,2 % des paires, les deux reviennent à leurs prix d’avant, en général en moins de cinq périodes.
Puis le geste clé : geler les programmes entraînés, couper l’apprentissage, et tester ce qu’ils portent réellement.
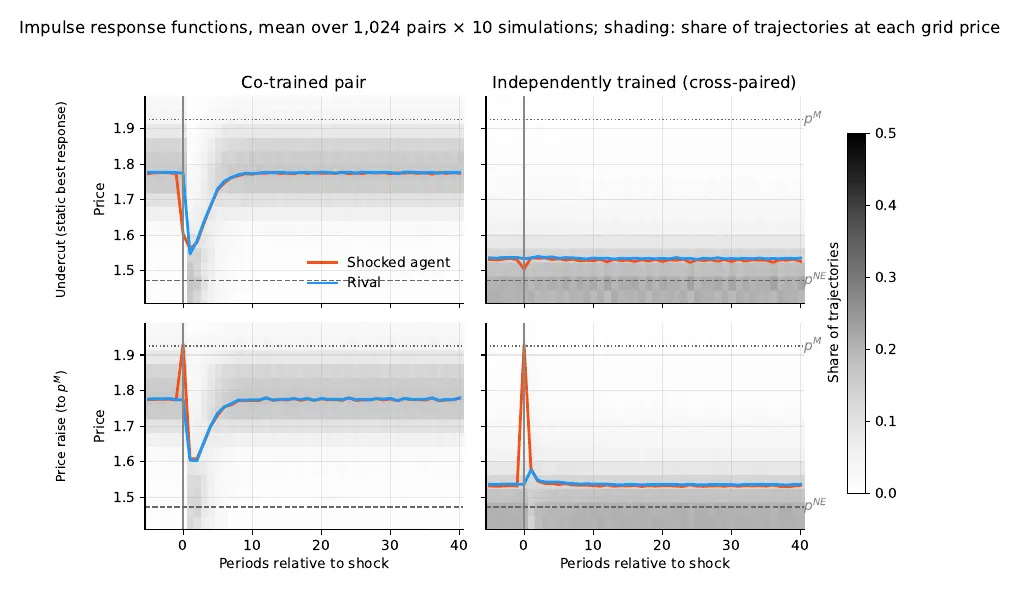
Prix après une baisse forcée (en haut) ou une hausse forcée au prix de monopole (en bas), pour des paires entraînées ensemble (à gauche) et pour des agents associés à des inconnus (à droite). — Figure 3, Lopes de Moraes et De Losso (2026), arXiv:2610.21867.
Cinq audits, aucun punisseur
Le sens ne compte pas. Forcez l’agent à augmenter son prix jusqu’au monopole — un pas vers le cartel — et le rival baisse quand même son prix avant de revenir, dans 960 paires sur 1 024. Une réponse qui traite la coopération exactement comme une trahison n’est pas une règle conçue pour dissuader la trahison.
Pas de modèle de l’adversaire. Opposez aux agents entraînés un rival scripté qui punit vraiment — il coopère jusqu’à ce qu’on le trahisse, puis joue le prix concurrentiel pour toujours. En partant de la coopération, 77 % des agents le trahissent en quatre périodes au plus et ne s’en remettent jamais.
Pas de logique hors des sentiers battus. Lues comme des fonctions de réaction, les tables apprises suivent à peine des meilleures réponses sensées (corrélation de rang moyenne de 0,18, de −0,70 à 0,84).
Le retour est forcé. Dans 914 paires sur 1 024, les deux programmes gelés ont un seul attracteur qui aspire les 225 situations possibles. Ils reviennent à leurs prix habituels depuis n’importe où, après n’importe quelle perturbation, pour n’importe quelle raison — comme une bille qui retombe au fond d’un bol. Des tables aléatoires le font bien moins nettement : l’entraînement apporte donc vitesse et placement, mais pas de sélectivité.
Ce n’est pas une limite du format. Les auteurs ont construit à la main de vraies règles de punition — l’une qui pardonne, l’autre qui n’oublie jamais — dans la même table 225 × 15. Les deux fonctionnent. La capacité est là ; l’apprentissage ne s’en est pas servi.
Une convention de la paire
Vient ensuite le test de l’« inconnu ». Associez un agent à un autre issu d’un entraînement différent, même protocole, jamais rencontré : l’indice de collusion tombe de 0,669 à 0,134 — un effondrement de 80 %, et 7,4 % des appariements tarifent même sous le niveau concurrentiel. Même des paires qui s’étaient fixées sur le même prix se défont. « Dans cet environnement, la collusion n’est pas une stratégie qu’a un agent ; c’est une convention que garde une paire. »
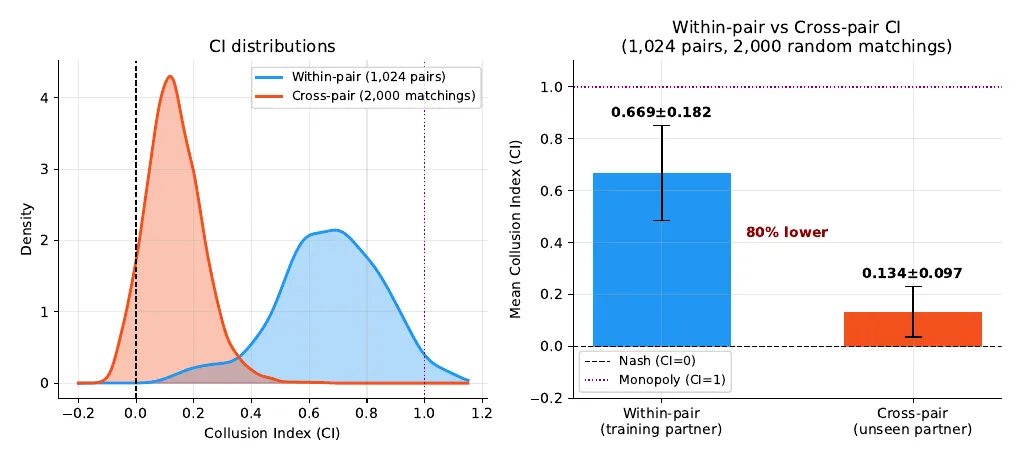
Indice de collusion avec le partenaire d’entraînement (bleu) et avec un partenaire inconnu (orange) : 0,669 contre 0,134. — Figure 7, Lopes de Moraes et De Losso (2026), arXiv:2610.21867.
La déviation que personne n’essaie
Les auteurs confirment bien le test de Calvano : une baisse de prix d’une seule période ne paie pas dans 92 % des paires. Mais c’est une déviation naïve. Calculer la meilleure stratégie possible face à chaque partenaire gelé, par programmation dynamique exacte, rapporte 17,5 % de profit en plus en moyenne (jusqu’à 93,7 %). Seuls 124 agents sur 2 048 jouent déjà leur meilleure réponse. « Le schéma ne dissuade que la déviation qu’aucun optimiseur ne choisirait. »
Pourquoi ? À mesure que l’exploration s’éteint pendant l’entraînement, chaque paire ne visite plus qu’un couloir étroit de situations. Tout le reste des tables demeure pratiquement non entraîné. Les auteurs parlent d’équilibre auto-confirmé — des croyances justes sur le chemin suivi, jamais mises à l’épreuve ailleurs. Affiner la grille de prix de 15 à 200 niveaux, ce qui étale le même entraînement sur plus de situations, fait baisser l’indice de collusion de 0,64 à 0,23, comme ce tableau le prévoit. Sur 5 paires entraînées exactement selon le critère d’arrêt de Calvano, tous les résultats tiennent, la déviation rentable descendant à 10,4 %.
Toujours des prix élevés, un autre remède
Le problème pour les consommateurs ne disparaît pas : les prix restent bien au-dessus de la concurrence. Ce qui change, c’est le diagnostic. Selon les auteurs, sans menace conditionnelle, ces paires s’accordent mal avec des catégories juridiques proches de l’entente — et perturber les appariements (un nouvel entrant, une rotation, un réentraînement) détruit la coordination des programmes gelés. Ils proposent aussi leurs tests comme standard avant tout déploiement d’un système de tarification. Leurs conclusions valent pour le Q-learning tabulaire dans ce marché précis ; savoir si des agents d’apprentissage profond apprennent de vraies menaces est une question que leur protocole est fait pour trancher, pas pour présumer.