ధరల అల్గారిథమ్లు కుమ్మక్కవుతాయి — ఒకదాన్నొకటి బెదిరించుకోకుండానే
ధరల నిర్ణయం ఎక్కువగా నేర్చుకునే వ్యవస్థలకు అప్పగించబడుతోంది. ఒక ప్రసిద్ధ ఫలితం పోటీ అధికారులను ఆందోళనకు గురిచేస్తోంది: సరళమైన ప్రబలన అభ్యసన (reinforcement learning) ప్రోగ్రామ్లు, ఒక్కొక్కటి రెండు సంస్థల సిమ్యులేటెడ్ మార్కెట్లో తన సొంత లాభాన్ని గరిష్ఠం చేసుకోవడానికి మాత్రమే శిక్షణ పొంది, చివరకు పోటీ స్థాయి కంటే చాలా ఎక్కువ ధరలు వసూలు చేస్తాయి. ఎమిలియో కాల్వానో (Emilio Calvano) మరియు సహచరులు American Economic Review లో ప్రచురించిన 2020 నాటి మైలురాయి అధ్యయనం ఇంకా ముందుకు వెళ్లింది. ఒక ప్రోగ్రామ్ను ఒక వ్యవధికి ధర తగ్గించమని బలవంతం చేశాక, ప్రత్యర్థి కూడా తగ్గించడం, తర్వాత రెండూ తమ పాత ధరలకు తిరిగి రావడం వారు చూశారు. వారు దీన్ని “బహుమతి–శిక్ష పథకం” గా చదివారు: నా కంటే తక్కువకు అమ్మితే నేను ప్రతీకారం తీర్చుకుంటా, కాబట్టి మోసం ఎప్పుడూ లాభించదు.
ఆ వ్యాఖ్యానమే ఈ ఫలితానికి విధానపరమైన బరువు ఇచ్చిందని సావో పాలో విశ్వవిద్యాలయానికి చెందిన కావుయే లోపెస్ డి మొరాయెస్ (Kauê Lopes de Moraes), రోడ్రిగో డి లోస్సో (Rodrigo De Losso) రాస్తారు. “కేవలం ఎక్కువగా ఉన్న ధరలు ఒక కృత్రిమ ఉత్పత్తి; ప్రతీకారంతో కాపాడిన ధరలు కార్టెల్.” వారి ప్రశ్న పరిమితమైనది: నిజంగా శిక్షా యంత్రాంగం ఉందా?
ముందు పునరావృతం, తర్వాత స్తంభింపజేయడం
రచయితలు కాల్వానో మార్కెట్ను పునర్నిర్మించారు: రెండు సంస్థలు, 15 సాధ్యమైన ధరలు, ప్రతి ప్రోగ్రామ్ మునుపటి రెండు ధరలను గుర్తుంచుకునే విలువల పట్టిక (పట్టిక రూప Q-learning) — 225 సాధ్యమైన పరిస్థితులు. వారు 1,024 జతలకు శిక్షణ ఇచ్చారు, ఒక్కొక్కదానికి 20 లక్షల అడుగులు. ఫలితం పునరావృతమవుతుంది: ధరలు 0.668 కుమ్మక్కు సూచిక వద్ద స్థిరపడతాయి, ఇక్కడ 0 అంటే పోటీ (నాష్) ధర, 1 అంటే గుత్తాధిపత్య ధర.
ప్రసిద్ధ నమూనా కూడా పునరావృతమవుతుంది. ఒక ఏజెంట్ను తక్కువకు అమ్మమని బలవంతం చేస్తే, 1,024 లో 1,013 జతల్లో ప్రత్యర్థి ధర పడిపోతుంది; 98.2% జతల్లో రెండూ తమ మునుపటి ధరలకు తిరిగి వస్తాయి, సాధారణంగా ఐదు వ్యవధుల్లోపే.
తర్వాత కీలక అడుగు: శిక్షణ పొందిన ప్రోగ్రామ్లను స్తంభింపజేసి, నేర్చుకోవడాన్ని ఆపి, అవి వాస్తవంగా ఏం మోసుకెళ్తున్నాయో పరీక్షించడం.
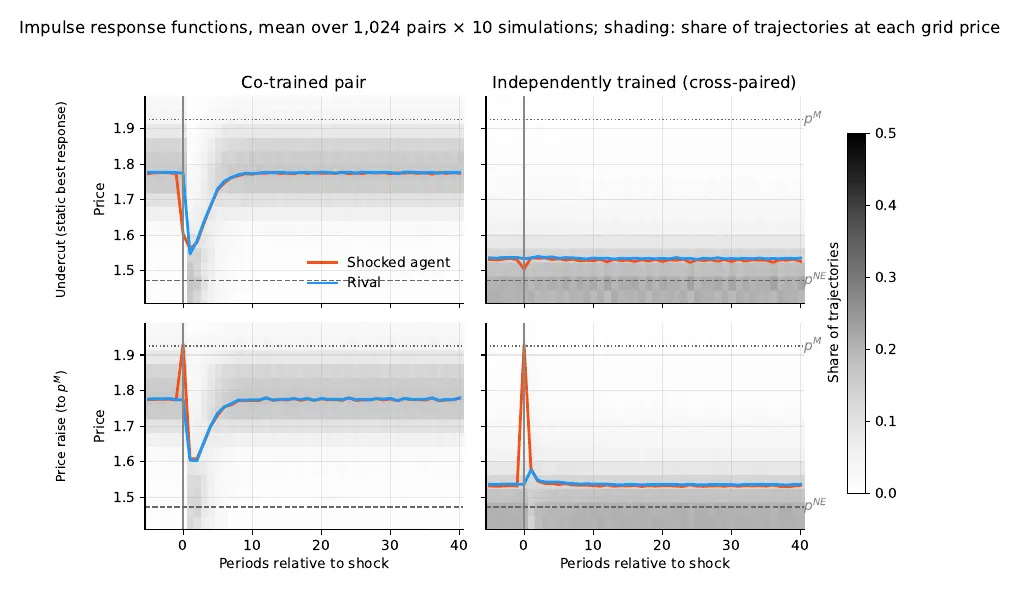
బలవంతపు తగ్గింపు (పైన) లేదా గుత్తాధిపత్య ధరకు బలవంతపు పెంపు (కింద) తర్వాత ధర, శిక్షణ పొందిన జతలకు (ఎడమ), అపరిచితులతో జత చేసిన ఏజెంట్లకు (కుడి). — Figure 3, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
ఐదు తనిఖీలు, శిక్షించేవాడు లేడు
దిశ ముఖ్యం కాదు. ఏజెంట్ను తన ధరను గుత్తాధిపత్య స్థాయికి పెంచమని బలవంతం చేయండి — కార్టెల్ వైపు ఒక అడుగు — అయినా ప్రత్యర్థి తన ధరను తగ్గించి, తర్వాత కోలుకుంటుంది, 1,024 లో 960 జతల్లో. సహకారాన్ని సరిగ్గా ద్రోహం లాగే పరిగణించే ప్రతిస్పందన, ద్రోహాన్ని నిరోధించడానికి రూపొందించిన నియమం కాదు.
ప్రత్యర్థి గురించి మోడల్ లేదు. శిక్షణ పొందిన ఏజెంట్లను నిజంగా శిక్షించే, ముందే రాసిన ప్రత్యర్థితో ఎదుర్కోనివ్వండి — అది ద్రోహం జరిగే వరకు సహకరిస్తుంది, తర్వాత శాశ్వతంగా పోటీ ధరను ఆడుతుంది. సహకారంలో మొదలుపెడితే, 77% ఏజెంట్లు నాలుగు వ్యవధుల్లోపే దాని కంటే తక్కువకు అమ్ముతాయి, ఎప్పటికీ కోలుకోవు.
తొక్కిన దారి బయట తర్కం లేదు. ప్రతిచర్య ప్రమేయాలుగా చదివితే, నేర్చుకున్న పట్టికలు సహేతుకమైన ఉత్తమ ప్రతిస్పందనలను దాదాపు అనుసరించవు (సగటు ర్యాంక్ సహసంబంధం 0.18, −0.70 నుంచి 0.84 వరకు).
తిరిగి రావడం బలవంతం. 1,024 లో 914 జతల్లో, స్తంభింపజేసిన రెండు ప్రోగ్రామ్లకు మొత్తం 225 సాధ్యమైన పరిస్థితులనూ లాగే ఒకే ఆకర్షకం (attractor) ఉంటుంది. అవి ఎక్కడి నుంచైనా, ఏ అంతరాయం తర్వాతైనా, ఏ కారణంతోనైనా తమ సాధారణ ధరలకు తిరిగి వస్తాయి — బంతి గిన్నె అడుగుకు దొర్లి వచ్చినట్లు. యాదృచ్ఛిక పట్టికలు దీన్ని చాలా తక్కువగా చేస్తాయి, కాబట్టి శిక్షణ వేగాన్ని, స్థానాన్ని జోడిస్తుంది; కానీ ఎంపికను మాత్రం కాదు.
ఇది రూపం యొక్క పరిమితి కాదు. రచయితలు అదే 225 × 15 పట్టికలో నిజమైన శిక్షా నియమాలను చేతితో నిర్మించారు — ఒకటి క్షమించేది, ఒకటి ఎప్పటికీ మరిచిపోనిది. రెండూ పనిచేస్తాయి. సామర్థ్యం ఉంది; అభ్యసనం దాన్ని వాడలేదు.
జంట పాటించే ఆచారం
తర్వాత, “అపరిచితుడు” పరీక్ష. ఒక ఏజెంట్ను అదే పద్ధతిలో వేరే శిక్షణ నుంచి వచ్చిన, ఎప్పుడూ కలవని ఏజెంట్తో జత చేయండి: కుమ్మక్కు సూచిక 0.669 నుంచి 0.134 కి పడిపోతుంది — 80% పతనం, 7.4% జతల్లో ధరలు పోటీ స్థాయి కంటే కిందికి వెళ్తాయి. ఒకే ధర వద్ద స్థిరపడిన జతలు కూడా విడిపోతాయి. “ఈ వాతావరణంలో కుమ్మక్కు ఒక ఏజెంట్ దగ్గర ఉండే వ్యూహం కాదు; అది ఒక జంట పాటించే ఆచారం.”
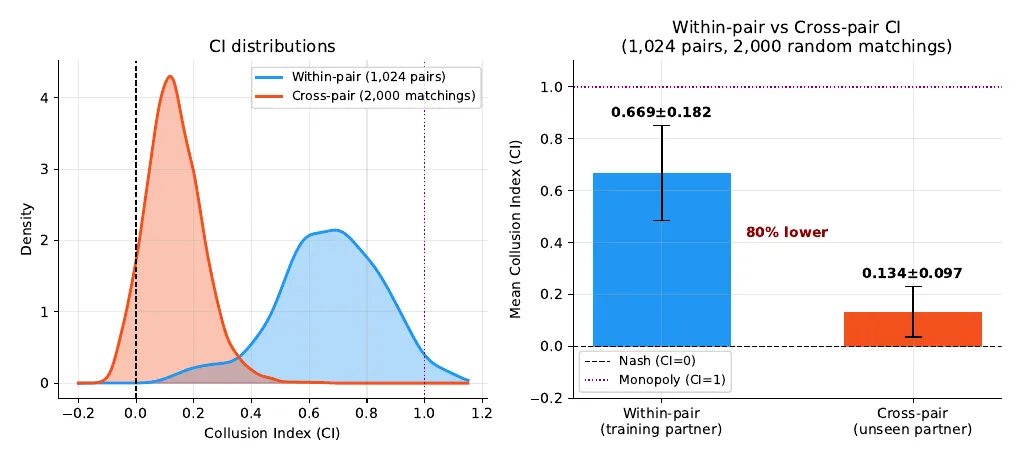
శిక్షణ భాగస్వామితో (నీలం), ఎప్పుడూ చూడని భాగస్వామితో (నారింజ) కుమ్మక్కు సూచిక: 0.669 వర్సెస్ 0.134. — Figure 7, Lopes de Moraes and De Losso (2026), arXiv:2610.21867.
ఎవరూ ప్రయత్నించని విచలనం
రచయితలు కాల్వానో సొంత తనిఖీని ధృవీకరిస్తారు: ఒక వ్యవధి ధర తగ్గింపు 92% జతల్లో లాభించదు. కానీ అది అమాయకమైన విచలనం. స్తంభింపజేసిన ప్రతి భాగస్వామికి వ్యతిరేకంగా సాధ్యమైన ఉత్తమ వ్యూహాన్ని ఖచ్చితమైన డైనమిక్ ప్రోగ్రామింగ్తో లెక్కిస్తే, సగటున 17.5% ఎక్కువ లాభం వస్తుంది (93.7% వరకు). 2,048 ఏజెంట్లలో కేవలం 124 మాత్రమే ఇప్పటికే తమ ఉత్తమ ప్రతిస్పందనను ఆడుతున్నాయి. “ఈ పథకం ఏ ఆప్టిమైజర్ ఎంచుకోని విచలనాన్ని మాత్రమే నిరోధిస్తుంది.”
ఎందుకు? శిక్షణ సమయంలో అన్వేషణ తగ్గుతున్న కొద్దీ, ప్రతి జత పరిస్థితుల ఇరుకైన కారిడార్ను మాత్రమే సందర్శిస్తుంది. పట్టికల్లో మిగతాదంతా ఆచరణలో శిక్షణ లేకుండానే ఉంటుంది. రచయితలు ఈ ఫలితాన్ని స్వీయ-ధృవీకరణ సమతుల్యత (self-confirming equilibrium) అని పిలుస్తారు — నడిచిన దారిలో సరైనవి, దాని బయట ఎప్పుడూ పరీక్షించని నమ్మకాలు. ధరల గ్రిడ్ను 15 నుంచి 200 స్థాయిలకు సూక్ష్మం చేస్తే, అదే శిక్షణ మరిన్ని పరిస్థితులపై వ్యాపిస్తుంది, కుమ్మక్కు సూచిక 0.64 నుంచి 0.23 కి తగ్గుతుంది, ఈ చిత్రం అంచనా వేసినట్లే. కాల్వానో ఆపే నియమానికి సరిగ్గా అనుగుణంగా శిక్షణ ఇచ్చిన 5 జతలతో, ప్రతి ఫలితమూ నిలుస్తుంది, లాభదాయక విచలనం 10.4% కి కుంచించుకుపోతుంది.
ధరలు ఇంకా ఎక్కువే, చికిత్స వేరు
వినియోగదారుల సమస్య పోదు: ధరలు పోటీ కంటే చాలా ఎక్కువగానే ఉంటాయి. మారేది నిర్ధారణ. షరతులతో కూడిన బెదిరింపు లేనందున, ఈ జతలు ఒప్పందం లాంటి చట్టపరమైన వర్గాలకు సరిగ్గా సరిపోవని రచయితలు వాదిస్తారు — జతలను కలవరపరచడం (కొత్త ప్రవేశకుడు, మార్పిడి, పునఃశిక్షణ) స్తంభింపజేసిన ప్రోగ్రామ్ల సమన్వయాన్ని నాశనం చేస్తుందని కూడా. ఏ ధరల వ్యవస్థకైనా వినియోగంలోకి తెచ్చే ముందు ప్రమాణంగా వారు తమ పరీక్షలను ప్రతిపాదిస్తారు. వారి వాదనలు ఈ ఒక్క మార్కెట్లోని పట్టిక రూప Q-learning కే వర్తిస్తాయి; డీప్ లెర్నింగ్ ఏజెంట్లు నిజమైన బెదిరింపులను నేర్చుకుంటాయా అనేది వారి పద్ధతి ఊహించడానికి కాదు, జవాబు ఇవ్వడానికి నిర్మించిన ప్రశ్న.